

点击上方蓝字关注我,加个🌟标不迷路。
大家好,我是 cxuan。
DeepSeek-V4-Flash 的一经发布属实非常炸裂了,发布完了之后 1 - 4 个小时,明显 DeepSeek 的响应速度变得很慢了,我估计大家都在接入 API 测试,不过也难怪,DeepSeek-V4-Flash 正式版把 DeepSeek-V4-Pro Preview 都给秒了,Agent 能力大幅增强,香的一批,还要什么自行车。
不过 DeepSeek 除了可以接入 API ,根据 Unsloth AI 的消息,本地也可以跑 DeepSeek-V4-Flash 了。
284B 总参数、13B 激活参数、1M 上下文的 DeepSeek-V4-Flash-0731,现在已经有 GGUF 版本,可以通过 Unsloth Studio 或 llama.cpp 跑在自己的机器上。
图源:Unsloth AI
是不是听着很爽?
但我把官方配置看了一遍,发现这里的本地跟很多人想的有点区别。。。最低 92GB 总内存,想跑一个比较靠谱的版本,建议从 110GB 起步。。。。
32GB、64GB 的普通电脑咱就先不折腾了。
先来信息平权一下,根据 DeepSeek-V4-Flash 的正式版消息的公布,Agent 能力要比 Preview 提升很多。
官方给出了 9 项 Agent 基准测试中,它把它的前身 Flash Preview 给秒了,也把参数更大的 V4-Pro Preview 给秒了。比如 Terminal Bench 2.1 从 61.8 涨到了 82.7,DeepSWE 从 7.3 涨到了 54.4。
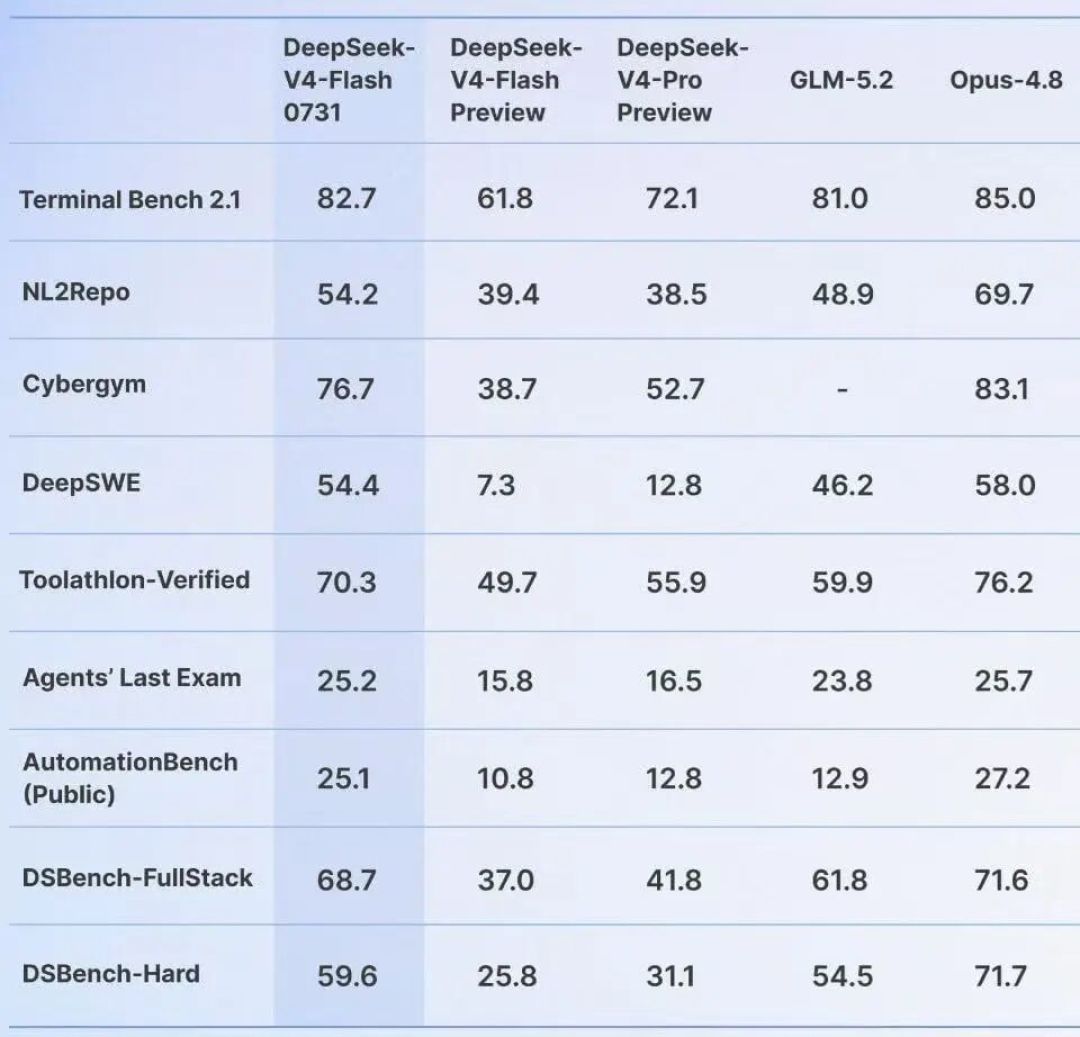 DeepSeek-V4-Flash-0731 与 Preview、V4-Pro Preview 的基准对比
图源:DeepSeek 官方
更多关于 DeepSeek 测评的内容,可以查看查看这篇文章。
DeepSeek-V4-Flash 正式版来了!这次提升有点夸张。
DeepSeek-V4-Flash-0731 有很多量化版本,不过其实只需要记住一件事就行了:位数越低,占用越小,质量损失也越明显。
量化版本建议总内存怎么选1-bit92GB能跑,适合尝鲜2-bit102GB还是不太行UD-IQ3_XXS110~135GB128GB 机器优先选它UD-Q4_K_XL162GB约 155GB,接近无损UD-Q8_K_XL169GB约 162GB,官方无损版
这里的总内存,是系统 RAM 加显存,或者 Mac 的统一内存。
这里有个坑:文件只有 103GB,不代表 103GB 内存就能跑。
模型加载之后,KV Cache、上下文和系统还得继续占内存。官方给的底线是 110GB,不过大家统一按 128GB 来算比较省事。
还有一个容易出错的地方。
Unsloth 的原帖把 4-bit 写成了 lossless,当前文档已经标得更清楚:UD-Q4_K_XL 是 near-lossless,真正无损的是 UD-Q8_K_XL。两者只差 7GB。
所以
128GB 机器,选 UD-IQ3_XXS。192GB 或 256GB 机器,直接上 UD-Q8_K_XL。只有 64GB,先用 API,或者等更小的量化版本。
图源:Unsloth;越靠右下,模型越接近官方原始权重
省事儿的做法:Unsloth Studio
不想碰一堆编译参数,那你可以直接装 Unsloth Studio。
Mac、Linux 和 WSL 打开终端:
curl -fsSL https://unsloth.ai/install.sh | shunsloth studio -p 8888
Windows 用 PowerShell:
irm https://unsloth.ai/install.ps1 | iexunsloth studio -p 8888
然后在浏览器打开:
http://127.0.0.1:8888
第一次启动会让你创建密码。进入 Model hub,搜索 DeepSeek-V4-Flash-0731-GGUF,再按自己的内存选择量化版本,点 Download。
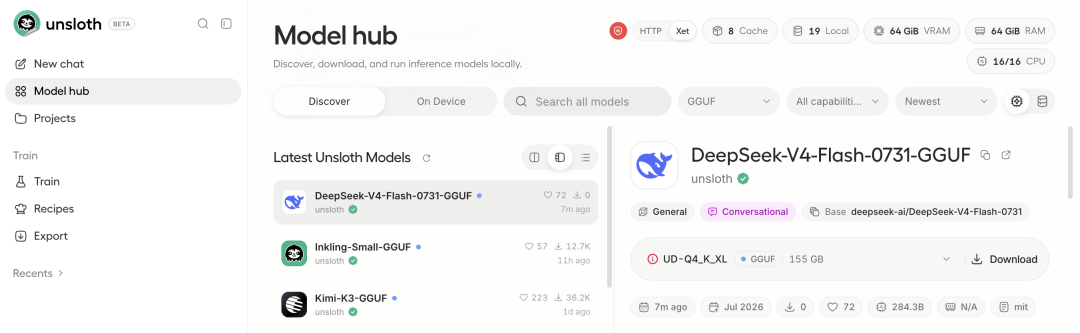 在 Unsloth Studio 里搜索并下载 DeepSeek-V4-Flash-0731-GGUF
图源:Unsloth;截图里的机器是 64GB 显存加 64GB 内存,155GB 的 Q4 版本已经超出容量
下载量在 100GB 到 162GB 之间,建议提前留足硬盘空间。
下载完成后直接开始,Studio 会自动带上聊天模板和大部分推理参数,右下角还能切换思考强度, Non-think、Think High 和 Think Max。
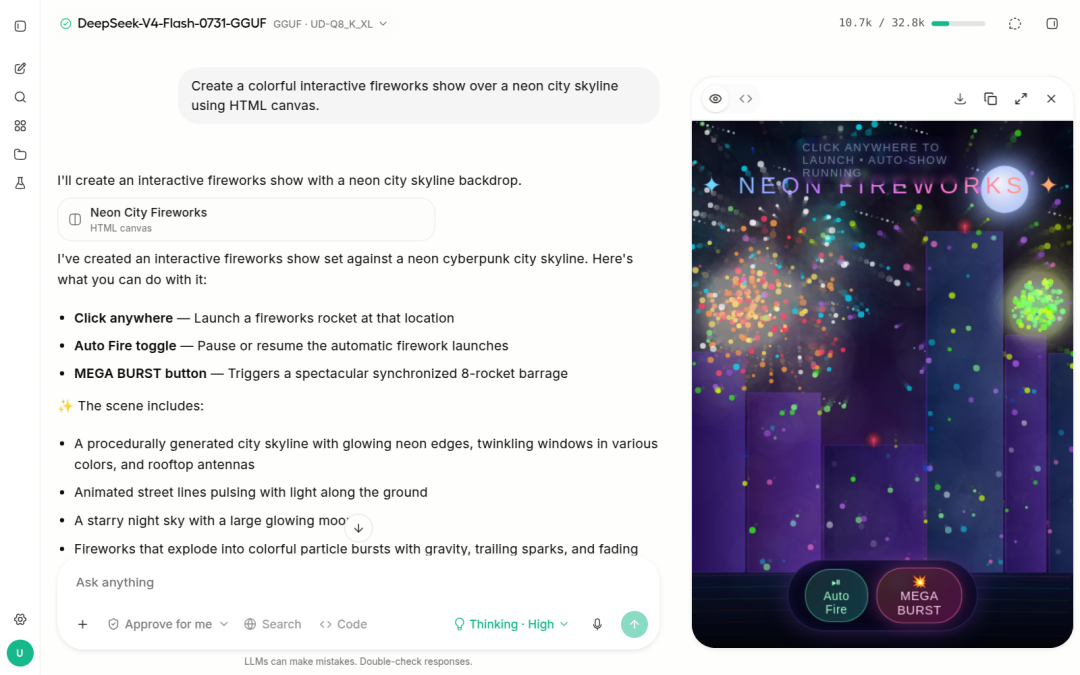 DeepSeek-V4-Flash-0731 在 Unsloth Studio 中生成交互网页
图源:Unsloth
如果只在本机使用,启动命令里不用加 -H 0.0.0.0。这个参数会让同一网络里的其他设备也能访问,家里内网还能接受,公网别这么搞。
如果想接自己的工具,就用 llama.cpp
已经在用 llama.cpp 的人,先保证版本是最新的,然后直接从 Hugging Face 拉模型就可以了。
128GB 机器可以从 3-bit 开始:
./llama.cpp/llama-cli -hf unsloth/DeepSeek-V4-Flash-0731-GGUF:UD-IQ3_XXS --temp 1.0 --top-p 1.0 --min-p 0.0 --ctx-size 32768
内存够,想跑官方无损版,把模型名换掉:
unsloth/DeepSeek-V4-Flash-0731-GGUF:UD-Q8_K_XL
如果下载老卡住,可以先装 huggingface_hub,手动把 3-bit 文件下到本地:
hf download unsloth/DeepSeek-V4-Flash-0731-GGUF --local-dir unsloth/DeepSeek-V4-Flash-0731-GGUF --include "*UD-IQ3_XXS*"
建议第一次只开 32K 上下文,确认模型、速度和内存都正常,再往上加上下文。
它虽然支持 1M 上下文,但上下文越长,额外占用越大。
Unsloth 给的常规推荐参数如下:
temperature = 1.0top_p = 1.0min_p = 0.0context = 32768 起步
如果拿它跑 Agent 或代码任务,把 top_p 改成 0.95。
Think High 默认开启,日常复杂任务先用它。Think Max 需要至少 384K 上下文,内存和等待时间都会继续往上走,适合真有难题时再开。普通问答可以切到 Non-think,速度更快。
关闭思考模式的命令是:
--chat-template-kwargs '{"enable_thinking":false}'
需要 Think Max:
--chat-template-kwargs '{"reasoning_effort":"max"}'
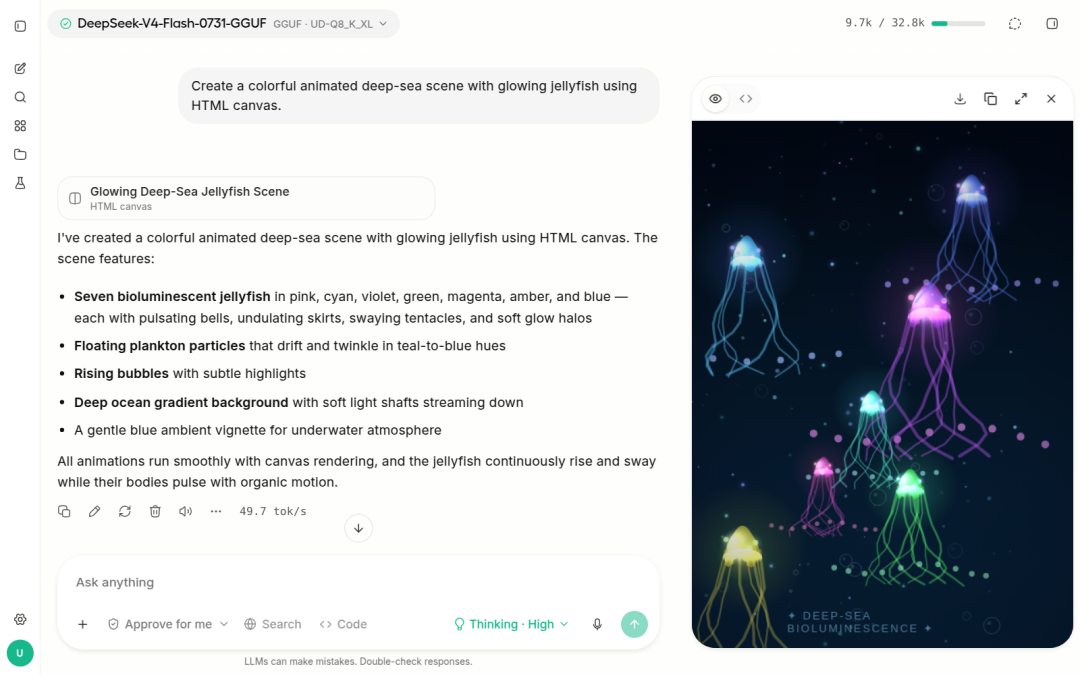 DeepSeek-V4-Flash-0731 在本地生成动态水母网页
图源:Unsloth;官方示例中速度为 49.7 tok/s,具体速度取决于硬件和量化版本
所以本地跑 DeepSeek-V4-Flash 这件事确实能行。只是这个本地,暂时只能工作站和大内存 Mac 的本地才能跑起来。。。
像我这种 32G 丐版内存的 Mac ,再等等不知道能不能等到了。。。
如果这篇文章你觉得还不错,谢谢你的三连,也希望可以转发给同样关注 AI / 科技 / 开发效率的朋友。 我是 cxuan,我们下期再见。
参考资料:
Unsloth:DeepSeek-V4 本地运行指南DeepSeek-V4-Flash-0731 GGUFUnsloth AI 原帖
当前文章无评论,是时候发表评论了