
这一个多星期,本地推理圈的火药味淡了,“白嫖味"浓了:B 站有人拿 20 年前的老笔记本跑本地大模型,知乎有人把 15 亿参数的模型塞进浏览器批量处理 Excel,同一周还有人写教程把吃灰的安卓手机变成一台 OpenAI 兼容的推理服务器,紧接着 10 月 2 日,连"一块多一小时"的云端部署教程都上新了。你会发现,这轮讨论的关键词已经不是"8G 显存能不能跑 27B”,而是:不动一分钱硬件,我手上这台旧机器,上限到底在哪?哔哩哔哩知乎知乎
先给结论:免费路已经摸到了"够用"的门槛,但每条路的天花板都钉死在两个数字上——内存/显存带宽,和电费。下面按"你手上是什么机器"来对号入座。
一、AMD 核显小主机/笔记本:这是免费路里唯一能"干活"的一档
如果你有一台 7840HS/7940HS 这类 780M 核显、32G 内存的机器(很多打游戏退役的迷你主机就是这个配置),B 站 UP 主 kingzeron 在 6 月初给出的方案到现在还是核显党的标杆:Linux 下把核显显存上限拉到 28G,跑 Qwen3.6-35B-A3B 的 Q4 量化,开 256K 上下文,实测输出 25 tokens/s——这个数字已经超过了大多数人的阅读速度。哔哩哔哩
评论区比视频更值钱,三个月下来把坑踩全了:
Windows 下最多只能分一半内存给显存,Linux 才能突破。有人 Win11 分 17G 共享显存跑 Q4,“开始有 20-25t,后面会降到 12t”,换 Q3 量化才稳住 18-22t,但上下文只能开到 68K。哔哩哔哩
笔记本党(8845HS)反馈散热拖了后腿,全 GPU 加载"只能到 24 tokens/s 左右"。
倒是 7840HS+96G 内存的老哥说,35B 拉满上下文跑长文本,速度不会明显掉。
天花板在哪?评论区吵得最凶的一条其实给出了答案:DDR5 内存带宽 100GB/s 上下,对比 RTX4060 的 288GB/s 就是先天残疾——所有"统一内存"路线,包括 128G 大内存的核显机和迷你 AI 工作站,速度都会封顶在几十 token 每秒。这不是软件能修的,是物理。哔哩哔哩
另一条账是电费。评论老哥给的口径:780M 小主机性能模式峰值 60W,常年开机一个月电费不到三十块;而另一边 E5+P100 的"垃圾佬神机"跑 20-30t/s 看着香,满载接近 500W,“月用电算 250 度,电费就要 150 元”,他的结论就四个字——性价比不高。哔哩哔哩哔哩哔哩文游党则给出了另一个生态位:通用模型文风"不是太油腻,就是太 coding",“本地化中小型模型,是可以拉去做微调对齐训练的”。加上"文件不能上云"的合规刚需,这三类需求,25t/s 都接得住。小红书
二、浏览器:0 安装、0 下载、数据全程不出电脑
知乎用户 Kainy 9 月 23 日的实践帖适合完全不想折腾命令行的人:MLC 团队的 WebLLM 让模型直接跑在浏览器里,靠的是 WebGPU——Chrome 113 之后的浏览器自带的能力,普通核显就行。默认跑 Qwen2.5 的 1.5B 版本,量化后权重约 1G,首次下载进缓存之后,“哪怕你拔了网线,它照样能干活”。他做的场景很具体:1000 行客户反馈的 Excel 情感标注,数据一个字都不用贴给公网 AI——对"公司三令五申不许把内部数据喂给在线大模型"的打工人,这个卖点比速度值钱。知乎
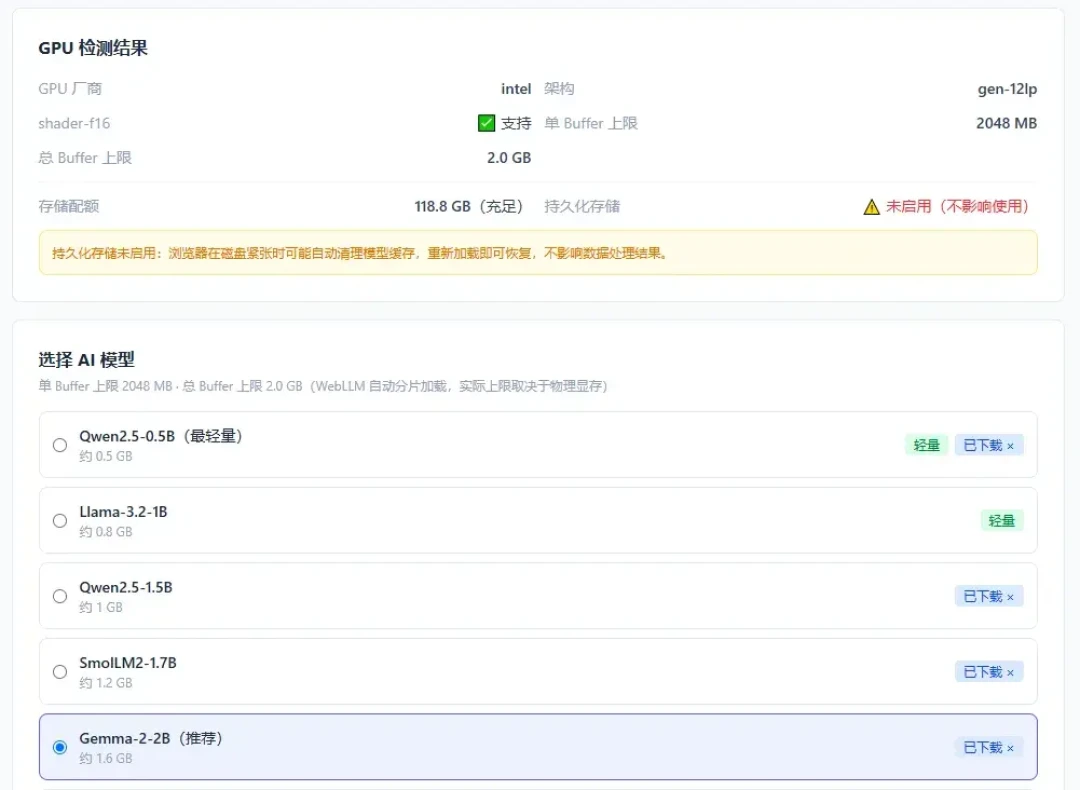
两个提醒:想上 8B 级(Llama-3-8B),作者自己标注了"需要高性能独立显卡,别为难你的核显"。浏览器后台会对标签页节流甚至直接查杀,长任务要靠静音音频保活、IndexedDB 断点续传这类工程手段压住——自己搭的话,光这些坑就要掉一把头发。知乎

三、吃灰安卓手机:现在只值"关注",不值"上手"
同一周还有个小火苗:OlliteRT 可以把安卓手机变成一台 OpenAI 兼容的本地推理服务器,完全本地、开源。不过 9 月 30 日的教程帖互动还很小(赞同 1、收藏 1),手机 SoC 的带宽和发热决定了它现阶段是"极客盆景"。可以装,别指望它干活。知乎

四、20 年前的老电脑:能跑,但请把它当温度计
B 站 10 月 1 日那条老神州笔记本视频播放只有 177,机主在评论区留下的反而是这轮最清醒的自我校准:“别用单一参数估需求,还是得实测说话”,那台 4G 内存的机器"实际体验下来能有 16t/s"。老机器党适合干的事和核显党一样:长文翻译、批量摘要这种"丢进去不用管"的活。哔哩哔哩
想拿它跑 Agent 多轮对话的,劝退——评论区另一条话说得准:“短时峰值好看,持续跑才知道热不热”。这两周"本地 AI 跑 40 轮就崩"的翻车帖,也不止一篇。哔哩哔哩
五、云端一块钱:最接近"免费",也最容易被忽略两个成本
10 月 2 日的 autodl 教程给了第五条路:不用买 GPU,“每小时只要一块多钱,就能轻松部署开源 AI”,租 RTX3080、一键拉取千问、SSH 端口映射接到本机,还能挂 Claude Code。零硬件投入拿到独显速度,看着完胜前面四条。哔哩哔哩
但评论区的反驳同样真实:一小时一块钱,这价格够在 OpenAI 和 Anthropic 两家大鱼大肉了。两个隐藏成本:第一,你的数据照样出门,“本地推理"最大的卖点在这条路上直接归零;第二,按时计费意味着只有"用的时候才便宜”,长任务、挂机任务的账单会教你做人。哔哩哔哩
把五条路摊在同一张桌上
路线 | 你需要的东西 | 实测档位(社区口径) | 数据在哪 | 首次支出 | 最适合 |
|---|---|---|---|---|---|
核显小主机 | 780M/8845HS+32G 内存 | 35B-A3B Q4,18-25t/s,68K-256K 上下文 | 本机 | 0 元(已持有则) | 长文翻译/挂机任务/文游微调 |
浏览器 WebGPU | Chrome 113+ 办公本 | 1.5B,核显可跑,断网可用 | 本机 | 0 元 | 敏感数据批处理(Excel/文档) |
安卓手机 | OlliteRT | 极小模型,性能未验证 | 本机 | 0 元 | 观望/玩 |
20 年老电脑 | 4G 内存古董机 | 小模型 16t/s 峰值 | 本机 | 0 元 | 验证好奇心 |
云端 GPU | autodl 账号 | 3080 级独显速度 | 云端 | 1 元+/小时 | 偶尔需要独显速度、不碰敏感数据 |
顺带一提旧独显党:8G 显存的 30 系卡这两周也没闲着,FreeToken 把 MoE 的高频专家缓存进显存、低频的丢给内存就地算,“8G 显存就能跑 35B 大模型,还飙到 40TPS”,接口兼容 OpenAI/Anthropic;MeshLLM 则把家里多台旧电脑连成分布式算力池,放不下的超大模型按层拆分跑。你们不在"免费路"的弃子名单里。哔哩哔哩哔哩哔哩
什么时候该掏钱,什么时候再等等
看完五条路,掏钱的判断线其实清楚了:
现在就可以掏的:你已经在核显机上试过 256K 上下文,撞到了 prefill 的墙——本地长文档"读得慢"比"吐得慢"更早劝退人。评论区 4070TiS 用户的配置单是这条线的参照:Qwen3.8-27B、IQ3_S、KV Q8、48K 上下文,llama.cpp 报 prefill 1100t/s、decode 55-60t/s,他的原话是"本地干活(有固定工作流跑通的)和 workbuddy 一样快"。从"玩具"到"干活"的分界线就是 prefill,独显带宽买的正是这个。小红书
再等等的:①被"旧机器跑 744B"这类视频点燃、想加硬盘再战的——两个月前那轮"低门槛"消息的教训还在;②刚下单或正纠结大内存迷你主机的——极摩客 EVO-X2 这类锐龙 AI Max+395 新机 10 月 2 日刚出"跑 235B"的实机视频,首批价格还没稳住,别在发布会情绪里签合同。③新一轮模型和引擎正密集进场——Spark-X2.5-4B 用混合注意力和 KV 拆分把内存砍到九分之一、在 4B 模型上做到 1M token 上下文;Strata 这类专为新模型写的新引擎,上周刚让 3090 跑 Flash-Next 的短问答从 20t/s 干到 67t/s。引擎和模型的迭代速度现在比硬件降价快,旧机器先跑起来的人,永远比囤好机器等模型的人少亏一轮。哔哩哔哩哔哩哔哩微博
这轮"免费本地推理"最值得抄的作业其实就一句话:这个周末,用你已经拥有的机器把一篇长文翻译跑完整,再决定要不要为速度花钱。评论区那句反讽留着给冲动的人——“硬件比买来的时候涨了 20% 了,这么算还是省钱”。但那终究是理财,不是推理。小红书












