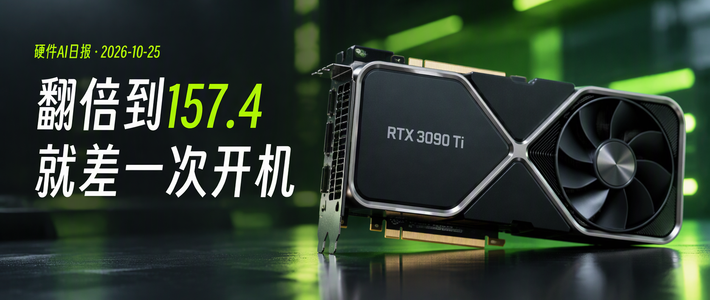
这两天本地大模型圈被一个补丁刷屏了:gpu-unlock,标题一个比一个猛——“解锁30系半速算力、直接翻倍”。但真把3090 Ti按在机房里实测的人泼回了冷水:解锁的是矩阵算力,卡住你模型的大概率是显存带宽。哔哩哔哩哔哩哔哩哔哩哔哩
一、锁的是什么?怎么解的?
英伟达多年把30系的FP16/BF16矩阵吞吐限成专业卡的"半速"。gpu-unlock是个开源Linux内核模块,在驱动加载前把锁解开了,BF16从87.5涨到157。另一组机房实测里,矩阵乘从80涨到126 TFLOPS。所谓"翻倍",涨的只有这一项原始算力——显存容量、带宽、位宽一个没变。哔哩哔哩哔哩哔哩
装法算干净:装成DKMS开机自动生效,断电即清、不刷BIOS、不改硬件。门槛也硬:得先换成Linux原生,虚拟机都不认。目前实测集中在30系,40系虽有"另一个项目"的说法,还没跑出广泛结论。哔哩哔哩哔哩哔哩
二、谁真变快了?
吃到肉的,是跑FP16原始精度的活:生图23.5秒→14.1秒、快67%,同种子逐像素相减差值为0,视频快52%、做歌快56%。3080 Ti也证实了同样的方向:矩阵基准+17.5%,但预填充和连续吐字走出了截然相反的两条曲线。哔哩哔哩哔哩哔哩
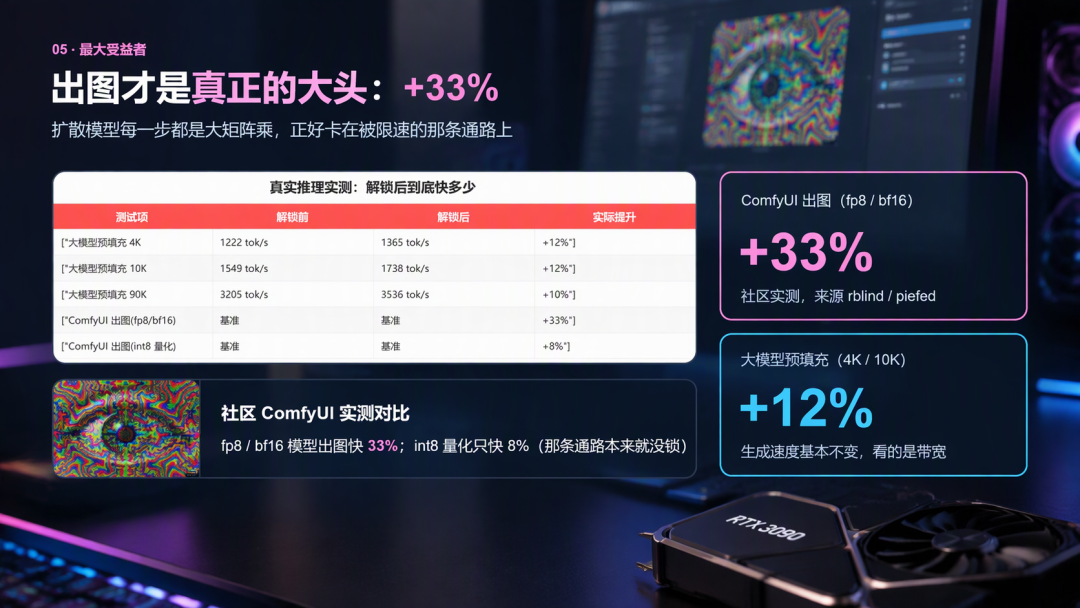
看戏的,恰恰是本地大模型的主流玩法:W4A16量化+12~17%、小赚一笔,W4A8纹丝不动——看的是计算格式,不是模型名字。多数GGUF(Q4这类)走INT8/INT4路径,基本白干,瓶颈本来就卡在带宽,FP16解锁轮不到它。更扎心的是131K超长上下文首字快了7.4%,连续吐字反而从57.5掉到52.2 token/s。日常聊天是什么体验?没体验。哔哩哔哩哔哩哔哩哔哩哔哩哔哩哔哩
三、要不要连夜装?
评论区高赞共识就一句:白给的一点提升不亏,但别为它专门装机。适合你:闲着一张30系、跑Linux、日常FP16生图/训练/长文档,白捡的加速装就完了;不适合你:Windows加ollama跑GGUF聊天,装了只是获得"我折腾过"的心理安慰。真要装:动手前核对型号、内核并准备回滚。塔式机箱双卡注意上面那张过热降频,对比数据前记得把功耗对齐。哔哩哔哩哔哩哔哩哔哩哔哩
这个补丁的本质一句话就能说清:它不是给你新算力,只是让30系干回它本该干的活。先看清自己的模型跑在哪个量化格式上,再决定是狂喜还是看戏。