这两年谁想在自己机房里跑大模型,都会被同一件事逼疯:显存。
一个70B模型,FP16权重就是140GB,再加上长上下文的KV缓存、并发批次,96GB显存的卡瞬间捉襟见肘。怎么办?要么把模型切碎塞进多张卡,通信开销暴涨;要么激进量化,效果打折;要么让用户排队。每条路都在烧钱。知乎
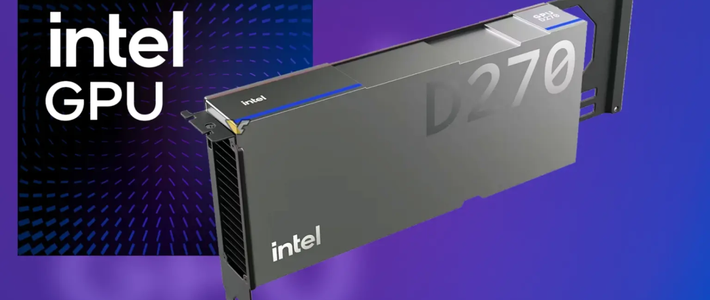
10月中旬的OCP全球峰会上,英特尔甩出一张对着这个痛点打的卡:GPU D270。知乎知乎
先看参数:
最高480GB LPDDR5X显存,带宽1.5TB/s
FP8算力1.3 PFLOPS,32个Xe3P核心、256个XMX矩阵引擎
整卡功耗仅350W,标准PCIe 5.0接口,风冷、支持被动散热
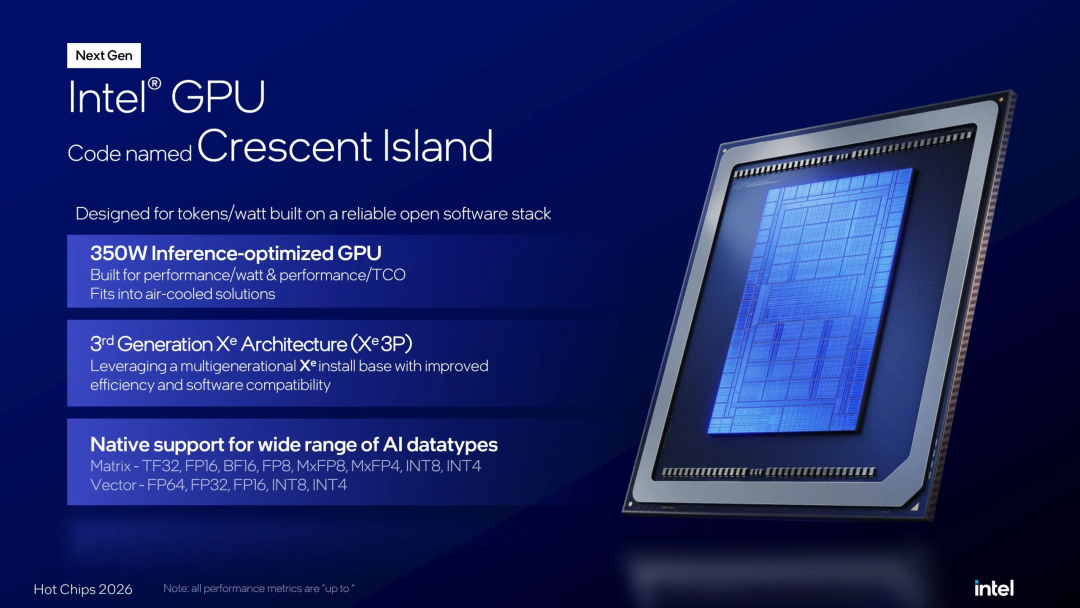
三行参数,三个意思。
第一,大模型可以整卡装了。480GB意味着3000亿参数级的主流开源模型,一张卡直接装下,不做切分、不做激进量化,部署复杂度断崖式下降。英特尔的定位也很直白:专为AI智能体设计。智能体一个任务要跑上千步、上下文动辄十万token,最怕的不是算得慢,是装不下。知乎知乎知乎
第二,350W风冷是故意的"退一步"。现在旗舰AI卡功耗冲到700W甚至更高,液冷成了刚需:机柜改造、供电扩容、运维体系重建。英伟达的Rubin GPU更是每颗需要液冷,功耗以千瓦计。大厂无所谓,但银行、医院、工厂的机房玩不起——不是不想本地部署AI,是机房不具备条件。D270走标准PCIe路线,插进存量风冷机柜就能跑,把这堵看不见的墙拆了。知乎知乎
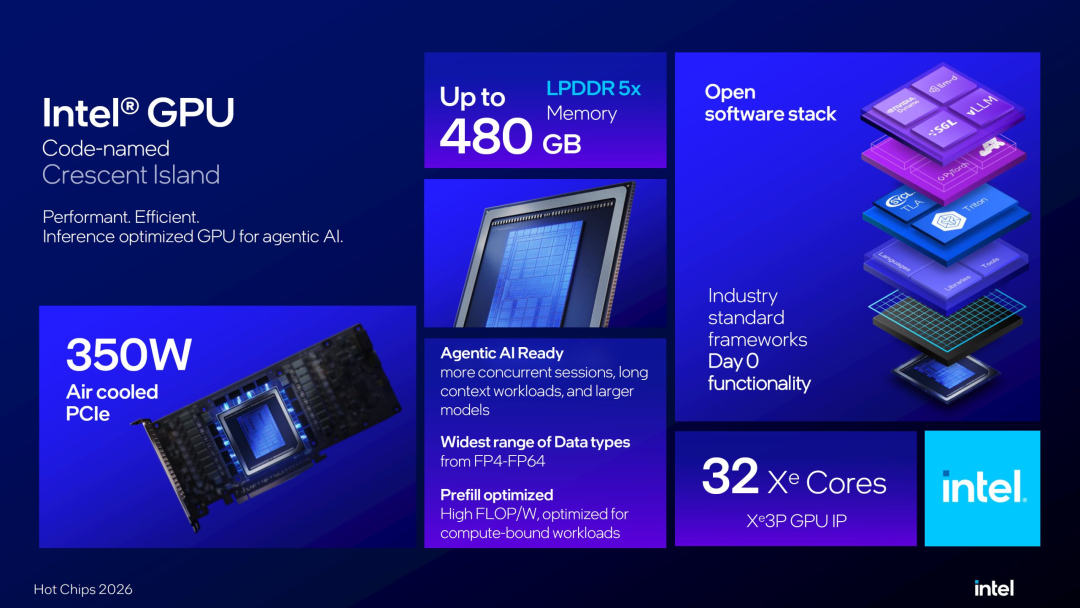
第三,用LPDDR5X不用HBM,是为了省钱。HBM带宽猛但贵、还缺货(还记得英特尔前CEO骂它"丑陋内存"吗)。LPDDR5X的单位容量成本远低于HBM,才堆得出480GB的单卡容量。代价是1.5TB/s的带宽与HBM方案存在代差,高并发大吞吐场景并不占优。知乎知乎
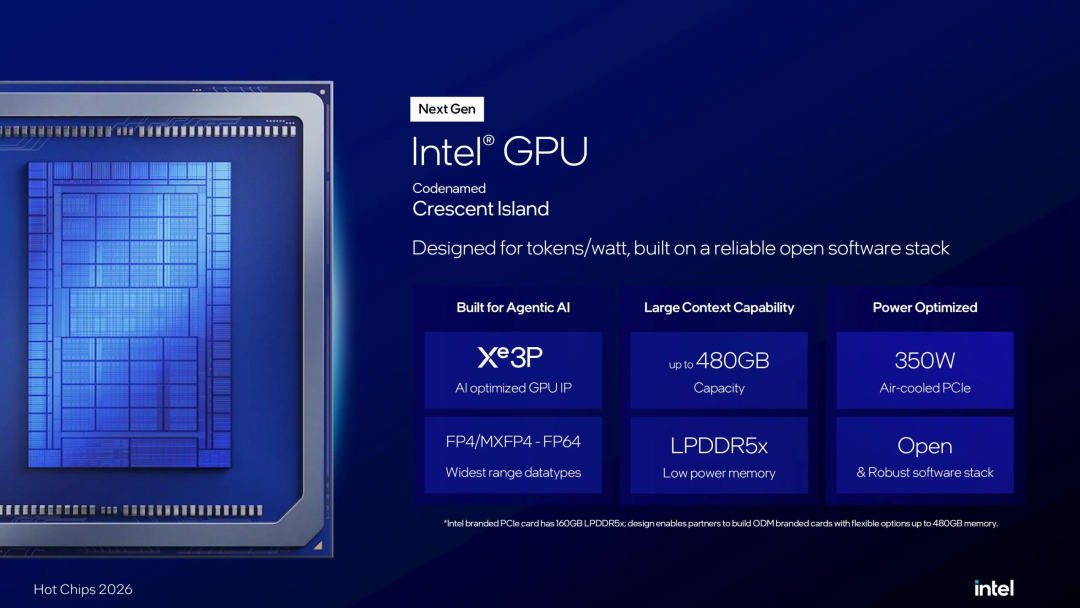
说清楚:这是数据中心卡,可以和符合Open Rack v3规范的Xeon服务器进行整合,整机柜搭配。它不是插你家里电脑上的,价格也还没公布。知乎
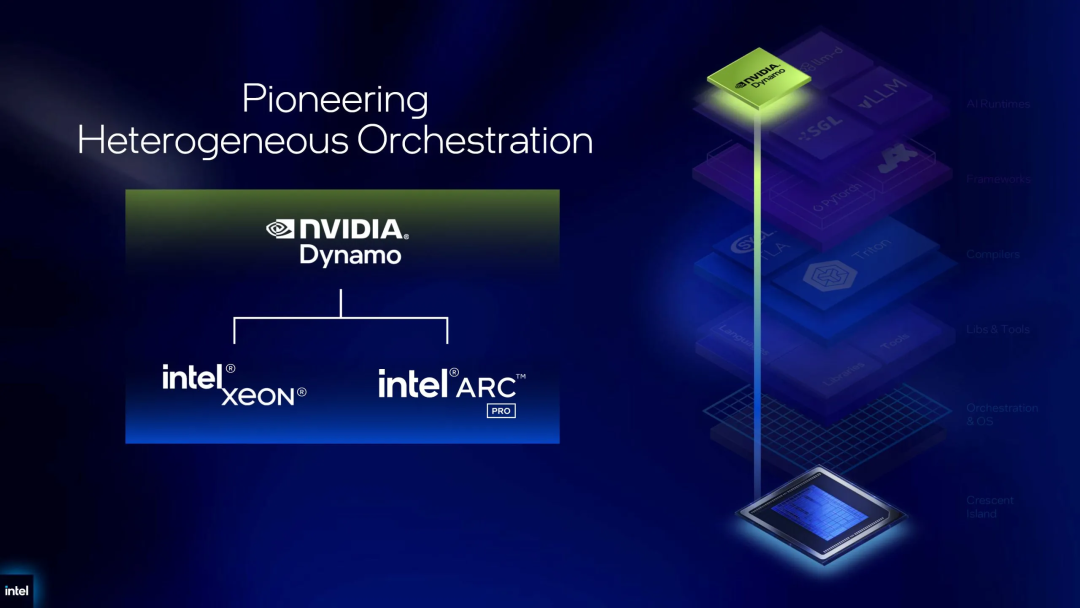
短板同样明显:1.3 PFLOPS的FP8算力,比AMD MI350P的2.3 PFLOPS低了约四成。更要命的是软件生态——CUDA护城河这两年劝退了太多"参数漂亮"的挑战者。英特尔说D270支持vLLM、PyTorch等主流框架,Arc显卡的代码不用重写内核就能移植,但生态跟CUDA的差距,不是一天能填平的。知乎
不过这张卡的信号比产品本身更有意思:AI硬件的竞争重心,正在从"算力优先"转向"显存优先"。造模型的时代拼算力,用模型的时代,拼的是同样的功耗和机柜里能装下多少模型和上下文。英特尔数据中心系统事业部副总裁Nicolas Dubé说得直接:未来AI数据中心的竞争不再仅限单颗GPU效能,而是整座机柜能在既定功耗与延迟限制下,同时支援多少AI代理完成任务。知乎
对数据敏感、必须本地跑AI的企业来说,当一张350W的风冷卡就能在自家机房跑起300B模型,"数据不出域"就从合规口号,变成了经济上算得过账的选项。
英特尔能不能靠推理卡翻身?参数已经给到位了,生态决定生死。你觉得这张卡有戏吗?