10月20日,DeepSeek把自己线上服务用的推理框架DeepInfer开源了。消息一出,本地推理圈应声分成两派:一派高喊"把印钞机开源了",另一派发自肺腑地追问——这跟我手里的4060有什么关系?知乎
先把结论放前面:你现在大概率用不上它,但接下来几个月,你八成会跟着受益。
开源的到底是什么
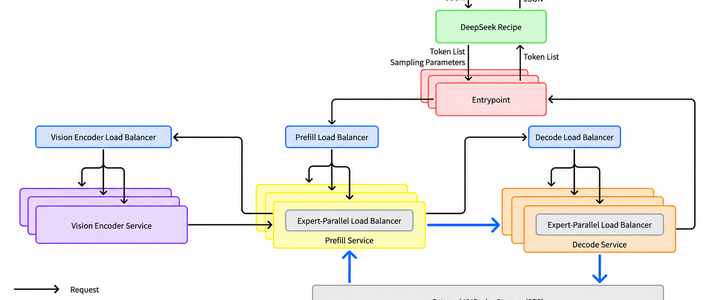
先看README划定的边界:只支持一个模型(DeepSeek-V4.1-Flash),只支持两种硬件(NVIDIA SM100和华为昇腾950),而完整线上服务需要的KV缓存系统、VE/P/D分离部署和跨副本负载均衡,这次统统没带。放出来的是单个引擎实例的离线内核,连那些出名的kernel,9月就已经开源过了。知乎知乎
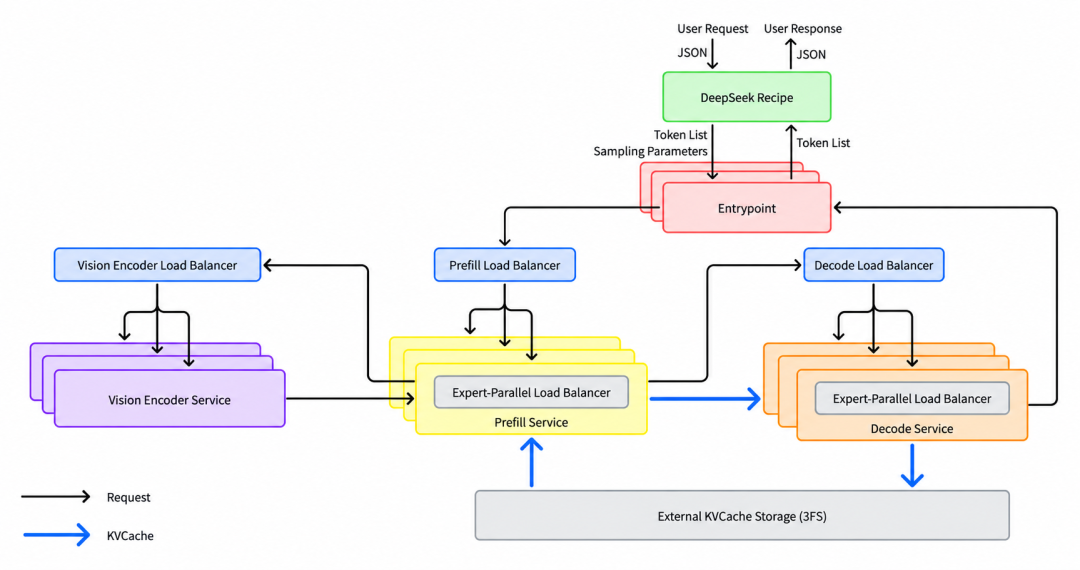
真正的新东西,是一份公开的生产账本:单个集群每天处理约155万亿token,谷电价下整体收入约38美元/GPU·小时;decode用EP64到EP128的专家并行。这规模只在一整柜的卡上成立。知乎知乎
给消费级显卡泼盆冷水
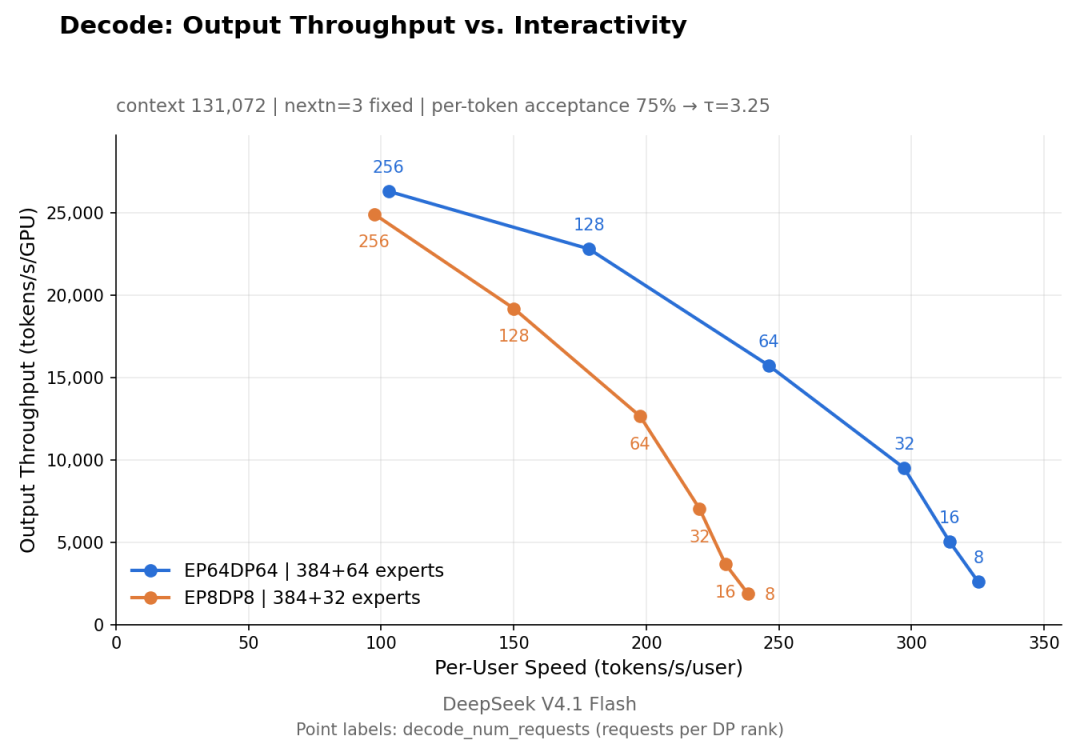
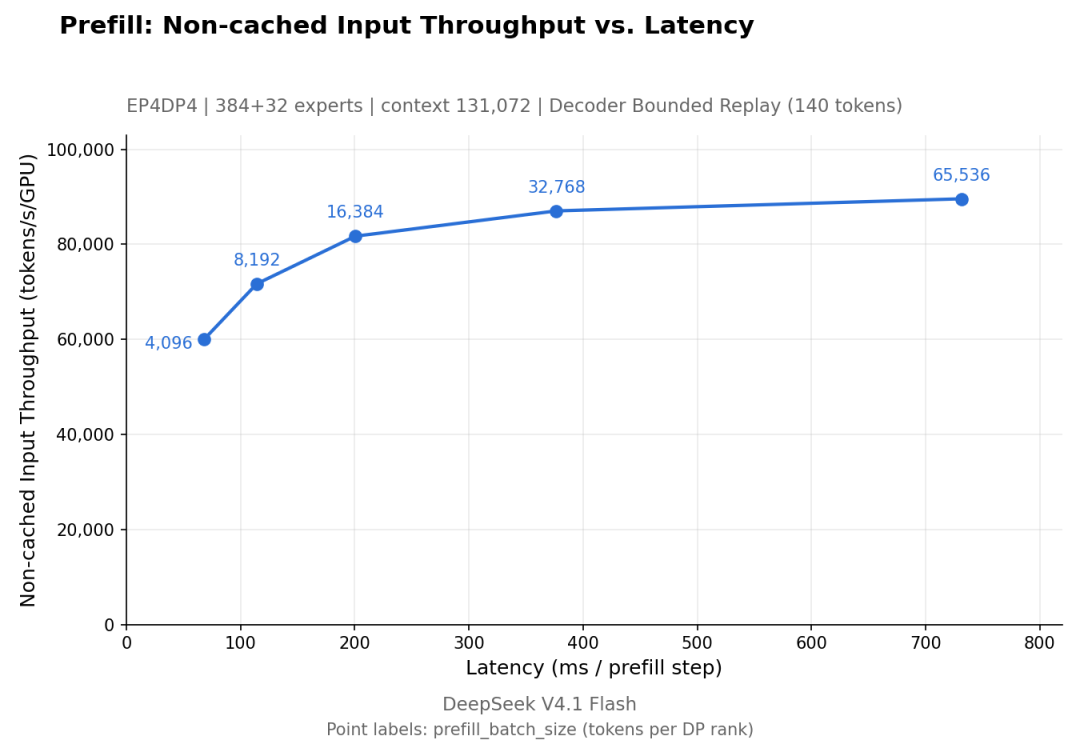
SM100是B200这类Blackwell数据中心卡,昇腾950是华为主力,你的RTX 50(SM120)、40系和Mac,全在门外。官方基准也写得直白:prefill用4张SM100测的,decode用64张。数字再好看,也不打算给你的显卡看。GitHub
有人不信邪,用RTX 5090本地部署V4.1-Flash,踩坑实录的标题就是结果:25 token/s。这才是消费卡今天的现实。哔哩哔哩
社区也不是没试过搬运:仓库开源11天收到211个PR、207个来自外部,Hopper、AMD ROCm、RTX 5090、MLX的移植提案排着队,但到10月27日只合入了2个。这台引擎从出生起就是给一个模型、一种机柜形态定制的,官方短期内没有通用化的意思。知乎
真正接住利好的,是vLLM和SGLang
开源后一周,vLLM和SGLang密集提PR、各自发博客称已追上DeepInfer性能。vLLM的跟进文给出细节:decode吞吐在batch 8–256范围内与DeepInfer差距6%以内,prefill贴合其公开曲线。SGLang的标题更直接——“不止DeepInfer”,并宣称在DeepInfer自家基准上打平甚至反超。知乎vLLM博客LMSYS博客
对本地用户最实在的是格式对齐:SGLang换上官方压缩KV格式后,KV体积减半、attention快约40%、误差还更小。被长上下文逼到显存极限的你,"体积减半"就是真金白银。知乎
所以这次你的行动清单只有一条:等vLLM/SGLang出新版本,升级就行。别急着换框架,别急着攒服务器,更别冲动下单。
DeepInfer这次开源最大的意义,是让所有人第一次看清大规模推理的成本账本:便宜来自模型与系统codesign,不是某个神奇kernel。而账本一旦公开,价格的下限就会继续往下走——API用户和本地用户,双双受益。