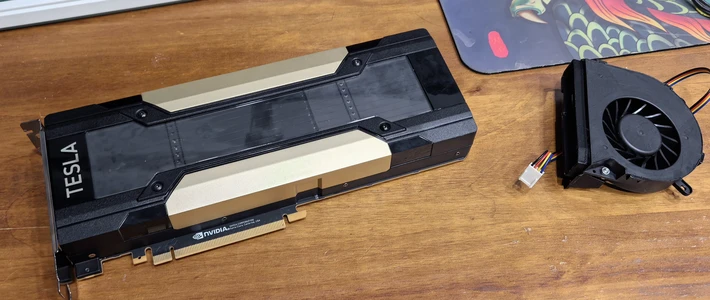
这轮自制系统圈里最活跃的,已经不是刷机、NAS和手搓OS——是把一沓二手数据中心卡塞进机箱,养一只24小时开机的"算力企鹅"。哔哩哔哩
10月2日,小红书一条"神项目Strata来袭!12G显卡轻松跑125B体量Qwen3.8 Flash Next!速度96t/s!"的帖子拿到7667个赞、13759个收藏,把一个叫Strata的开源推理引擎推上了自制圈的热榜。 10月10日到16日,B站像约好了一样,一天冒出几条衍生项目实测;10月15日,GPUStack官方号发了篇《让4500块的V100跑起新模型》。把这事推到台前的,除了引擎,还有价格——5090新卡动辄三四万、二手4090也要一万多,买不起新卡的折腾党,只能回头研究老卡。小红书小红书
先把"真实测"和"标题"分开:这两周有四份可以抄的实作业
我把同时给出配置、量化档位、速度和限制的样本挑了出来:
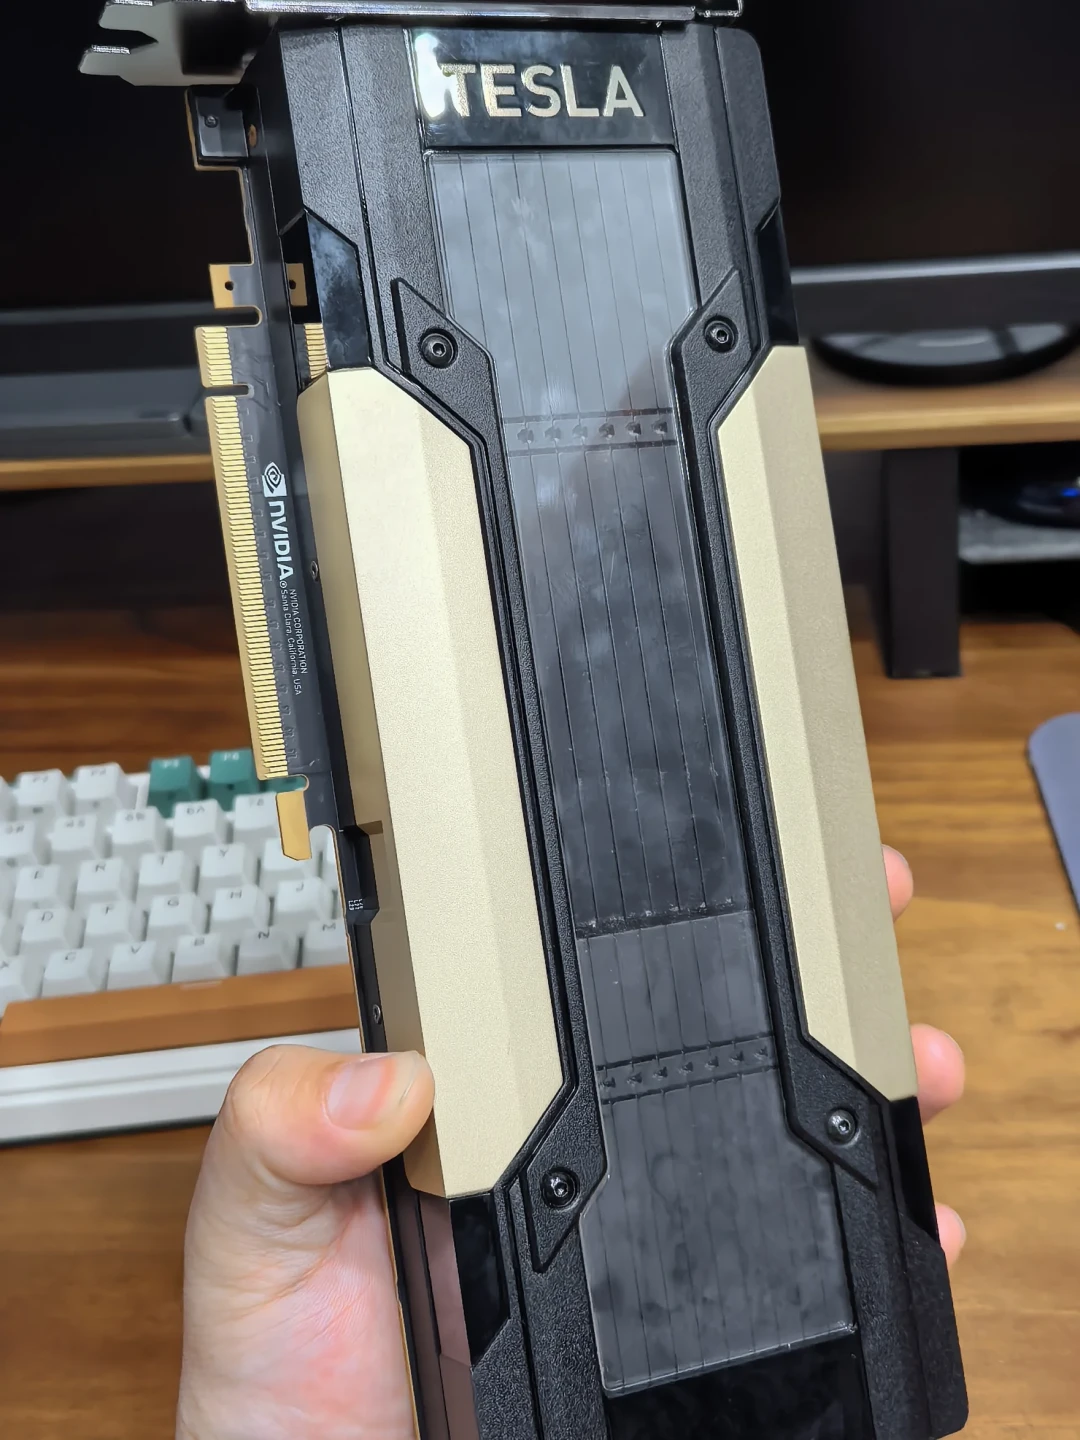
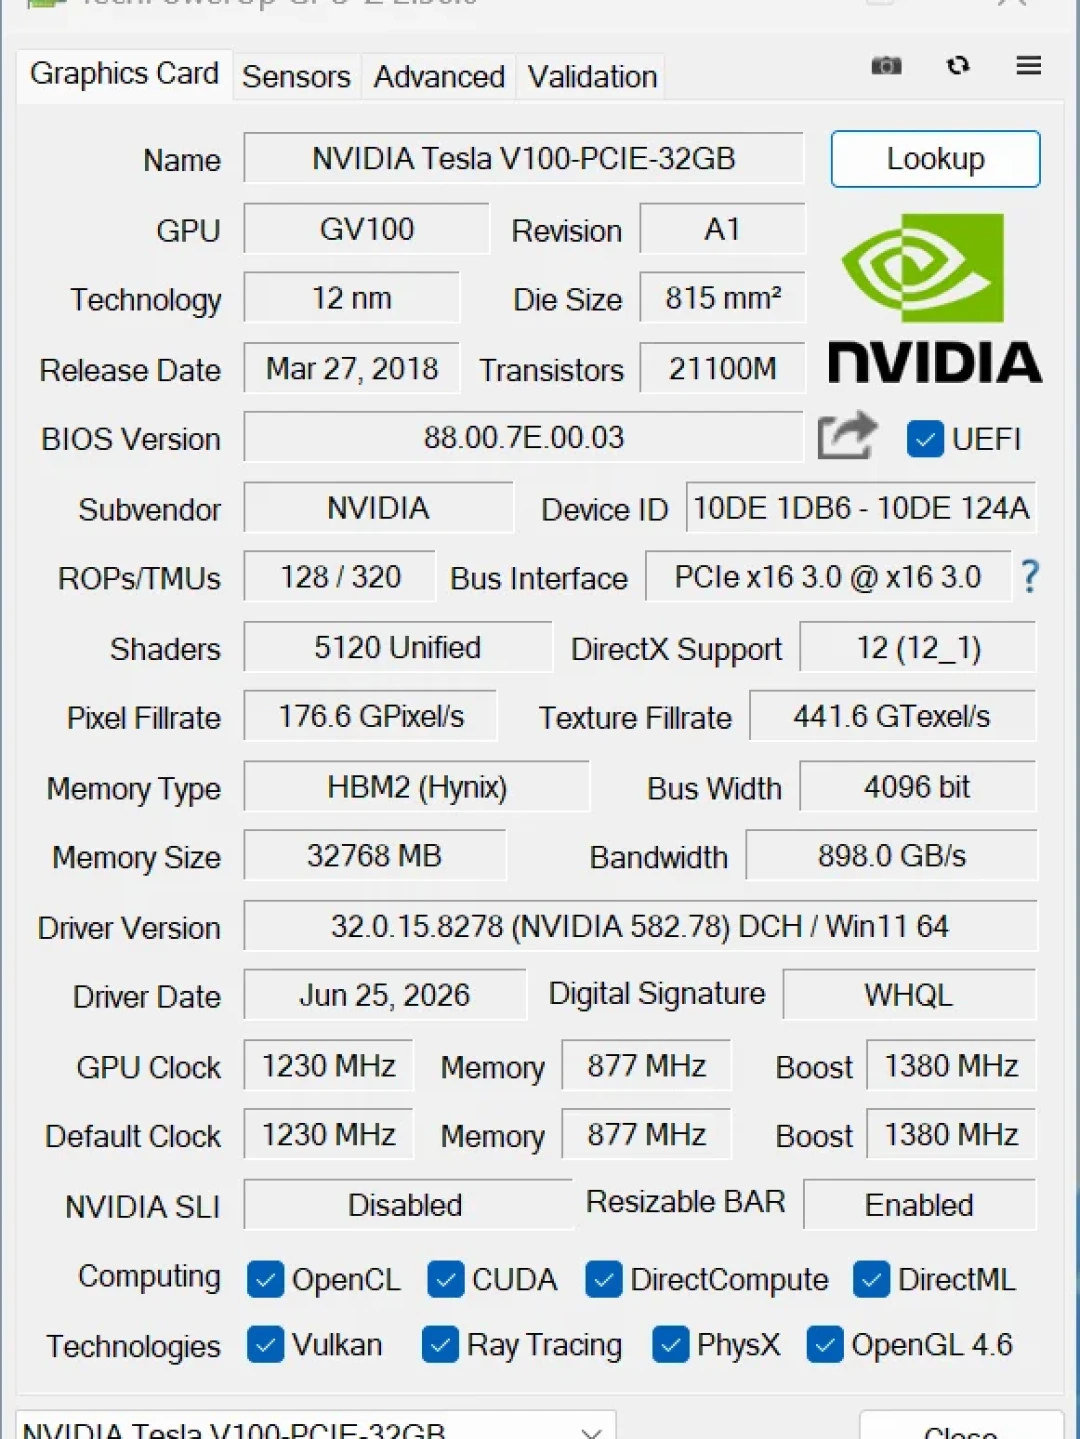
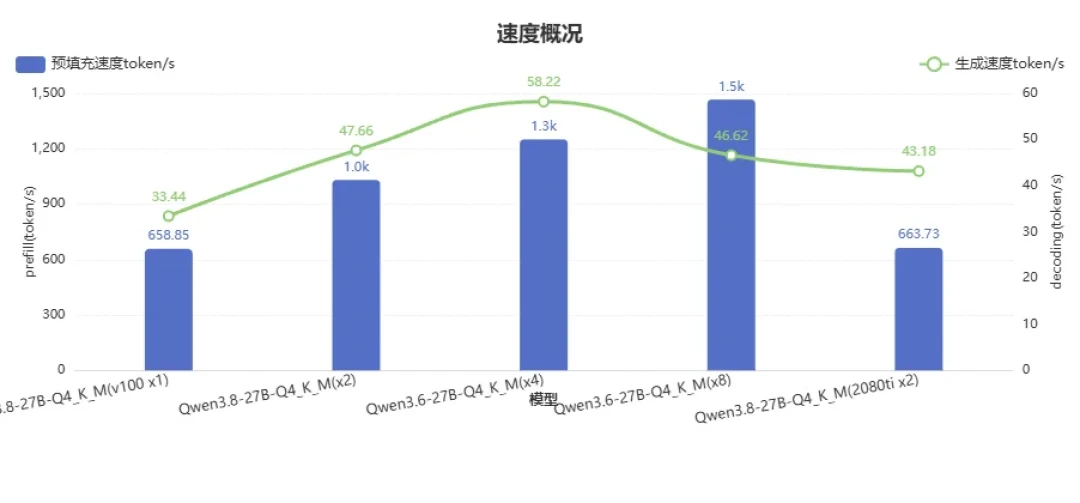
GPUStack社区实测(10月15日):两张V100 32GB合计64GB显存,跑Qwen3.8-27B-FP8,权重约28.75GB、双卡显存占用约60.8GB,低并发单请求生成约26~38 tokens/s——内部问答、办公助手、代码辅助够用。 作者把坑也列全了:V100没有显示输出要另配亮机卡、被动散热吃机箱风道、二手卡要查ECC和维修翻新记录、标准vLLM不支持得靠1Cat-vLLM这类适配层。小红书
B站"AI练习生x顺子"(10月10日):双二手V100-32G(无NVLink),跑176B MoE的IQ3_S量化、权重82.8GB,标称190 tok/s、同场景追平四万多的5090。 注意这条视频赞166、评论286——评论区本身就是一场交作业加反驳:有人照参数把自己双16G V100从63.4调到92.2 tok/s;有人双3090+128G内存把prefill冲到4000,说"预填充其实才是真正的瓶颈";也有人一句话泼冷水:“跑分再快,实际干活就卡死,这也是没有意义的。”哔哩哔哩
小红书"与AI同行"(8月末):4张二手3060、总价不到6000块,跑143GB权重的DeepSeek V4 Flash,标称100 tok/s。 25个赞、22条评论,这个量级的数据只能当参考,别当依据。小红书
小红书"极客老猫"(9月初):8张二手2070凑64G显存、自制开放式机架"显卡住楼房"。 456赞255评,评论区比正文有用:115赞高评说"以前,这个东西叫矿机架";27赞高评直接给结论——内部有24小时不间断的服务、对模型质量要求不高、数据不出外网,自己部署一个也可以,外网直接买tokens;另一条17赞说"如果不是个人兴趣,其实买token比电费便宜"。小红书
Strata改写的不是速度,是旧卡的计价方式
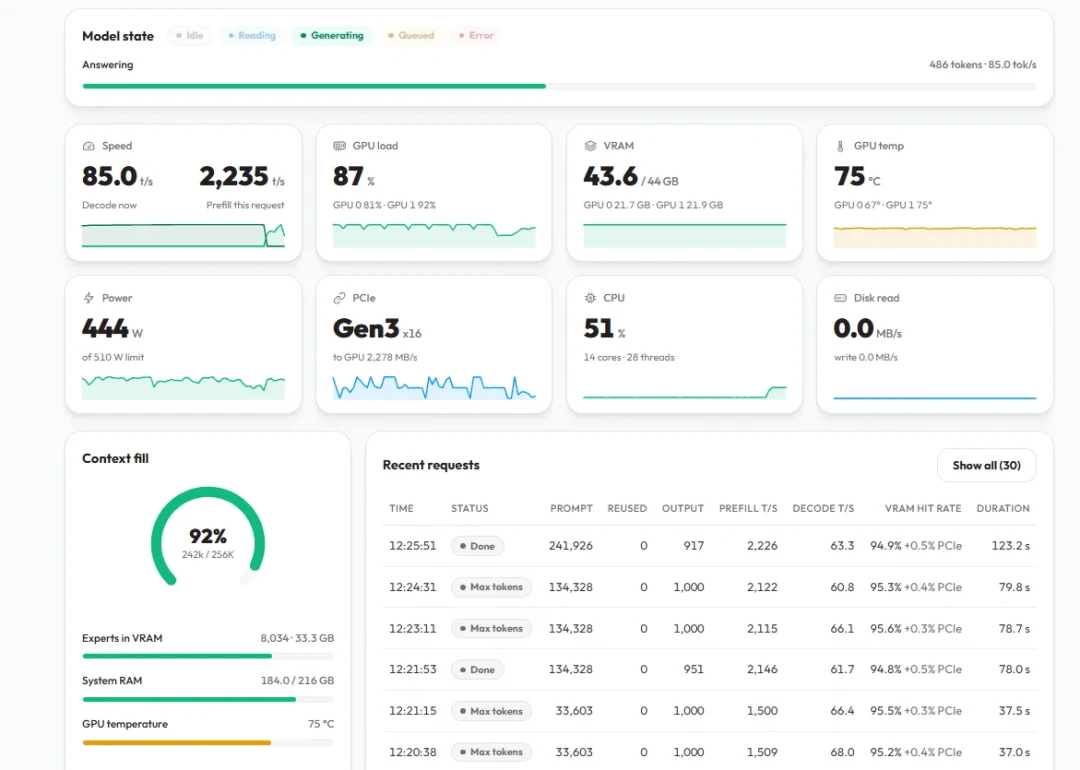
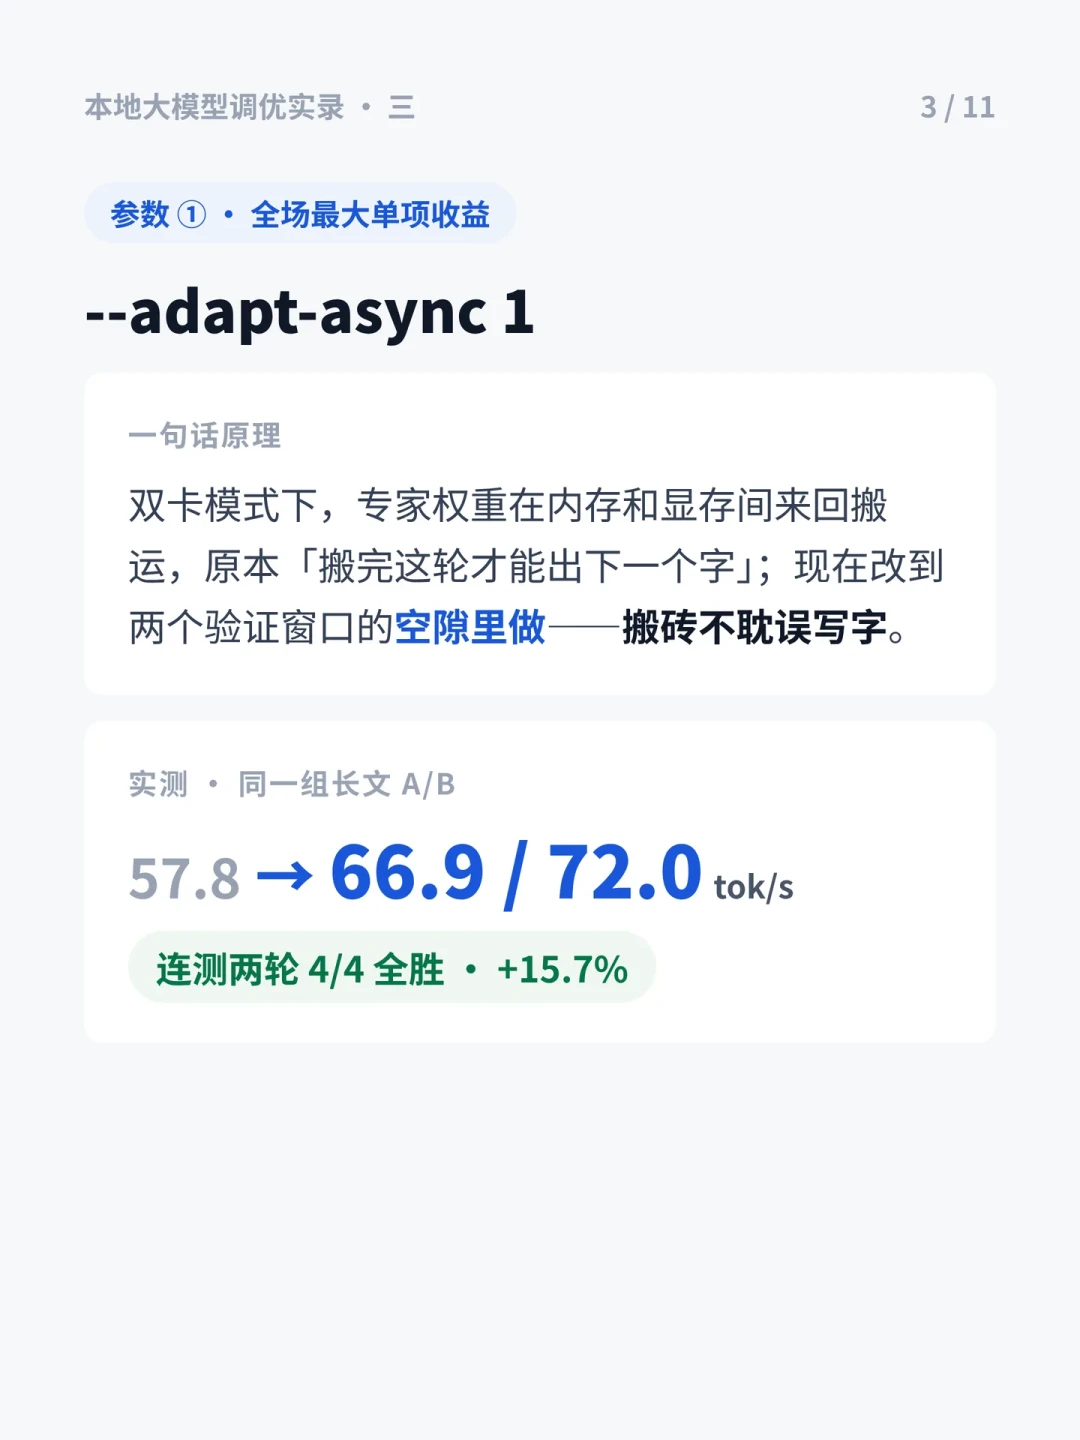
这两周引擎侧的更新密度,是过去半年没见过的:10月10日前后,Kvmem宣称16G显存实现上下文大突破、NINFER+Kvmem在5080上又给一轮提速;10月13日有人放出本地编译版Strata,专门适配各种魔改卡,代价是"需要100G左右硬盘空间"。 10月16日,阳仔zyy把Strata的热专家调度迁进SGLang,让一台服务器上ds4.1、glm5.3、qwen3.8三个模型通通提速至少30%。 防爆键盘的Qwenox则把1路到8路并发的总吞吐从55做到97 tok/s。哔哩哔哩哔哩哔哩哔哩哔哩
对自制系统党,真正的连锁反应发生在闲鱼上。V100那条视频的评论区10月10日就在喊:“32G版本涨到4000了,六百六十六这都能买4张16G版本的了。” 16G版还是白菜价,但Strata这一代引擎的玩法是"用显存容量换模型规模",32G级别的卡(V100 32G、MI50 32G、2080Ti 22G魔改)集体被重估:有人刚想说"本来mi50 32g最有性价比的,结果涨价了"。10月14日,"让开我先躺"晒出自己2690v4+华南X99+224G服务器内存+2080Ti 22G×2跑Q6kxl量化的配置,35个赞底下挂着50条评论——洋垃圾平台党也下场了,但争论比晒单多。哔哩哔哩小红书
三类人,三笔完全不同的账
只想尝鲜的:别买卡。二手4090租着按小时一块多,先用你现有的核显机器装个最小量化模型试试,弃坑零成本。
想要24小时私人助理/内网助手的:这是高赞评论里的主流需求。动手顺序别搞反:先看内存,Strata帖评论区的真实部署反馈是"32g内存就跑的很慢,至少48G内存"。 再看硬盘——本地编译引擎要100G+;最后才是显存。双V100 32G这套目前能把27B-FP8跑到26~38 tok/s,够日常问答。但要有心理准备:量化会掉智商。10月16日"单车酒吧搞机社"那条《本地模型太笨,问题在哪,现在懂了》拿了134个赞。 至于IQ3_S档"q3已接近全精度、不输官方q4km"的说法,出自量化玩家社区的自评,别当保证书。小红书哔哩哔哩
已经在给token交月费的:只有这一档配算这台账。8月11日小红书"地。“说"前段时间收到邮件说我一个月花了学校将近500美元的token”,于是去攒了台128GB显存的机器跑DeepSeek V4 Flash,616个赞。 但同一件事在"极客老猫"评论区的高赞结论是反的:没有24小时需求、没有隐私刚需,tokens最划算。攒机党动手前先把自己的月账单和调用频率摆出来,这两个数决定你是第一类人还是第三类人。小红书
嘴炮单:这三种Extreme Claim先放一边
“7440亿参数的大模型,现在普通电脑就能跑,还不用显卡”,9月16日转发拿了116赞,10月10日再推只剩2赞。小红书
“8GB旧笔记本跑2.78万亿参数大模型”,原帖自己写了"月之暗面旗舰模型Kimi K3,权重检查点1.56TB",2个赞,没有任何交作业回帖。小红书
“低配电脑也能本地跑大模型,不用联网、不用会员、不限次数”(5个赞)。小红书
规律很简单:数字越极端、互动越冷清,越要划到嘴炮堆里。1.56TB权重和8GB内存之间,从来不是"能不能跑",是"一个token等多久"。而真狠活长什么样?那条7667赞的帖子评论区93赞高评说得好:“这几年我在ai圈看了太多吹牛逼,这个是真狠活,让我反而有点不适应。” 区别在于,狠活帖给得出配置、量化档、速度和限制,评论区有人同配置回帖验证;嘴炮帖只有标题。另外记得5月20日"番茄猫猫"那152个赞的提醒:“不要不要不要再拿着某个AI向你推荐的几年前的模型说这个能不能用了。” 追新引擎之前,先确认你抄的配置还是不是本月作业。小红书小红书
双11前的三个观察信号
盯价:V100 32G、MI50 32G、2080Ti 22G这一档的二手报价。这轮"按GB显存计价"的重估是单一引擎带的货,热度退了价格未必回得去,但也未必撑到明年。
盯软件栈:1Cat-vLLM这类老卡适配有没有进主流vLLM、Strata对魔改卡的支持是否长期维护。捡垃圾最大的风险不是卡坏,是半年后没人维护你那层适配。
盯同卡作业:新引擎、新量化档出来,先别下单,等一个和你同显存档位的人交作业——V100视频评论区那句"结果:63.4 → 92.2 tok/s(+45%)"的同配置回帖,比任何标题都值钱。哔哩哔哩
这轮自制系统圈玩的不是"自己做一个系统",是"自己养一台24小时待命的AI"。养宠物的第一定律没变:看笼子价格之前,先看饲料——你的token账单、内存条数和硬盘余量,才是这台机器真正的标价签。