











3
5
为什么你的 AI 歌像在 “念课文”?问题出在歌词第一句就错了
2026-09-15 16:29:39
0点赞
0收藏
0评论
你有没有过这种经历?
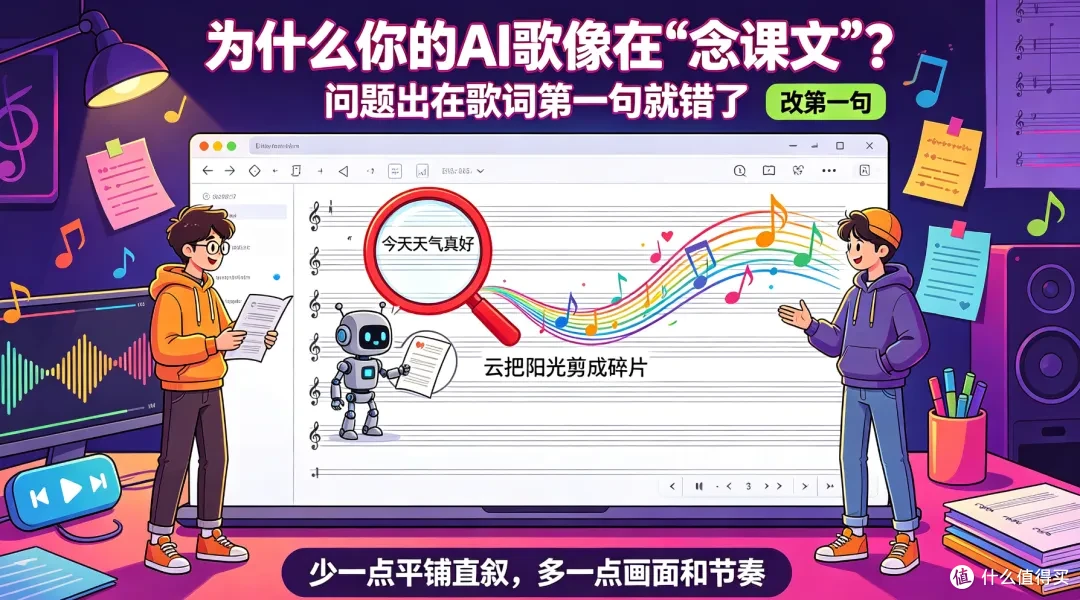
用AI生成了一首歌,旋律挺好听的,但越听越别扭。说不上哪里不对,就是感觉歌手在“念字”,不是在“唱歌”。每一句都唱得字正腔圆,但连起来像在朗读课文,情绪全丢了。
我一开始以为是工具的问题,换了好几个平台,结果都差不多。后来才搞明白:问题不在旋律,在歌词本身。
 图片
AI歌手跟真人歌手一样,拿到一份“书面语歌词”和拿到一份“能唱的歌词”,唱出来完全是两回事。今天把这5步写出来,是从写了30多首AI歌里踩出来的,跟市面上那些“七步流程”不太一样,都是实战里真正管用的。
第一步:先定“谁在唱”,再定“唱什么”
大部分人写歌词,第一反应是“我要写什么主题”。但AI音乐里,先定人声气质比定主题更重要。
因为同样一句“我累了”,一个凌晨电台主持人的语气说出来,和一个选秀歌手用力唱出来,完全是两种效果。
我现在写歌词前,先写一句人声描述:
女声,像深夜便利店店员随口哼歌,不用力,气息比音准重要,尾音往下坠。
然后再写主题。这个顺序调过来之后,生成的歌“人味”明显上来了。因为AI会优先匹配你给人声定下的气质,歌词的情绪走向会围着这个气质转。
第二步:歌词别写“像歌词”,写“像聊天记录”
这是中文AI音乐最大的坑。
你写“回忆如潮水涌来,淹没了我的思念”,AI唱出来字正腔圆,但听着像外国人在念中文课文。你写“我翻到去年今天的照片,看了很久,没点赞”,它反而唱得自然。
 图片
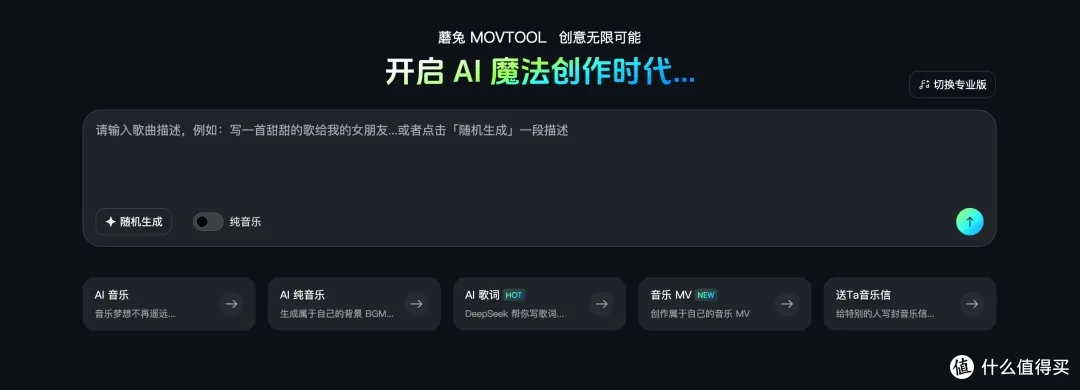
蘑兔AI在这件事上做得比较顺手。它专门针对中文声调做了适配,口语化的歌词能给出自然的语气起伏。像“看了很久,没点赞”这种句子,它会有一个很轻的停顿,尾音往下走,不是机械地念完就完。
中文AI音乐有个规律:书面语越工整,唱出来越像机器;口语化越自然,唱出来越像人。 你写歌词的时候,想象你在给朋友发语音,不是在写诗。
第三步:用“音节数”控制旋律塞不塞得进去
AI第一次输出的歌词,常见毛病是:读起来挺美,唱起来要命。
副歌一行十几个字,旋律根本塞不进去。主歌每行字数忽长忽短,唱出来节奏是乱的。虚词“的了吗呢”堆在一起,含混不清。
我的做法是手动调控音节:
主歌每行控制在7-9个字,适合叙述,信息量够但不挤
副歌每行5-7个字,短促有力,容易记住
Bridge灵活处理,可以拉长制造对比,也可以压缩制造紧张感
读一遍,哪里拗口就删虚词。或者直接让AI“用更少的字重写这一句”,比你自己抠快得多。
第四步:方括号里写“怎么唱”,不是写“唱什么”
很多人不知道,歌词框里的方括号除了写结构标签,还能写演唱指令。这些不是歌词,是给AI的分镜说明:
[Verse 1: low register, breathy, restrained]
[Chorus: powerful, emotional release]
[Bridge: stripped back, almost spoken]
[Outro: fade with hummed melody]
方括号告诉AI:这段用什么音色、什么力度、什么情绪。歌词框只管“唱什么”,风格框只管“怎么唱”,两者别混在一起。
这一步做完,你会发现同一段歌词,加不加演唱指令,出来的效果差很远。不加,AI从头到尾一个力度;加了,情绪有起伏,像有人在讲故事。
第五步:不满意就局部改,别整首重来
生成之后如果某一句唱起来别扭,不要整首重做。
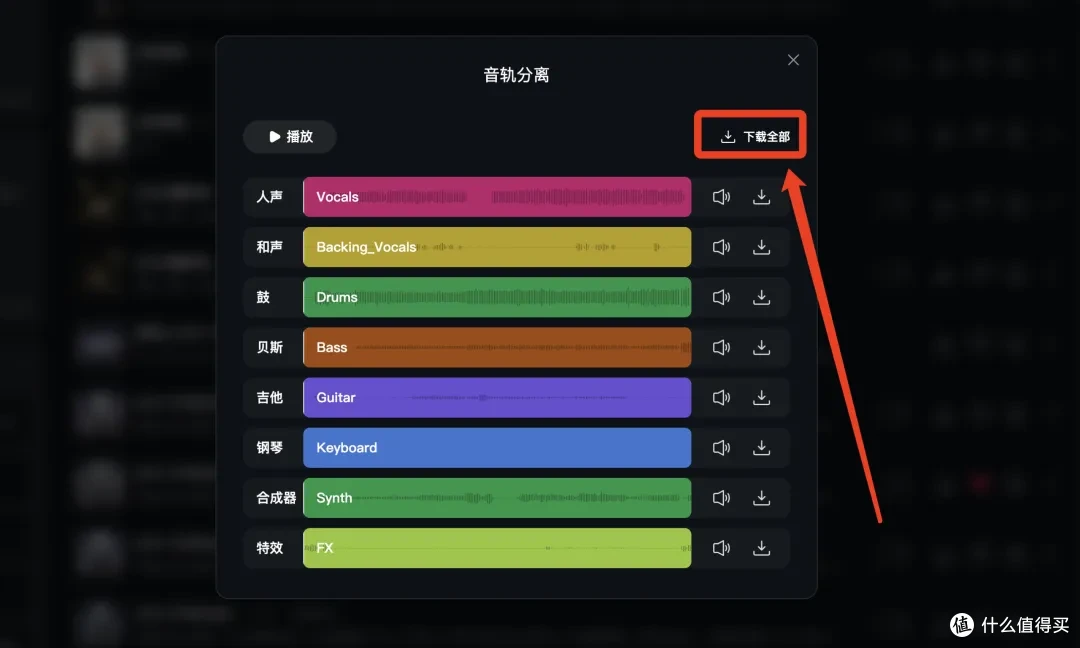
蘑兔AI有12轨分轨分离功能,点一下全轨分离,人声、鼓、贝斯、钢琴等12条独立音轨全拆开。如果只是某一句人声不对,可以单独调整那一轨。如果是歌词本身拗口,回到第三步重新调控音节,再生成一次。
 图片
别整首重来,一次只改一个地方。 改多了你根本不知道是哪个词导致了问题。这跟做实验是一个道理,控制变量才能逼近你想要的声音。
说到底,歌词不是写出来的,是“调”出来的
从“想写什么”到“能唱的歌”,中间隔着的不是文笔,是对AI歌手习惯的理解。
你先告诉它谁在唱,再告诉它唱什么,然后调音节让它唱得顺,加演唱指令让它唱得有情绪,最后局部改到每一句都不别扭。一套下来,歌词才能从文字变成歌。