

你把 CLAUDE.md 磨了两周,规则、口径、禁忌一条条写清楚,终于顺手了。然后为了省钱,用 cc-switch 把接口切到另一个模型——它突然变笨了:以前一遍过的活反复返工,你亲手加的约束像根本没写过。
第一反应通常是“这模型不行”。谷歌 11 月 13 日挂出的一篇预印本说:先别急着下结论。
论文标题直译过来是《自我改进记忆实现持续递归自我改进》(arXiv 2611.18856),作者来自 Google Cloud AI、Google DeepMind 和宾夕法尼亚州立大学。他们没动模型权重,动的是 harness——套在模型外面的那一层:提示词、工具怎么返回结果、执行到哪一步才准宣布完成。你写在 CLAUDE.md、AGENTS.md 里的那套东西,就是它。新智元微博智东西
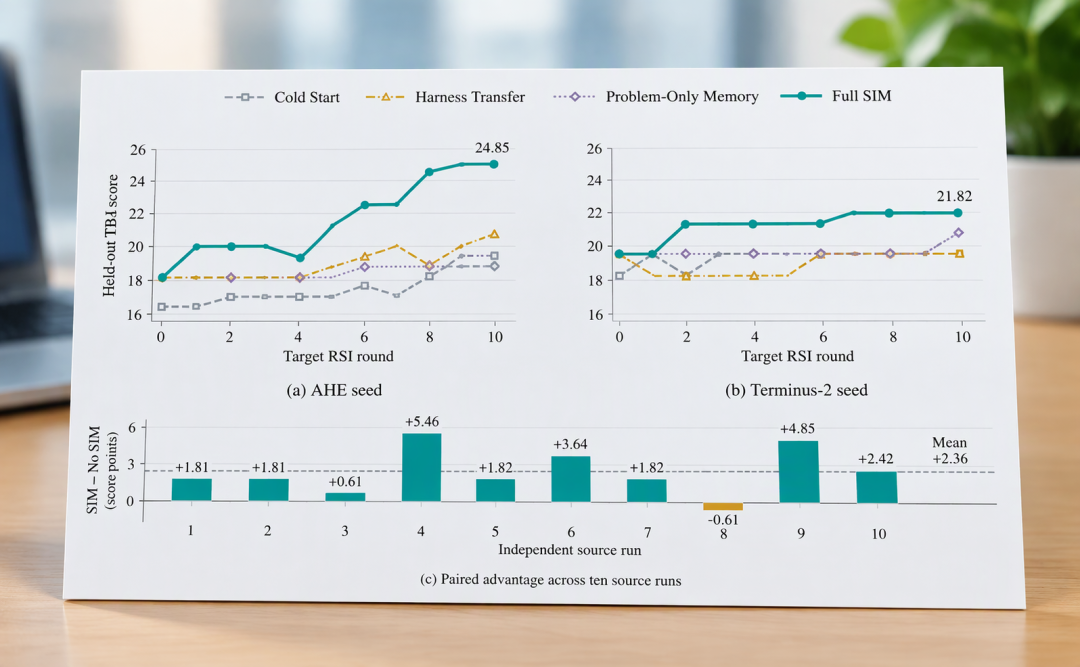
实验分两段。前一段让 Claude Opus 5.5 跑任务,Gemini 3.8 Flash 在旁边一轮一轮改外壳;后一段把跑任务的也换成 Gemini,接着改。
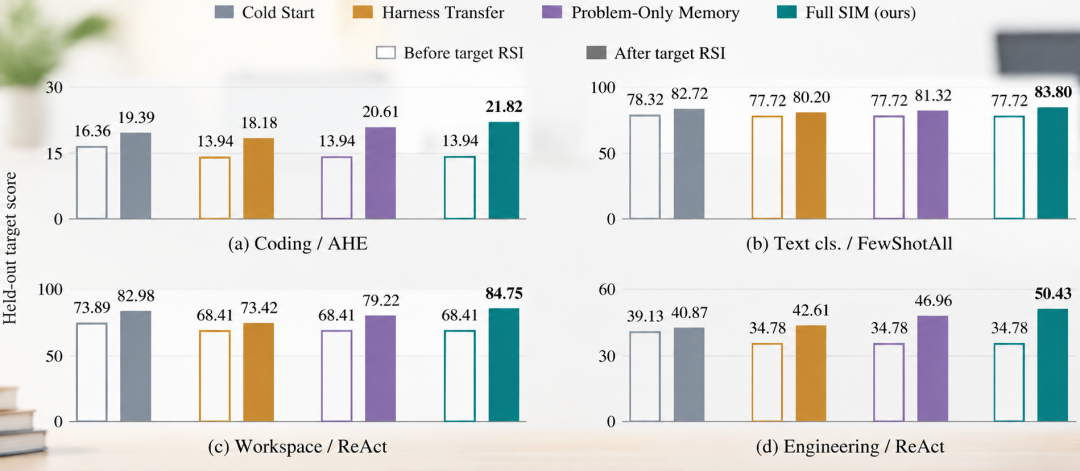
第一组数字就挺扎心。办公类任务上,Gemini 用自己原生的初始配置能拿 73.89 分;接手 Opus 调好的那套,起点只有 68.41,低了 5.48 分。而且换模型时四个领域无一例外全都更低:编码低 2.42,文本分类低 0.60,工程设计低 4.35。别人辛辛苦苦调好的东西,搬过来反而拖后腿。alphaxiv知乎
更狠的是第二组。同样从 68.41 起跑十轮:只把代码交过去,最后 73.42;干脆全扔掉、从初始配置重新调,82.98。背着旧包袱改十轮,不如从头改。新智元微博
为什么会这样?因为交接的时候,留下的只有“结果”,丢掉的是“原因”。
论文里有个例子特别好懂。一个配置 Git 服务器的任务,Agent 读到说明里一句“我自己来设登录”,就跳过了创建指定账号,改用机器上现成的 ubuntu 账号把本地检查全跑通,条条成功,宣布完成。验收方走的是另一条路:用指定账号 SSH 推送,连接被拒,页面 404。于是加了一条拦截:没有真实执行证据,不准提交完成。知乎
这条规则后来被交给了 Gemini。代码在,理由不在。Gemini 不知道它为什么存在,在同一处来回改了四次,其中两次是在修自己刚改出来的死锁,还把这条继承来的规则误记成是自己第一轮加的。规则还在,用途没了。微博36氪
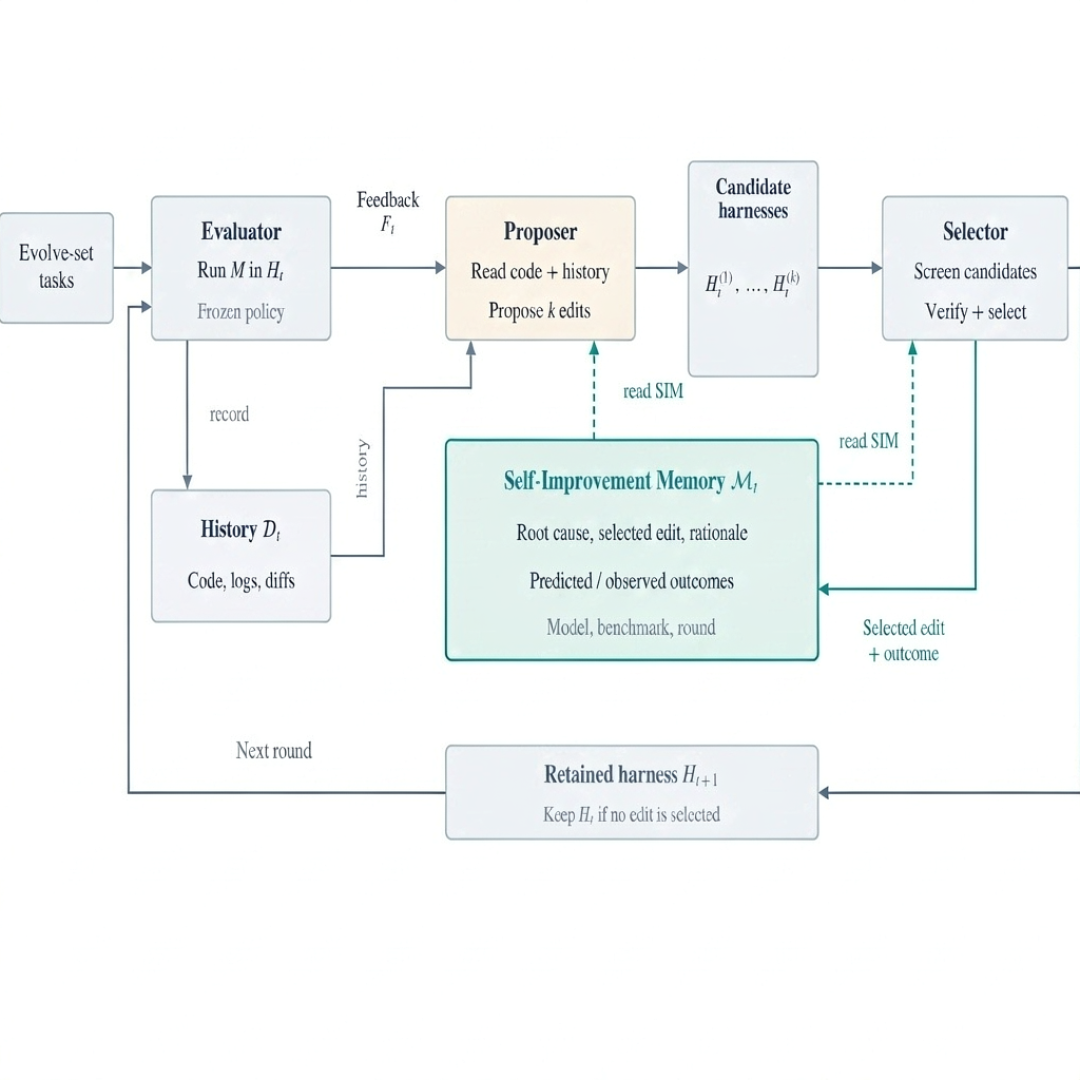
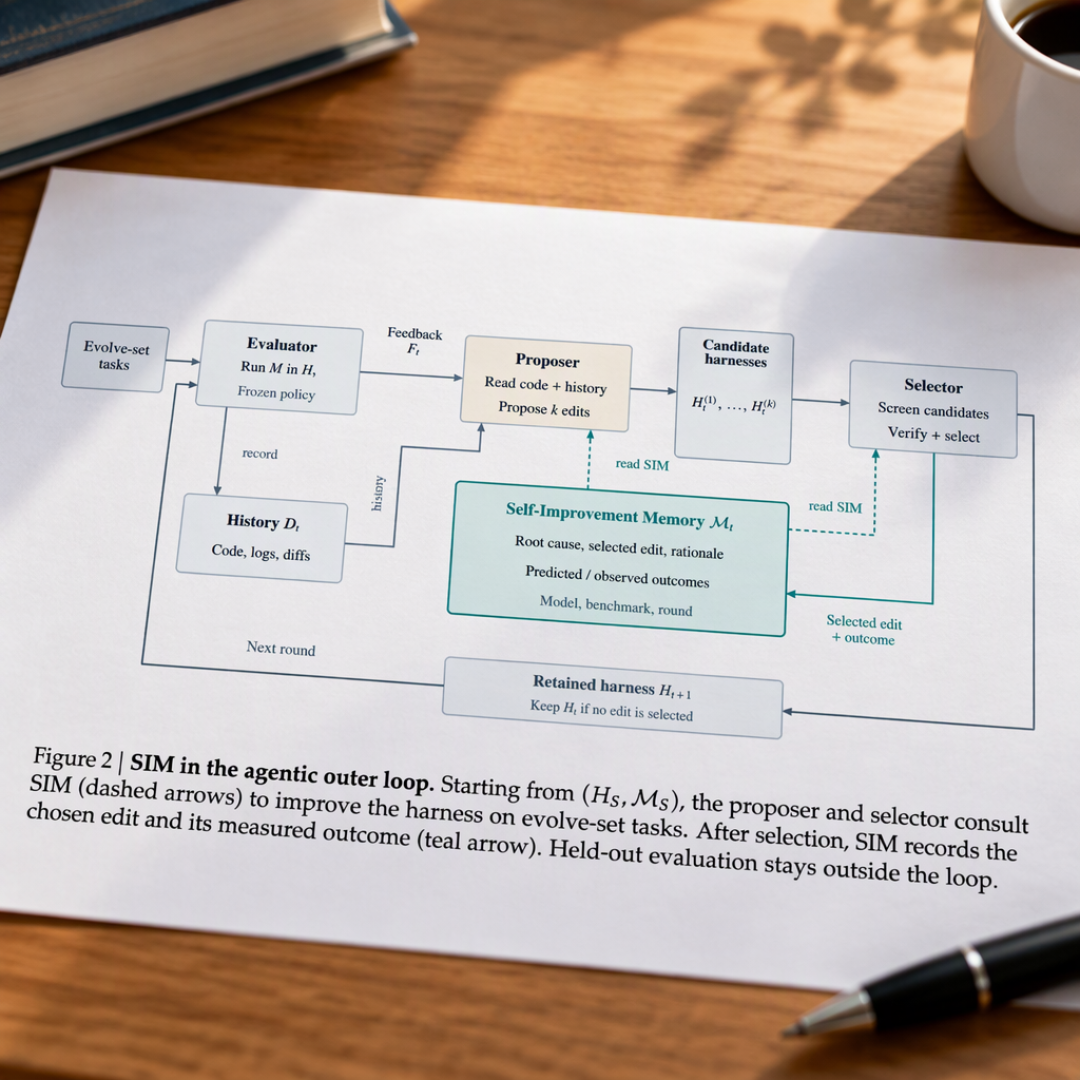
论文给的解法叫 SIM,自我改进记忆。注意,它不是给做题的那个 AI 记笔记,是给“负责改规则的那个 AI”记:改了什么、为什么改、预计修好哪几道题、实际结果如何、当时用的什么模型和评测环境。失败的、已经证明没用的尝试,也要记一行。新智元
带着这本笔记接手,同一个起点,十轮跑到 84.75,比只带代码高出 11.33 分。不过这篇论文的账得算清楚,别被“AI 学会自我进化了”这种标题带走。智东西
做得最扎实的是编程那组:同一个种子配置独立进化 10 次,每份分成“只带代码”和“代码加笔记”两支,换到新基准上接着跑十轮。平均起点 18.36,只带代码 19.33,带笔记 21.70,10 组里赢 9 组,平均高 2.36 分,p=0.003。输的那一组,差 0.61 分。知乎智东西
轮数一样也不等于花的钱一样——一轮编码优化约 4 小时,十轮续跑约 40 小时。其他领域也没这么讲究:办公、文本分类、工程设计,每种条件只跑了一次;办公那组还用模型当评委,论文自己提醒可能有偏差。样本这么薄,结论就别往大了说。知乎新智元
笔记也不是保命符。论文也没说 Gemini 的产品已经在用这套办法。他们让同一套配置和记忆依次适配 Gemini 2.5 Flash、3.5、3.8 和 4 Argon:在 3.5 上领先 3.5 分,3.8 上领先 1.6 分,到 4 Argon 反而落后 0.8 分。有记录,不等于只会变好。微博智东西
那普通人能拿走什么?不用搭那一整套系统,就一件小事。
下次改 CLAUDE.md、AGENTS.md 或者自定义指令,别只留最终版,在旁边留一行“为什么”。七项就够:要解决什么、看到哪类失败才动手、具体改了哪段(别写“优化了一下”)、预期修好哪些、实测结果、当时的模型和环境,以及换模型时哪些默认保留、哪些禁止先删、哪些必须重测。微博
最常见的疏漏是:仓库里只存了最终版提示词,失败的记录全散在聊天窗口里。换模型那天,你一条都翻不出来。
换了模型,既不要默认旧规则还能用,也不要默认该全推倒。先读一遍自己当初留下的理由和实测,再决定下一步。
要带走的从来不是配置本身,是你当初为什么这么配。

当前文章无评论,是时候发表评论了