

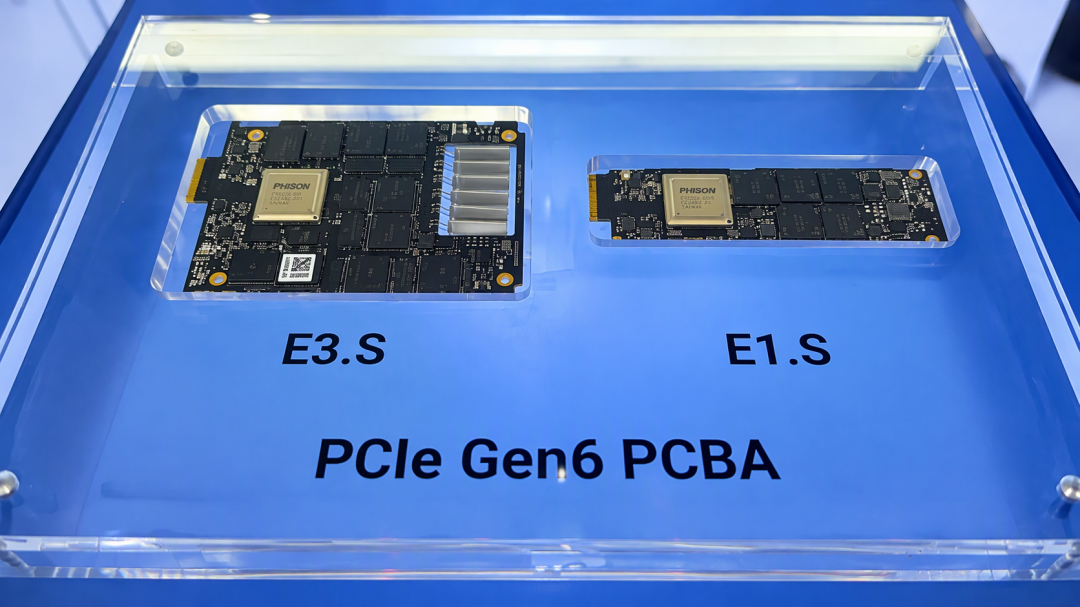
在本周的SC26超级计算大会上,群联(Phison)展示了两款企业级SSD设计,其中一款是能直接在硬盘里跑AI的智能固态硬盘:主控内置NPU,盘上自带64GB内存、带宽130GB/s,可以运行PyTorch、llama.cpp、vLLM、OpenVINO等主流推理框架。思路是把计算下推到数据所在的地方,只把结果回传主机,而不是让数据整批往返搬运,官方称这样能把硬盘与主机之间的数据传输量减少10到100倍。"固态硬盘跑AI"随之冲上热榜。但兴奋之前,有三件事需要先钉住:产品还在开发中,官方给出的性能口径不是通常衡量AI算力的TOPS,而它真正要解决的,是AI机房里的数据搬运问题,不是普通玩家本地跑大模型。小红书IT之家微博
它省掉的"搬运",正是当下推理集群最贵的一笔开销
过去SSD在AI系统里的角色是仓库:模型权重、数据集、素材文件存在闪存里,用时先读进内存,再交给CPU或GPU计算。模型越大、上下文越长,这条"闪存—内存—计算单元"的通道就越拥挤。行业这一年的动作,是把KV Cache往SSD上分层——Mooncake、NVIDIA CMX这些推理架构已经把SSD正式纳入存储层级。这已经不是停留在PPT上的概念,存储第一次从算力的外挂变成推理链路的一环。但普通SSD只存不算:量化、索引、查找、搬移这些活仍然压在主机CPU上,数据还要在几级存储之间来回绕行。知乎
群联的方案是反过来:既然瓶颈在搬运,就把计算推到数据所在的地方。盘自带64GB内存和NPU,在盘内先做筛选、处理甚至直接跑推理框架,只把结果回传给主机。打个比方,原来是把整仓货搬到办公室再盘点,现在是仓库里驻一个带设备的会计,报上来的只需要汇总表。
36,800 DMIPS,是个需要小心的数字
报道里最容易被误读的是性能指标:群联给出的算力数字是36,800 DMIPS——这是上世纪80年代沿用的CPU整数运算基准,而非NPU常用的TOPS,公司也没有公布这颗板载NPU的TOPS数值。DMIPS衡量标量处理能力,TOPS衡量每秒万亿次运算,两者之间没有可靠的换算关系,所以"这块盘有多少AI算力"目前其实无法判断。一个可参照的坐标是:群联此前在Computex展示的Topaz NPU加速卡为8颗NPU、单颗最高40 TOPS,相比之下,盘上这颗NPU更可能主要承担存储侧的数据处理和轻量推理,而不是让SSD顶替显卡。小红书微博
同一场展会里,藏着群联更完整的意图
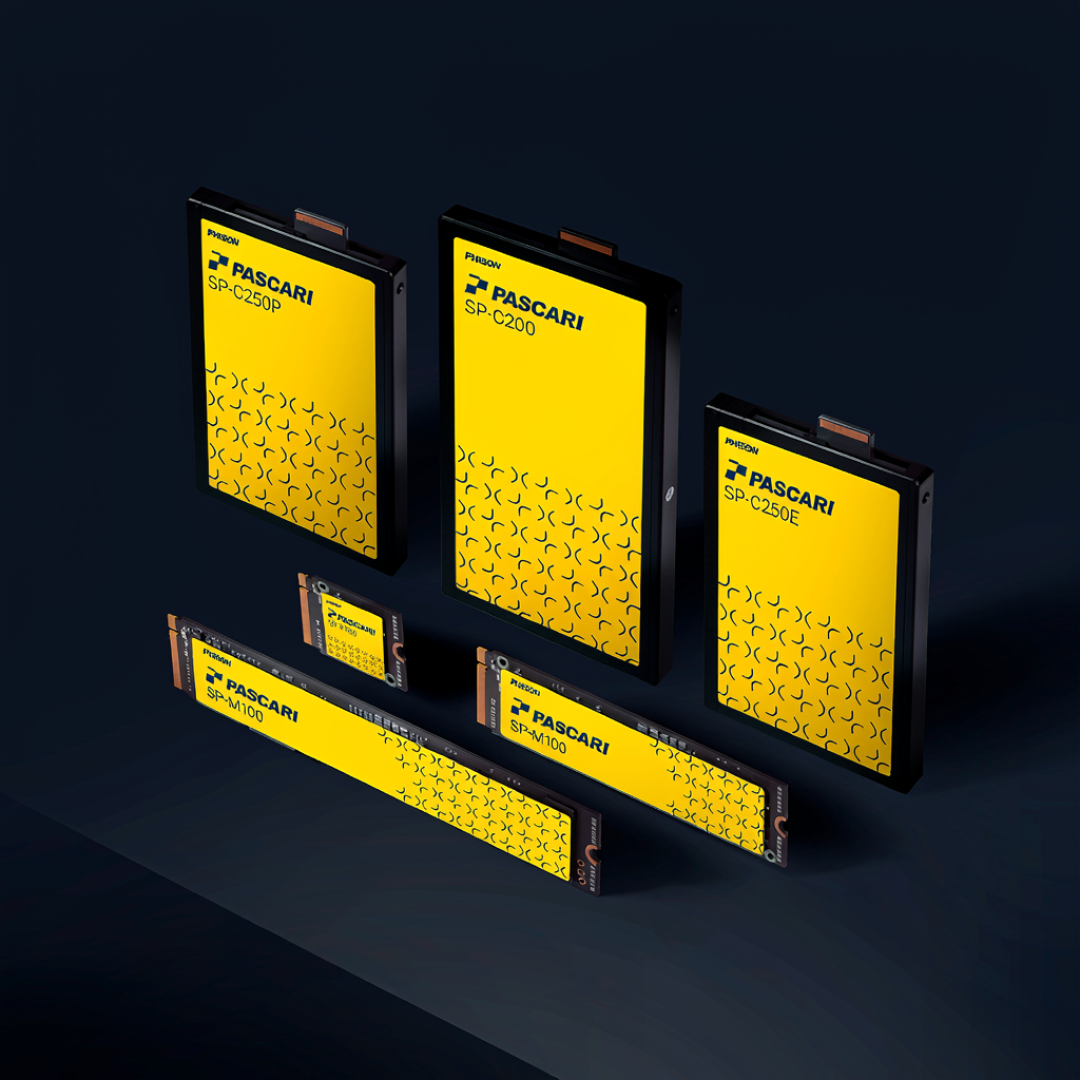
这次端出的不止一款产品:另一款混合介质SSD把pSLC缓存和QLC闪存整合到单一控制器下,既提升写入性能,又让故障损失不再波及整盘。群联还在同一展会上推出了面向商业航天的Pascari Space太空存储SSD方案。这些产品拼在一起,指向同一个判断——存储厂商正在集体把"计算"塞进存储侧,争夺的目标是每个Token的综合成本,而不是单纯的读写速度。IT之家微博
时间点也值得注意。这轮AI需求把内存和闪存产能推到了高位,集邦对四季度的判断是NAND合约价还要季增15%到20%,消费级固态的大宗价已连涨六个季度。群联CEO潘健成在此前的行业访谈中判断,全球内存与存储芯片的供需失衡将一路持续到2030年。在DRAM这么贵的时候往一块盘里塞64GB内存,看似奢侈,对企业买家却可能算得过来:用盘上的内存和算力换取整机更少的数据搬运和更低的CPU占用,未必比继续堆显存昂贵。知乎微博
离普通用户还有多远
需要明确的是,这两款设计目前都还在开发阶段,群联注明相关产品仍在开发中、没有给出上市时间。SC26是超算大会,这场展示的受众本来就是数据中心;社区里普遍的判断也是企业级先试水,消费级短期内不必期待。对现在就想本地跑AI的用户,加内存条仍然是最直接的方案。值得跟进的观察信号有三个:群联是否会公布这块NPU的TOPS和实测推理吞吐、框架适配清单会不会扩展到更多主流后端、以及企业级送样何时落地。方向是实的——存储参与计算已经是行业趋势;但从展台到你的机箱,中间还隔着工程样品、固件生态和这一轮涨价周期。小红书微博


当前文章无评论,是时候发表评论了