九个AI,九十分钟,七道造桥关。榜单一出来,国产模型排在第六到第九:Kimi 32.47分,混元31.45分,豆包30.96分,DeepSeek 27.93分;前五名全是国外模型。 这不是一张好看的榜,但它也不是一张能直接读出“智商”的榜。GitHub
但把成绩单往下翻,会看到另一件事:第四到第六这三关,只有Sol、Opus、Astra拿到过分数;第五关只有Sol一个人过关。Gemini和Grok同样一分没拿。 真正被后三关拦住的是六个模型,国产四个恰好都在其中。把“后三关全灭”直接读成“国产模型脑子不行”,漏掉了这堵墙的宽度。GitHub
国产模型和前三名的差距,其实在前面三关就露出来了:它们大多能让车开过去,但桥造贵了。第一关参考造价3509.84,Kimi花了6065.40,得分57.87;第二关参考造价10616.73,Kimi花了18337.64;第三关参考造价7967.26,Kimi花了9921.72。豆包、DeepSeek也差不多,桥能通,报价却总比参考价高出一截。 反观Sol,第二关只花7701.80,得分137.85。规则写得很清楚:关卡分=100×参考造价÷你的造价,过关只是入场券,省下来的钱才是分数。到了后三关,差距不再只是贵一点,而是直接变成0分。GitHub
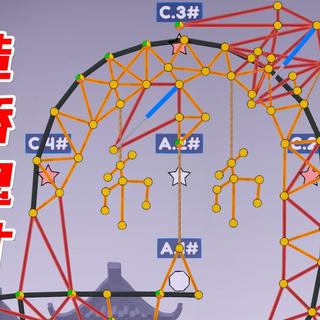
后面三关为什么难?第四关要过船,桥不能把航道堵死;第五关没有木杆,预算只有一万;第六关三十六米河面、两块礁石、航道、双向卡车。Kimi交上来的设计都合法,甚至没超预算:第四关24935,第五关9780,第六关11741,全在预算内,却分别0/2、0/2、0/3,连一个场景都没过。 这不像“不会造桥”,更像“桥造出来了,但最后那一下没合上”。GitHub
这大概就是“最后一厘米”的问题。语言模型很会生成“看起来像桥”的结构:桁架、拱、斜拉索,套路都熟。但桥不是图片,每一根杆都在受力,长杆会屈曲,机构会散架。B站一位UP主自己写了桁架求解器,随机搭一千座桥,七百二十九座连受力都算不出来,直接是机构;活下来的二百七十一座里,最省料的一座比标准桁架少用百分之十九的料。 视频里有一句话很准确:模型吐出来的是字,不是力。哔哩哔哩
这也解释了另一个UP主办的盲打赛里的戏剧性场面:不给画面、不给代码环境、不给计算器,只给河宽和预算。有模型在第五关整整80分钟没算出来,直接交了白卷,却在最后一关手算到小数点后六位过关。 也有前五关一直特别稳的模型,压轴把桥顶钢架架得太高,两扇桥在半空撞在一起,拿了0分。稳定和灵光一现都可能被放大,单次排名很像抽样,而不像体检。哔哩哔哩
主办方自己也没把这张榜当成能力排名。赛后说明里提醒:工具和接入渠道不同,不能把本场结果当作模型能力排名。 比赛条件里还写着:每个模型只跑一次,单次结果有偶然性。 更别忘了,DeepSeek这边上的是V4.1 Flash,对面是Sol、Opus、Astra;把不同定位的模型放在一张榜上,本来就要留个心眼。GitHubGitHub
回到那个问题:真的是能力不行吗?是,但只是某一种能力——在物理约束下做工程闭环的能力。它真实存在,也确实有差距;可它不是“智商”差距,更不是一句国别判决。桥塌了可以重造,把“能力不行”当成结论,才是真的卡关。