

“12GB显存跑128B Qwen”——11月流行起来的这句口号,让Strata把半个互联网的本地部署心挠得痒痒的。热度是真猛:中文参数完全指南在B站被收藏241次,一键整合包刷屏,连衍生分支都冒出来了。但把各平台评论区的实测翻一遍,真实体验和宣传物料之间隔着一个太平洋。坑不是不能踩,得知道坑在哪再踩。小红书
坑一:瓶颈从来不是显卡,是内存。有用户把实测数据摊在评论区:换 Strata 后 32G 内存 + 4080S 只有 6 tok/s,加到 64G + 3090 24G 才到平均 16 tok/s。知乎那条68收藏的高赞回答话说得更直白:16G显存勉强跑125B MoE,前提是内存得给够,因为它最终激活的参数只有3~6B。所以结论很简单:预算先给内存,64G起步,别急着往显存上砸钱。哔哩哔哩知乎
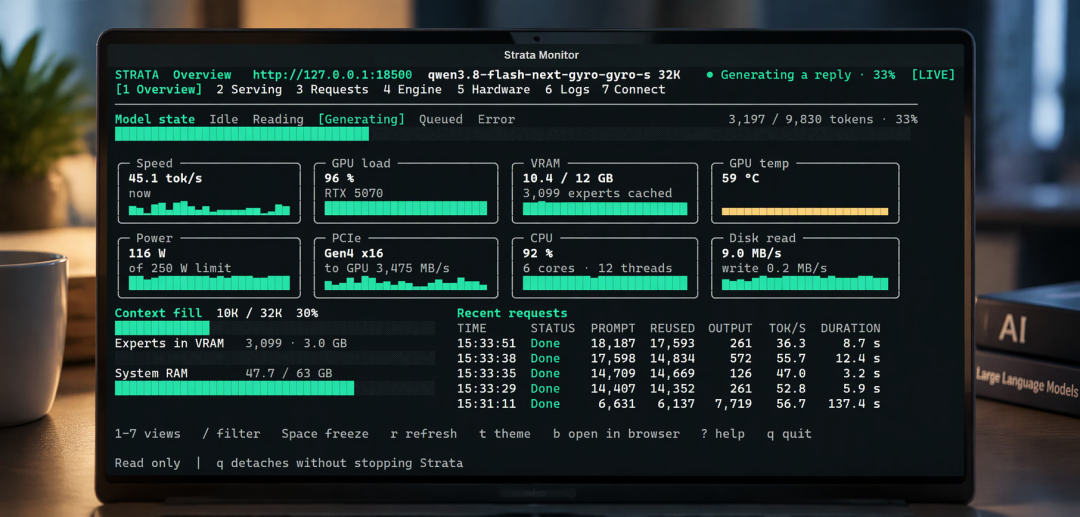
坑二:旧引擎没卸干净,折腾全白费。评论区反馈最多次的无效努力:上一版引擎残留没清,模型重新下完照样卡,卸载干净重装才活过来。每次升级版本,记得把旧目录收拾干净,这条能省你一晚上。
坑三:你自己下的GGUF,一个都用不上。Strata只认自家模型库,硬盘里攒的那些GGUF直接作废,有用户嘀咕这护城河修得也太高了,是不是再过阵子就要收费。生态锁定这事,装之前先想清楚,别等跑顺了才被将军。哔哩哔哩
坑四:“第一轮能跑"不等于"能干活”。评论区最扎心的一句话:本地部署只测第一轮没有任何意义,多轮对话试试就知道了。还有人拿8G卡硬跑重度量化的27B,让它写个网页版扫雷,把256K上下文用完都没完成。小量化模型的第一轮回复是幻觉,先测,再上头。哔哩哔哩哔哩哔哩
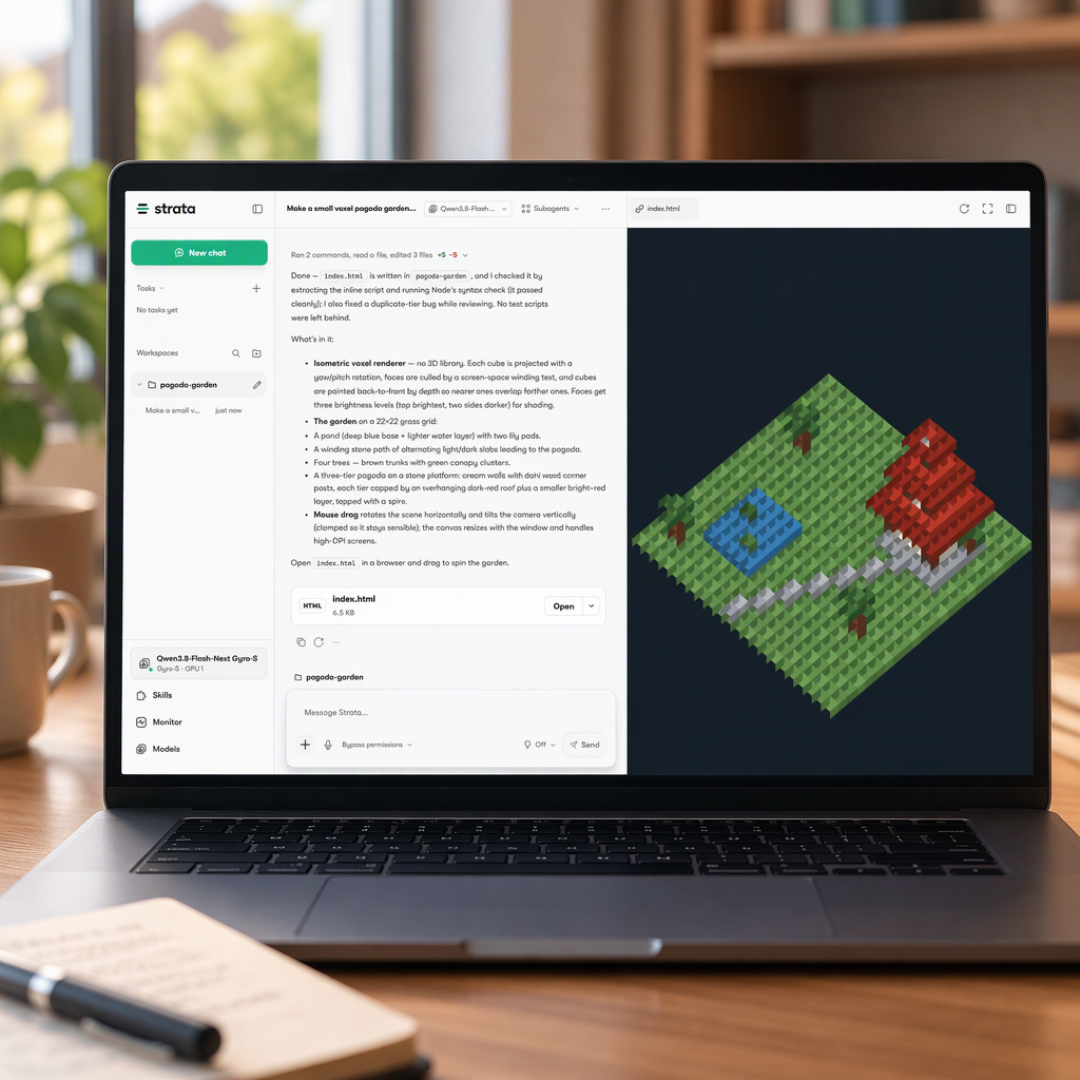
坑五:别急着升级、也别急着换分支,两边都有暗亏。有用户在评论区确认,前一天还跑得好好的DeepSeek,Strata更新后脚就移除了对它的支持。另一边,被吹上天的Basalt分支,官方喊填充2倍、解码1.7倍,实测只有填充快52%、解码快45%。5080加64G内存的用户体感提速五成到一倍,Pro 4000、5060Ti用户却直言没提升,还有人反馈特定量化下会输出出错——而且这分支只吃50系显卡。能跑稳定的版本就让它跑着,干活环境别乱动。哔哩哔哩哔哩哔哩
最后补一句:Strata的默认参数其实还有油水,有人把4090从70 t/s一路优化到稳定130+。花一小时读读那份中文参数完全指南,比你换张卡便宜多了。哔哩哔哩
Strata确实把本地跑大MoE的门槛砸下来了,但这个门槛省的是显存,不是内存、不是硬盘,更不是耐心。年末想上车的朋友,先把一件事想明白:你要的是体验券,还是干活用的生产力。

当前文章无评论,是时候发表评论了