把书扫成一堆乱码、把教辅拍成公式丢失的废片,是传统OCR干过最气人的事。10月27日,百度开源了Unlimited-OCR-2,卖点很狂:一页一页地读书,读到一千页也不停。哔哩哔哩
官方演示有多猛?
《哈利·波特》全集,3623页的PDF,一口气连续解析,总耗时约1个半小时,平均每页1.5秒。《三体》全书同样跑通。你翻几个月都翻不完的书,这个3B的小模型一个下午就读完了。知乎哔哩哔哩
为什么小模型能读千页?
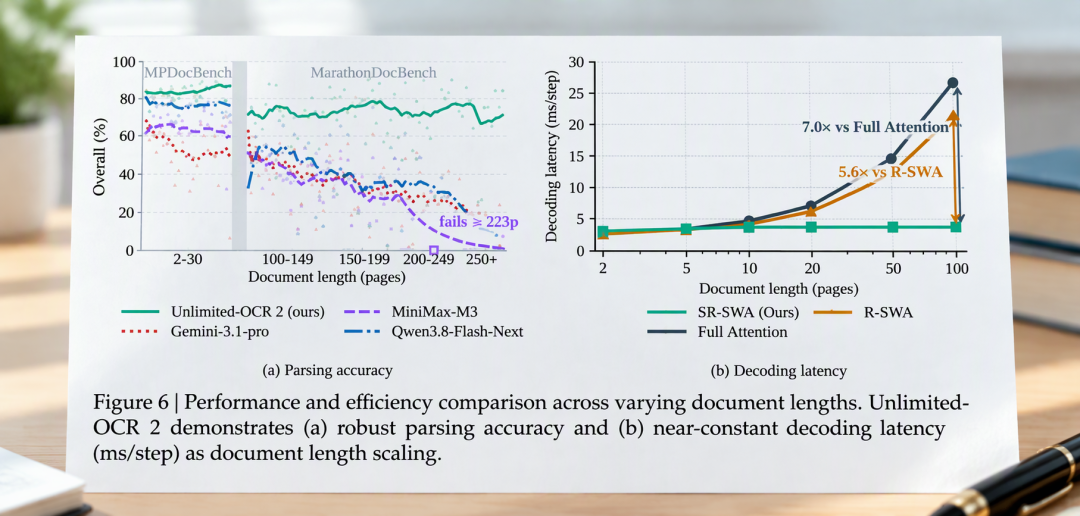
秘诀是省。传统全注意力会把所有历史内容都"记在账上",页数越多越吃显存、越读越慢——从2页到100页,单步解码延迟能从3毫秒涨到27毫秒。Unlimited-OCR-2用了两招:知乎
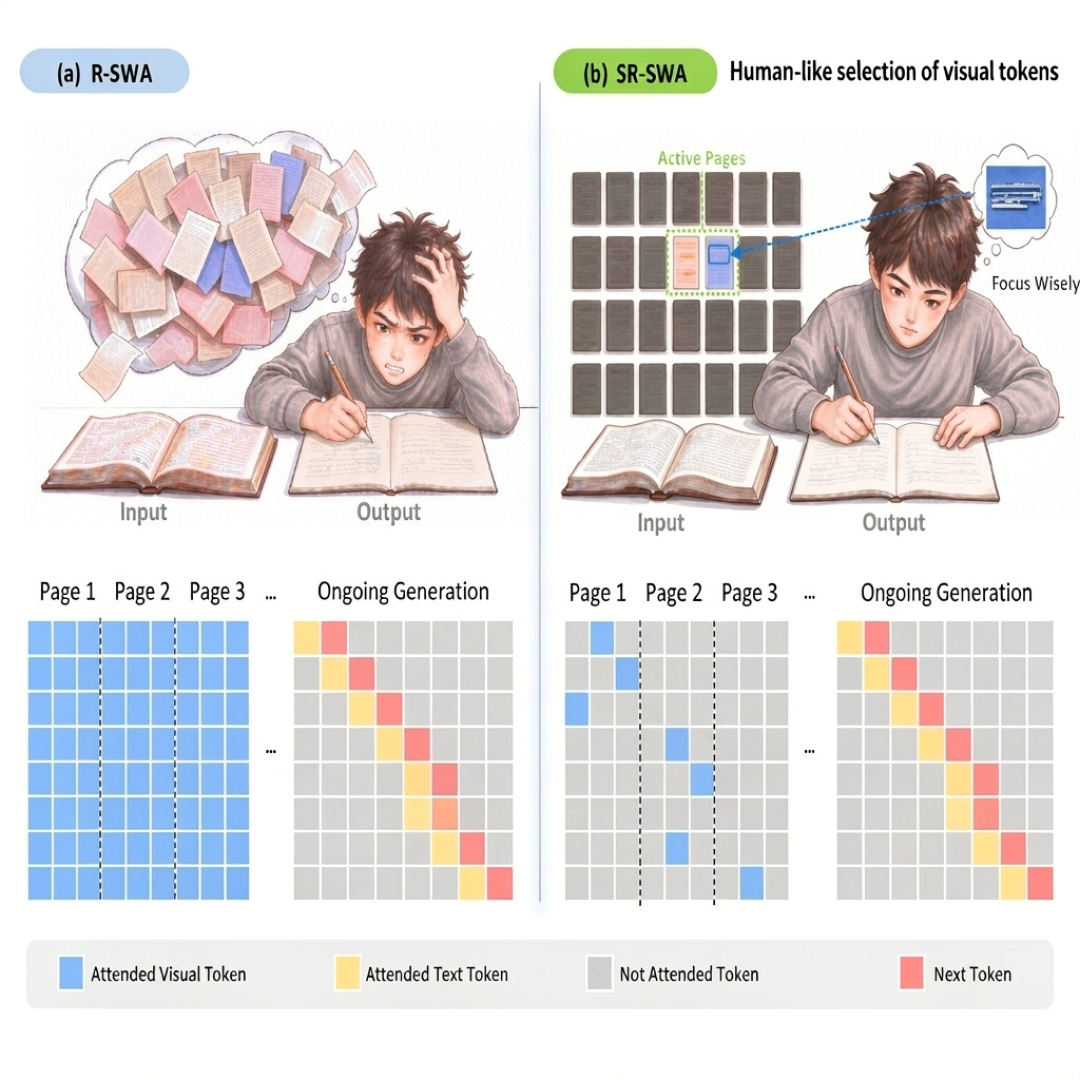
SR-SWA稀疏注意力:只挑跟当前页相关的少数几页看,页内再筛重点内容算,每一步的工作量是固定的;
无限解码:按窗口滑动推进,翻页处留一页"交接页"衔接段落和续表,读完的旧缓存直接释放。
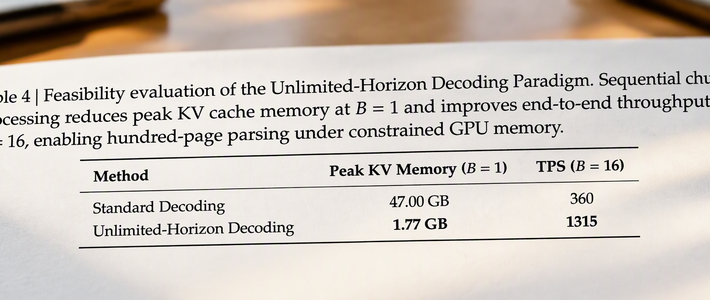
效果是峰值KV缓存从47GB压到1.77GB,降了96%,300页时延迟依旧平稳。要提醒一句:这些数字全部出自百度自家的技术报告,目前还没看到独立复现。知乎知乎
本地部署要花多少钱?
权重约6.3GB,MIT协议,商用没问题。实测情况分三档:知乎
官方Transformers测试在A800 80GB上完成,这是豪华版。
社区硬核玩家用RX 9060 XT 16GB加Windows跑通了ROCm路线,代价是踩了两个坑(transformers硬导入分布式模块、默认配置去找NVIDIA的Triton编译器)。知乎
B站UP主"AI超元域"用RTX A6000实测:单页扫描书页2.6秒,10页PDF用39.7秒。哔哩哔哩
显存账要算清:权重6.69GB加KV缓存1.77GB约等于8.46GB,这只是下界,激活值和CUDA上下文还没算进去。别看见1.77GB就以为亮机卡也能跑。知乎
实测的坑,比宣传更诚实
竖排繁体的字能认出来,左右阅读顺序却是反的。哔哩哔哩
文档级结构是短板,尤其标题层级——官方Limitation也承认稀疏注意力不保留全局信息,指望它自动生成目录的,先验收再上生产。
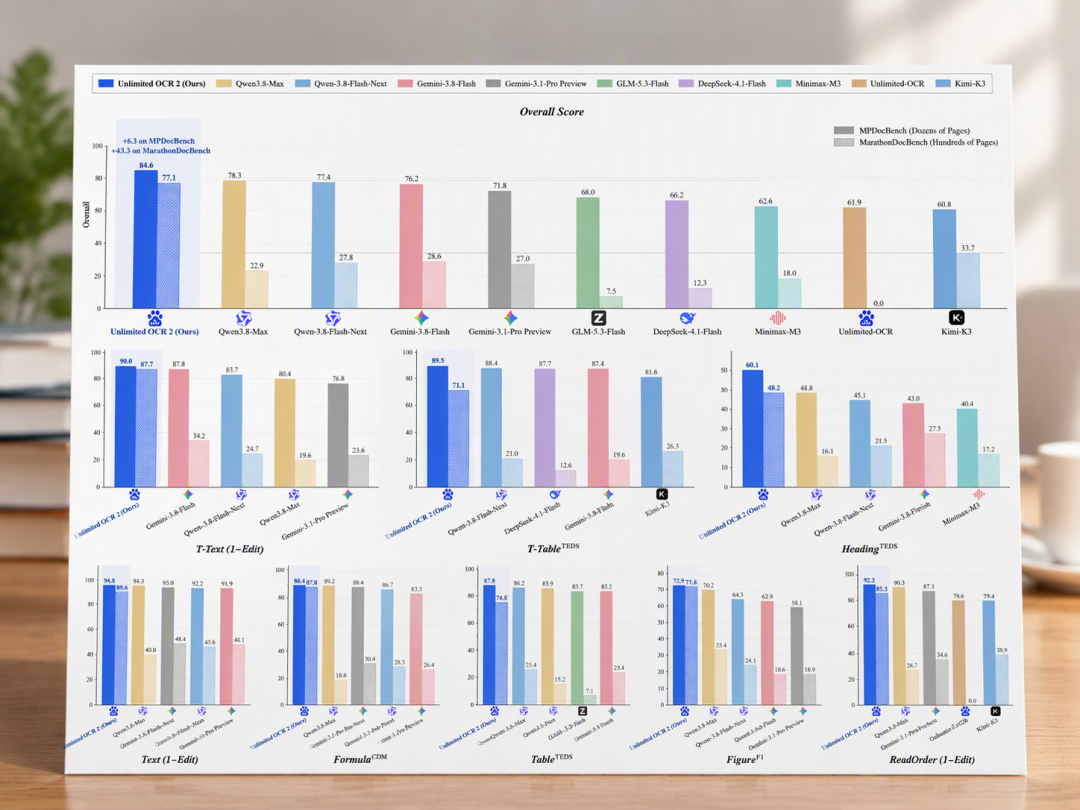
网传"84.6分超越商业大模型",出处是MPDocBench,基准最多30页,同表Qwen3.8-Max是78.3分。是领先,不是碾压。知乎
它适合谁
想把扫描书、旧教辅、合同发票数字化的人:公式转LaTeX、表格保结构、输出坐标和阅读顺序,这些是传统OCR做不到的增量。但如果你要的是"千页研报直接扔进去,出来一份完美结构化文档",建议再等等社区把坑踩完。
能读书的小模型已经送到家门口,门票(显存)得自己算清楚。