






15
10
记忆准确,不等于用户有权决定
2026-11-02 15:47:30
0点赞
0收藏
0评论
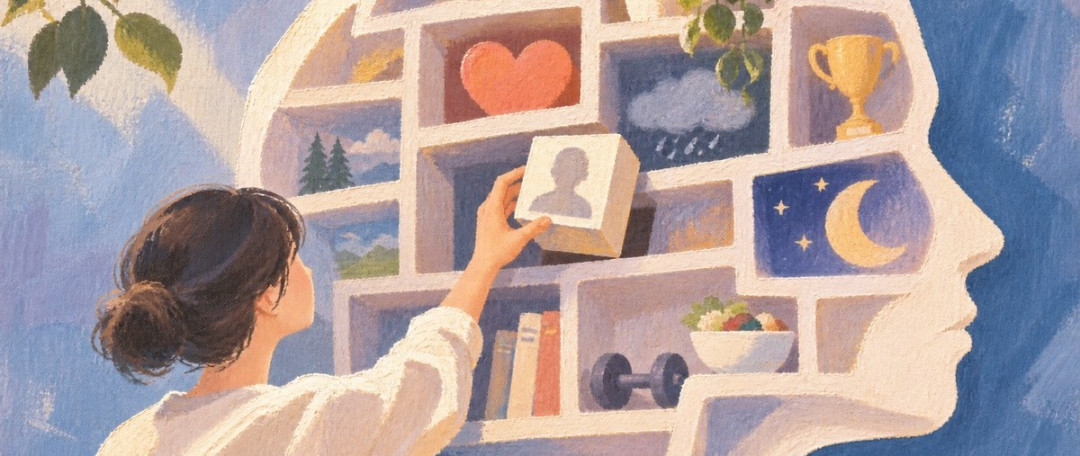
一条关于你的信息,即使完全准确,也不意味着你愿意让它长期留在聊天工具里。讨论 AI 记忆时,“有没有记错”很容易成为焦点,但另一个问题同样重要:从一次对话中挑选什么、保存什么,究竟由谁决定?
爱范儿介绍的一项研究提供了一组值得对照的数据。这项被 ACM Web Conference 2026 接收的研究,取得了 80 名真实用户的完整 ChatGPT 对话记录及系统为他们保存的记忆,涵盖 1058 段对话、2050 条记忆。研究者逐条检查相关用户指令,发现只有 4.1% 的记忆是用户明确要求保存的,其余 95.9% 由系统自行判断后写入。
这组比例需要放回研究范围内理解。研究者通过“记住”“保存”等触发词识别用户的明确要求,结果描述的是这批样本中记忆形成的方式,不能直接推广为所有用户的现状。它也不意味着系统自行保存就违反了政策:原文提到,OpenAI 的记忆文档允许 ChatGPT 保存它认为对未来对话“有用”的信息。
问题因此变得具体:系统判断“有用”,与用户决定“值得长期保留”,并不是同一件事。前者服务于后续对话的个性化,后者涉及用户愿意让哪些信息持续参与自己的画像。用户说出一件事,能够影响系统获取什么材料,却未必等于用户已经选择了哪些内容应成为长期记忆。
与此形成对照的是准确性。研究者通过字符串匹配、语义嵌入和评分等方法检查记忆来源,发现 84% 的记忆能在完整对话历史中找到直接文本依据,77% 被评为“直接陈述”或“转述总结”。因此,不能把这项研究简单理解为对系统胡乱编造用户信息的揭露。至少在这些样本中,大量记忆确实有据可查。
但准确性回答的是“这条信息从哪里来”,而非“用户是否主动选择让它留下”。即使把原话转述得十分忠实,系统仍然完成了一次筛选:将某次交流中的内容保留为未来可用的信息。本文认为,判断记忆机制是否给了用户足够控制权,需要把这两个问题分开,不能用较高的溯源比例代替对保存决定的讨论。
这种区分对推断性内容尤其重要。研究样本中,52% 的记忆包含对用户心理状态的推断,涉及欲望、意图、情绪、信念等。一次表达与一项可以反复使用的个人特征之间,存在解释的过程。有对话依据,并不自动消除用户对这种解释是否应该留存的异议。
爱范儿也提到了现有的管理入口:用户可以在 ChatGPT 设置的“个性化”中查看记忆,并修改、删除相关内容。这些功能让用户能够纠正错误、清理过时信息,或移除不愿继续保留的内容。它们有实际价值,但主要解决的是记忆形成之后如何处理的问题。
事后可以删除,与形成时能够决定,并不等价。前者让用户修正已经出现的结果,后者关注系统写入之前,用户能否对保存范围施加直接影响。这并不要求否定自动记忆的作用,也不能据此认定现有机制违规;更值得追问的是,用户除了决定“说什么”,能否更直接地决定“记什么”。记得准确是质量问题,谁来决定留下什么,则是控制权问题。