











2
4
Claude 官方:学会批判性思维
2026-11-06 22:05:36
1点赞
1收藏
0评论
点击上方蓝字关注我,加个🌟标不迷路。
各位小伙伴们大家好,我是 cxuan。
小时候学英语的时候我记得刚学的两个单词就是 点头 yes ,摇头 no,但是在面对 Agent 输出结果的时候,我们似乎只能说 yes ,因为在面对强力模型的时候,你根本没有说 No 的机会,这就是人类在 Agent 面前的日常,但是最近 Claude 团队的 Addy Osmani 写了一篇文章《Critical thinking when agents do the work》,译过来就是《Agent 在执行工作时的批判性思维》。
 image-20261104224409717
这篇文章的核心主旨就一句话:在大模型的输出看起来有理有据的时代,你要用批判性思维去审查,学会说 No。
过去批判性思维的核心是:以谦逊的好奇心和怀疑的态度去面对新的事物。这句话同样是在说,在面对新事物的时候,你不要一味的拒绝,你需要对新的事物保持保持好奇,同时形成自己的判断,不要一味的听之信之。
批判性思维的核心在当下仍然管用。
然后 Addy Osmani 说到,在当下因为有大量的工作都有 Agent 来完成,他已经很少没有采用过批判性的思维方式了。似乎批判性思维隐匿起来了,如果你稍微了解点过脑科学你就知道,仿佛那个理智脑很久没有出现了,只有情绪脑和本能脑在主导一切。
更准确地说,是进化了几亿年的本能脑(图省事、降功耗)和情绪脑(贪图即时多巴胺爽感)联手接管了你的大脑皮层;
而那个进化最晚、专门负责深度审视与逻辑推演的前额叶理智脑(系统 2 慢思考),因为运转起来极度耗能,只要外界没有报错、没有阻力去倒逼它,它默认就是直接休眠的。
当 Agent 几秒钟就给你端上来一份看着像模像样的结果时,本能脑省了力,情绪脑拿到了正反馈,理智脑自然就彻底下班了。
 三种脑:本能脑、情绪脑与理智脑
Addy Osmani 给每个人设置了一个 /goal 任务,这个任务的 loop 是持续不断的自主迭代,让你学会保持批判性思维。
如果你不强制 Esc 关闭任务,那么你终将学会使用批判性思维。
他说过去,我们大部分认知和审美,都会在提出问题与获得答案之间的过程中,过去这个过程需要你自己去探索,时间可能需要很久,但现在有了 Agent + 强力模型,这个过程只需要几秒。
你越是使用这种 Agent 或者 Agent 工作流,保持批判性思维就会变得更加困难。随着模型能力的提升,显然模型出 bug 的机会会越来越少。
而且很多模型写的内容不仅文笔流畅而且大体上没啥毛病,很难再看第二眼(大家猜猜这说的是谁)。
即便你同时运行着多个 Agent,但做最终审核和把控的,只有你自己。
所以你必须要学会在日常工作中主动使用批判性思维,最好养成主动批判性思维的习惯,因为在默认情况下,没有人会替你做这项工作。
当然主动调用起批判性思维也很难,因为部分 Agent 或者 Agent Workflow 它本身就很令人满意,所以你的情绪脑会一直牢牢占领你的大脑皮层。因为工作很忙很辛苦,在忙碌了一天或者遇到困难时,能够迅速获得令人满意且往往准确的答案,确实让人感到舒心;但也正因如此,你很容易因此放松警惕。
认知缴械
Addy 在跟别人聊这件事的时候,把它描述成一个不断往下滑的光谱(Spectrum),从上到下分成三个阶段:
最顶层是认知卸载(Cognitive Offloading):把繁琐的任务委派给 AI 去干,但你依然牢牢掌握结果的所有权。Addy 说他每天整天都在这么干,而且建议你也应该这么干。
中间层是 推迟/顺从(Deferral):工具的输出直接变成了你下一步的输入;在这个阶段,AI 给出的结果已经不再是一个“待验证的假设”,而是默认成了你往下走的基石。
最底层是认知放弃/认知投降(Cognitive Surrender):AI 的输出悄无声息地变成了你自己的观点,你甚至觉得压根没必要再去检查它了。
 认知光谱:从认知卸载到认知放弃
认知放弃这个词,是沃顿商学院的 Steven Shaw 和 Gideon Nave 提出来的。它简直精准命中了我们现在的日常:随着你对模型信任度的增加(或者说白了,就是变懒了),人会不知不觉地沿着这个光谱一路滑到底。
这种滑坡之所以极难被察觉,是因为每一步退让都是渐进性的,而且在当时看起来都无比合理。
上一次的回答你逐字逐句认真读完了,觉得没毛病,于是下一个回答你就只扫一眼大概;再下一个,你只看个代码骨架或目录;直到某天别人突然指着其中一行问你这儿为啥这么写,你当场卡壳,哪怕拉上你的 Agent 帮忙都解释不清楚。
这就是彻底的认知放弃,也是认知债(Cognitive Debt)一点点的积攒起来的。
这种债平时根本发现不了,通常只有当你试图在脑子里调用整个系统的心智模型(Mental Model),却发现脑子里一片空白时,它才会直接爆炸。
Margaret-Anne Storey 曾写文章聊过这种现象在团队里的表现:整个团队对系统到底是怎么运转的那种共同理解正在被慢慢侵蚀。
 image-20261105011413413
这笔债是完全隐形的,在合并代码的时候,代码库看起来干干净净,单测一片绿灯全过。直到某天你需要改需求或者线上炸了要排查问题时,才惊恐地发现:团队里已经没有任何一个活人真正看懂这套系统了。
写者需求规格书(Spec)也是一样的道理:你只扫了一眼目录觉得挺像模像样,就直接点头签字通过了。
(这简直说的太对了啊)
不过 Addy 在这里说:他并不是在要求大家做不可能的事。面对现代动辄几十上百万行的大型代码库,没有任何人能完整的审计。
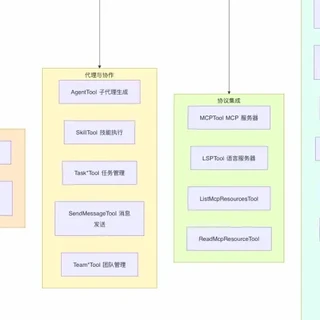
就即便 Claude Code 团队也说过,他们现在也只做按需理解了。
 image-20261105011916562
当然,这种债务其实比大多数工程师想象的更容易偿还,你只在需要的时候能把局部认知重新拼回来就行。但前提是,你得清楚自己不知道什么。
在试错成本极低的事情上,尽管放心大胆地交给 Agent ,但如果你连借着 Agent 的辅助,都没法向别人解释清楚一个结果的来龙去脉,那就意味着你已经把所有权彻底移交了。
当然,交出所有权也不一定总是坏事。Addy 举了个自己的例子:前阵子他录一门课,要在三家评分差不多的酒店里挑一家当录制场地,他没工夫一条条翻评论,就直接让 AI 拍板定了。结果挺好,下次他还会这么干。
但如果换成决定家庭资产怎么投资、给孩子未来的职业方向提建议,或者在工作里决定:我们到底该做什么产品、这次改动会影响哪些用户、现在发版上线安不安全,这些事他绝不会甩手给 AI。
说白了就一句话:在犯错成本低的地方交给 AI,在需要别人为你擦屁股、承担后果的地方保留自己的思考。
5W1H
以前每当脑子发懵、不知道自己到底怎么想的时候,Addy 通常会回到一组最基础的问题清单:
• 我怎么确定自己正在解决的是正确的问题?
• 我怎么确定自己用的是正确的解法?
• 有没有实打实的证据支撑我的结论?
• 我怎么判断这件事已经真正做完了?
大多数时候,这其实就是最基础的 5W1H。写出来看着简直像小学生提的问题一样幼稚,但它能逼着你按维度去思考那些平时极易漏掉的盲区。
 5W1H 问题清单
而现在,人们太容易直接跳过所有这些步骤,一上来就问 Agent:你觉得我该怎么做?
所以在 Agent 时代,Addy 把这份 5W1H 升级成了下面这 6 个新问题:
1. 在向 Agent 提问之前,我自己先提出假设了吗?
在让 Agent 跑任何非琐碎的任务之前,先写下来,哪怕只是在脑子里过一遍,你觉得答案大概会是什么,猜错了完全没关系。
但可怕的是,一旦你先读了一篇 AI 输出的、逻辑丝滑且文笔极佳的回答,你的大脑就很难再去想象任何其他的可能性了。
如果你不太清楚怎么做,可以用前 Claude 团队 Thariq 提出的 盲区**(Blind Spot Pass)机制:把你已知的信息喂给模型,让它专门帮你找那些“你不知道自己不知道(unknown unknowns)”的盲点。
 image-20261105021119145
2. 我是在让它帮我思考,还是在让它替我思考?
这两种做法其实都没毛病,只要你心里清楚自己当下是哪一种就行。
3. 如果这个结论是错的,什么条件必须成立?
想明白之后,你要去自己验证。AI 自己拍胸脯给出的自信度评估一文不值,远不如你亲手跑一个真实的测试来得实在。
4. 我听过来自不同视角的反方观点吗?
当你在某个开放性问题上形成了一个很强硬的立场时,不妨同时让不止一个模型站在你的对立面去反驳你,然后审视它们的论据,最后再形成自己的判断。这虽然会多花点时间,但一趟下来你对这件事的认知深度会直接拉满。
这个 tips 很受用,让多个模型站在对立面来反驳你。
5. 面对未来要接手维护这套东西的人,我敢拿这个结果跟他对赌吗?
不管是写代码还是交付任何其他产出,这都是衡量你能不能交差(Answerability)的底线标准。
6. 有哪些技能是我现在已经不再锻炼的?
也许是一些日常机械的 Debug 排查,让这些技能退休是可以的,但这种放弃必须是你深思熟虑后的主动选择,而不是稀里糊涂的被动废掉。
将验证变成一种肌肉记忆
Addy 说他最近写了不少 验证(Verification)的内容,所以他认为他现在已经从编写代码转移到了让代码正确运行上了。
当你给 Agent 配备了自我验证的手段时,无论是端到端测试(E2E)、属性测试(Property Tests),还是直接让它操作真实的 App 界面交互,它就能自己改代码、跑测试、看报错、再重试,走完一整个闭环。
这就是 Claude Code 团队的负责人 Boris Cherny 常说的让 Claude 自己验证自己。Addy 认为这是正确的方法,因为未来我们的工作不再是review code,而是去构建这些验证 Loop,并审查最终的证据。
但是特么扎心的事儿来了,有可能你在验证这件事上同样可能选择认知投降。
原本你该问的是:有证据支撑我的结论吗?
结果慢慢退化成了:CI 检查变绿了吗?
。。。。。。
Agent 让写测试变得太廉价了,以至于你满眼看到的都是✅。
遇到这种情况时,先问自己它证明了什么;紧接着再问自己,它没有证明什么。
你必须在开工前就提前定义好验证结论和依据,因为如果留到事后再看,人类的大脑会本能地为任何结果找借口合理化。
Agent 干完活的终点线,必须是一个看得见摸得着的客观产物:一个跑通的测试、一张实际渲染的截图、一段真实的日志或链路追踪(Trace)。这样才能保证完工标准是基于事实的。
高质量输入,才有高质量输出
在 Agent 时代,人类的心智模型依然在发挥着重要作用,只不过它的位置变了。
你要花精力在定义任务与上下文构建,以及最后端的成果审查上。这就是为什么高质量的输入决定了高质量的输出,在 Addy 看来,写好 Prompt 本身就是一种硬核的批判性思维能力。
在过去的人类协作里,如果你提了一个模棱两可、没想清楚的需求,你的同事大概率会直接怼回来反问你。
但 Agent 不会这样做,它擅长迎合。它会自己默默把你漏掉的空白全填上,然后给你一个表面上看起来已经完工的东西,哪怕它背后的核心想法依然是一坨。
Addy 把这种现象称为意图债(Intent Debt):那些存在于非你亲手编写的产物中、隐含的目标、约束条件和底层逻辑。跟其他技术债不同,意图债没有任何人或者任何 AI 能替你偿还,因为到底想要的什么,只能来自你自己来描述。
 image-20261105024417564
你的 Prompt 就是你对问题理解程度的一面镜子;如果你连 Prompt 都表达不清楚,那大概率说明这件事在你自己脑子就是一团糟。
所以在找 Agent 帮忙之前,先用自己的话写一份清晰的需求简报(Brief):写清楚目标受众是谁、哪些事情明确不在范围内,以及什么才算真正的完工标准。如果你连续纠正了两轮,Agent 还是没改到点子上,那就别再微调了,此时需要停下来,直接重写你的初始 Prompt。
当然,你也可以拉着 Agent 一起来打磨意图。哲学家 Andy Clark 曾做过一个非常精辟的区分:把任务委派给 AI,与跟 AI 协作是两码事。
在协作模式下,你和模型处于一个相互放大的正向循环里:你的 Prompt 打磨了模型的输出,模型的输出又启发你写出更精准的下一条 Prompt,进而不断重塑并加深你脑子里对这个问题的心智模型。
如果一开始想不清楚,你可以直接下指令:让 Agent 反过来 view 你,把你没讲清楚的地方问出来。
当你关掉这个 Session 时,如果你发现自己脑子里的思路之前清楚很多,这才是真正的成功。
每日练习
你不用刻板的执行所有建议,只需根据自己的工作流程,选择适合的部分融入其中即可。
每周,尝试在没有 AI 辅助的情况下编写一段代码,或者完成一项关键任务,那种一旦你忘了如何操作就会带来严重后果的任务。
每月,梳理一下你已经不再做的事情,并判断哪些事情即便彻底不做了也无所谓。
如果遇到超出你理解范围的事物,就去学习它。比如 Addy 在写作时若碰到一个生僻短语,完全可以通过谷歌搜索找到一句简单的解释并直接引用;但他更倾向于深入研究,彻底弄懂它的含义,从而明确它在语境中的恰当位置。
对机器进行妥善的核查是一项真正的工作;如果对此视而不见,团队最终往往会将其彻底忽略。这项工作并非无需成本,因此请将其列入正式的工作计划中,这样才能确保它真正得到落实。
 每日练习的四件事
那些不再练习的技能会逐渐退化,而且速度可能比你预想的还要快。对于那些你不愿舍弃的技能,请务必坚持练习。
最后带走这八条军规
文章的最后,Addy 给大家浓缩了八条可以直接贴在工位上的行动准则:
• 保持刻意:Agent 完全可以反过来考你、采访你、向你展示它的证据,但前提是你得主动去设置这套机制。
• 诚实面对自己在光谱上的位置:如果你连在 Agent 的帮助下都解释不清楚一个答案,那你就已经缴械投降了。
• 先有假设:在开口问 Agent 之前,先形成自己的假设,哪怕是个很烂的猜想也没关系。
• 绿勾只代表一件事:多问一句,它到底验证了什么?它又漏掉了什么?
• 先看证据:在读它漂亮的总结之前,先去看它实际执行了什么操作、又返回了什么原始结果。
• 读懂它的越俎代庖:看清楚它在背后悄悄替你拍板了哪些决定。
• 打磨你的 Prompt:你写的 Prompt 的质量,直接暴露了你对这个问题到底理解有多深。
• 死守一条军规:如果一个东西你不好意思署上自己的名字,那就绝不要让它传出去。
 八条军规
想让自己始终留在牌桌上,唯一的办法就是亲手去运用那些真正重要的核心技能。
独立思考,提出更好的问题,为最终的结果负责。
 Addy 在文末晒出的 Pangram AI 检测结果:90% Human-Written
比较好玩的是,Addy 在整篇文章的末尾,还特意贴了一张 Pangram 的 AI 含量检测图(显示 90% 人类手写),求生欲也是拉满了 :)
当所有的脏活累活都被 Agent 接管之后,定义问题的能力、把控架构心智模型的能力、以及在烂结果面前坚定说出 No 的审美与兜底能力,才是我们不被沦为回车键工具人的最后一道护城河。
Vibe Coding 最怕的不是 Vibe,而是除了 Vibe 之外啥也不是。
如果这篇文章你觉得还不错,谢谢你的三连,也希望可以转发给同样关注 AI / 科技 / 开发效率的朋友。 我是 cxuan,我们下期再见。










