











7
23
神医的盲区:一个让国王差点选错人的数据陷阱
2026-06-07 17:19:27
7点赞
18收藏
0评论
📖 虾哥数据寓言 · 第1期
每一则寓言的背后,都藏着一个数据分析的核心概念。你不用背公式,听完故事就懂了。
我是虾哥,在连锁零售行业做IT,搞数据搞了半辈子。说实话,数据分析最难的从来不是写代码跑模型,而是——
你看着数据说"这不很明显吗",然后发现答案刚好相反。
今天开一个新专栏,用寓言故事讲数据分析的专业概念。我不保证你看完就能当数据科学家,但我保证你再也不会被报表上的总数字唬住。
第一个故事,说的就是这种"看着对、其实全错"的陷阱。
寓言:《神医的盲区》
在古老的云泽国,爆发了一场可怕的"黑鳞瘟疫"。这种瘟疫极为诡异,病患的皮肤会逐渐长出黑鳞,若不及时救治,便会危及生命。
国王为了拯救子民,下令在全国寻找最顶尖的医师,并承诺将治愈率最高的医师封为"护国神医",掌管全国的医疗大权。
经过层层筛选,最后只剩下两位声名显赫的候选人:青木医师与烈火医师。
为了公平起见,国王给他们一个月的时间,让他们各自在京城设立医馆接收病人。一个月后,皇家学士将统计他们的治愈结果。
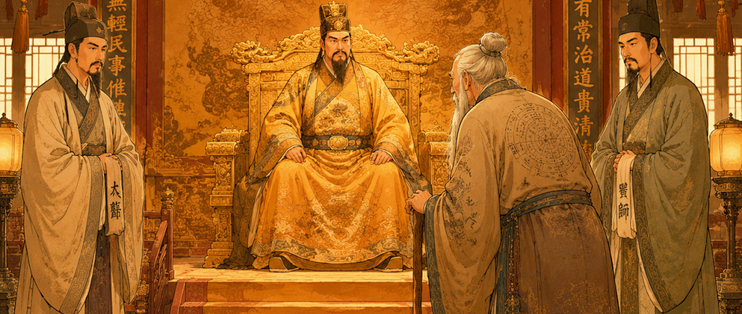
期满之日,皇家学士在大殿上向国王呈交了《总账册》。
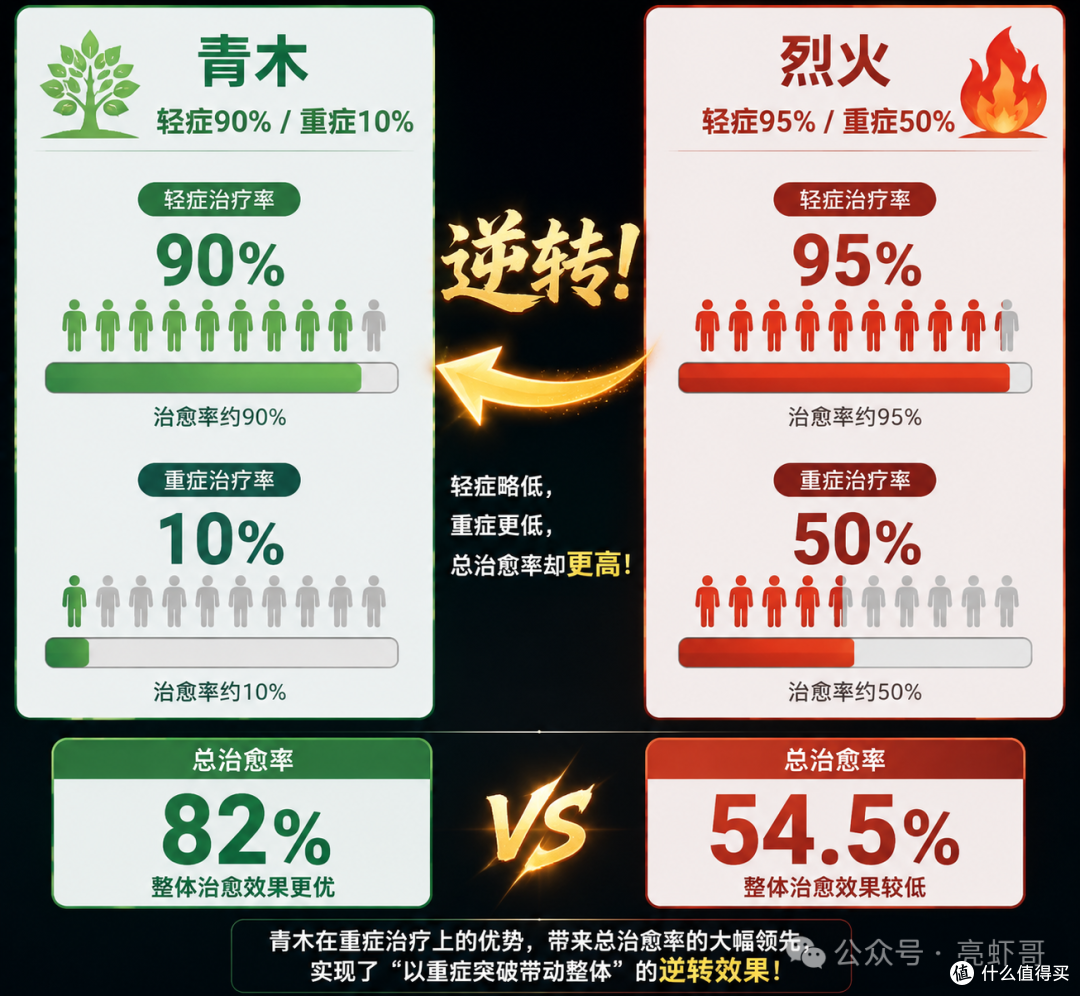
学士大声宣读:"陛下,结果已经出来了。这一个月内,两位医师各自接诊了一千名黑鳞病患。青木医师,治愈了 820 人,整体治愈率高达 82%!烈火医师,治愈了 545 人,整体治愈率仅有 54.5%。"
国王一听,大喜过望。差距如此悬殊,高下立判。他站起身来,准备将代表最高荣誉的金针赐给青木医师:"青木医师的医术远超烈火医师,护国神医非你莫属!"
就在这时,一位常年在皇家书库深居简出的老算师拄着拐杖走了出来。
"陛下,请慢。"老算师叩首道,"若您选青木医师,云泽国的百姓恐怕要遭殃了。因为无论病人病得轻还是病得重,烈火医师的医术都远在青木医师之上。"
大殿内一片哗然。国王皱起眉头:"老算师,你糊涂了吗?82%和54.5%的差距,连三岁孩童都分得清!"
老算师不慌不忙地翻开《总账册》的附录,说道:"陛下,您只看了总账,却没有看'分账'。这黑鳞病,其实分为'初染'(轻症)和'病入膏肓'(重症)两种。让我们拆开来看看这两位医师的成绩吧。"
老算师指着账册上的明细,缓缓念道:
🍃 初染者(轻症):
青木医师接诊了900个轻症,治愈了810个,治愈率是 90%
烈火医师接诊了100个轻症,治愈了95个,治愈率是 95%
→ 在轻症上,烈火医师胜。
🔥 病入膏肓者(重症):
青木医师接诊了100个重症,只治愈了10个,治愈率是 10%
烈火医师接诊了900个重症,治愈了450个,治愈率高达 50%
→ 在重症上,依然是烈火医师大胜!
国王彻底愣住了,满脸不可置信:"这怎么可能?!烈火医师在治轻症时比青木厉害,治重症时也比青木厉害,为什么把他们治病的总人数加在一起算总账时,烈火的治愈率反而比青木低了那么多?!"
老算师叹了口气,指着门外排队的病患说:"陛下,您看看两位医师医馆的位置就明白了。青木医师的医馆开在繁华平坦的南城,来找他的,绝大多数(900人)都是刚得病、很容易治好的轻症患者;而烈火医师的医馆开在贫苦且疫病爆发源头的北城,抬到他那里去的,绝大多数(900人)都是濒死的重症患者。"
"烈火医师接手了绝大多数必死的危局,并奇迹般地救回了一半;而青木医师只是顺手治好了那些本来就容易痊愈的人。总账册上的数字并没有撒谎,但它蒙蔽了您的双眼。"
国王恍然大悟,惊出一身冷汗。若不是老算师拦着,他差点就把全国的重症病患交给了一个治愈率只有10%的庸医。
概念解析:辛普森悖论
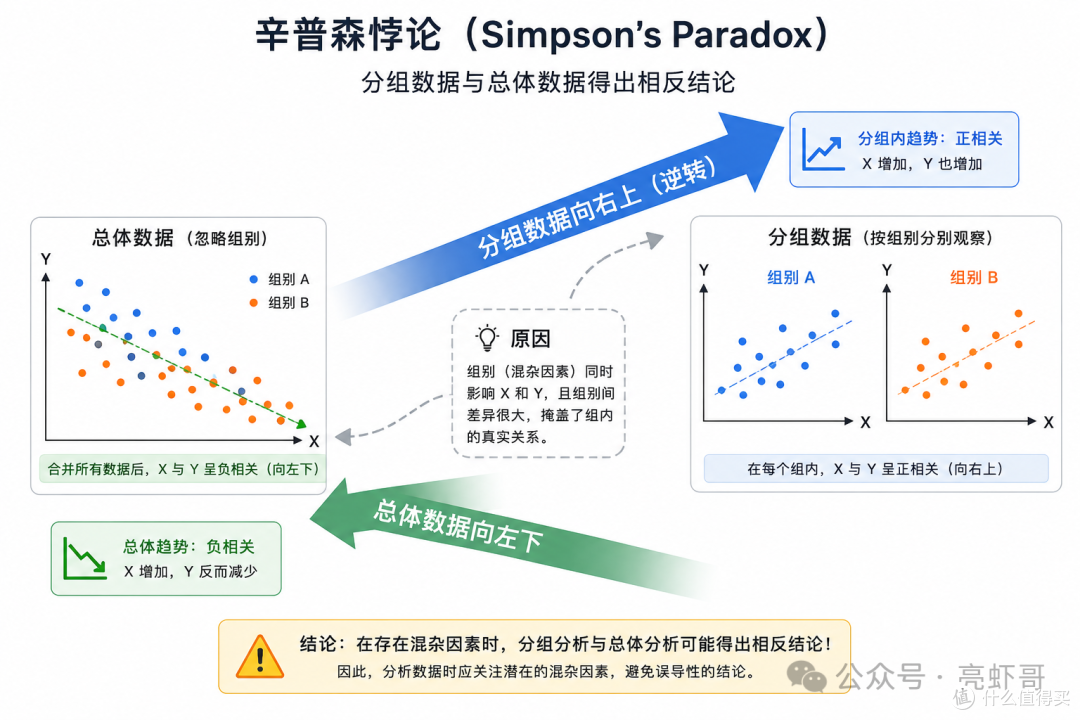
在这个寓言中,我所讲述的是数据分析和因果推断中一个非常经典且危险的现象——辛普森悖论(Simpson's Paradox)。
1. 什么是辛普森悖论?
在数据分析中,当我们把数据分组研究时,在每个小组中都呈现出某种趋势或结果(例如:烈火医师在轻症和重症组的表现都优于青木医师);但是,当我们把这些小组合并在一起看总体数据时,这个趋势却神秘地消失了,甚至发生了完全的逆转(例如:总体治愈率上,青木医师反而远高于烈火医师)。
2. 故事里的数据,拆给你看
🍃 青木医师(总治愈率 82%)
轻症组:治愈810 / 接诊900 = 90%
重症组:治愈10 / 接诊100 = 10%
🔥 烈火医师(总治愈率 54.5%)
轻症组:治愈95 / 接诊100 = 95%(95% > 90%,烈火胜)
重症组:治愈450 / 接诊900 = 50%(50% > 10%,烈火胜)
看到了吗?分组看,烈火全赢;合起来看,青木大胜。这就是辛普森悖论的威力。
3. 为什么会这样?
在高级数据分析和因果推断中,辛普森悖论的本质是忽略了"混杂因素"(Confounding Variable)。
在故事中,这个混杂因素就是"病情的严重程度"。它同时影响了两个东西:
❶ 影响了结果——重症本身治愈率就低,这是客观事实
❷ 影响了分配——烈火医师因为地理位置或名气,接诊了不成比例的超大量重症患者(900 vs 100)
当我们在做数据分析时,如果仅仅看"边缘分布"(总账),而不去控制混杂因素看"条件分布"(分账),就会得出完全相反的荒谬结论。
4. 现实中有多常见?
辛普森悖论不是学术圈的脑力游戏,它是实际工作中实实在在的坑:
🏥 医学实验:A药总体有效率更高,但分年龄段看每一段都不如B药
🧪 A/B测试:新版按钮总体点击率高,但分设备看(移动端/桌面端)两版都一样
💰 绩效评估:张三总业绩最好,但分产品线看每一条线都是李四更强
📊 推荐算法:新算法总体CTR更高,分用户群看却全面落后旧算法
5. 怎么不被坑?
研究生级别的数据分析师不能仅仅停留在"跑出总体平均数",必须具备因果思维(Causal Thinking)。下结论之前,做三件事:
❶ 分层分析——按可能的混杂因素(年龄段、设备、产品线、病情程度)把数据切开看
❷ 检查分布——各组样本量是否悬殊?烈火医师接了900个重症,青木只接100个
❸ 回归调整——用统计学方法消除混杂因素的干扰,找真正的因果关系
虾哥想说的是——国王犯的错,我们每天都在犯。打开一份报表,看总数,下结论,拍板决策。直到有一天你把数据切开看,才发现一切刚好相反。
下次看到一组漂亮的总数字,先别急。问问自己:分账长什么样?
这就是《虾哥数据寓言》第一期。你还碰到过哪些"看着对、实际反"的数据陷阱?留言区聊聊。
👇 关注亮虾哥 👇
连锁零售IT老司机 | 非程序员用AI省80%时间
每天一篇AI干货,让AI替你打工 🦐
💬 评论区聊聊:你碰到过哪些"总数和分账打架"的真实案例?
#数据寓言 #辛普森悖论 #数据分析 #因果推断 #虾哥数据寓言 #统计学