

这周知乎上有道题被刷了上来:「AI编程生成的代码能运行,就说明它正确吗?」评论区里,前端开发者韩亦冰讲了自己的真事:他用AI重写了一个跑了两年的管理后台,开发6小时,验收花了一天半——验货的时间比造货还长了近三倍。他一度想退回逐行审代码的老路,后来换了一套打法,验收时间直接砍半。知乎
这不是个例。「产出速度大幅提升,审查和测试没跟上,团队协作怎么办?」「AI写前端,你是怎么审核验收的?」11月的知乎上这类问题扎堆冒出来,都指向同一件事:AI编程的瓶颈,已经从"写"挪到了"验"。知乎
为什么人肉审不管用?答主"蓝鲸加速"举了个经典例子:让AI写折扣函数 `price * discount`,跑通了,命名规范,注释齐全,还自带测试。可需求里的 discount 是优惠比例,不是折后系数——逻辑自洽,业务全错。更麻烦的是,代码是AI写的、测试也是AI写的,两边共享同一个错误假设,测试反而成了错处的帮凶。韩亦冰那句话很扎心:AI的"对"是统计意义上的对,你的眼睛只能看出风格问题。知乎知乎知乎
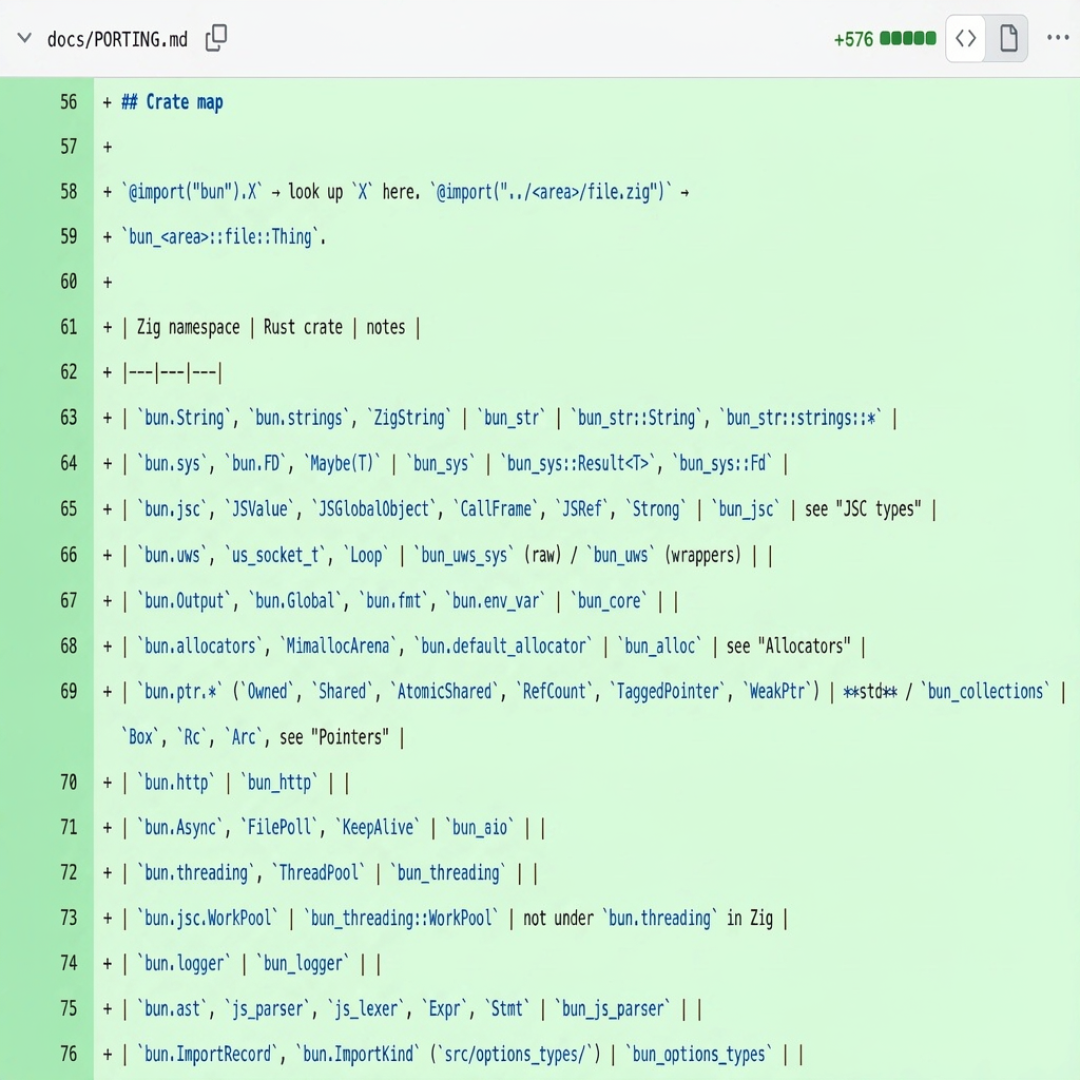
那"官方"是怎么干的?知乎用户Feisky转述了Anthropic工程师Addy Osmani的博客:Claude Code团队内部,约90%的代码由Claude编写和审查。他们的结论:单元测试可能全绿但功能照样坏,真正管用的是端到端验证——让Agent把改完的应用实际跑起来,走一遍"注册、加购物车、结账"的真实流程,挂了就给出轨迹、截图和原因。在其结构化文件生成测试里,加一个独立评分器对照标准检查产出,任务成功率最多提高10个百分点。验证之前一个人顶多盯一两个Agent,闭环搭起来后,才敢并行跑几十个。知乎
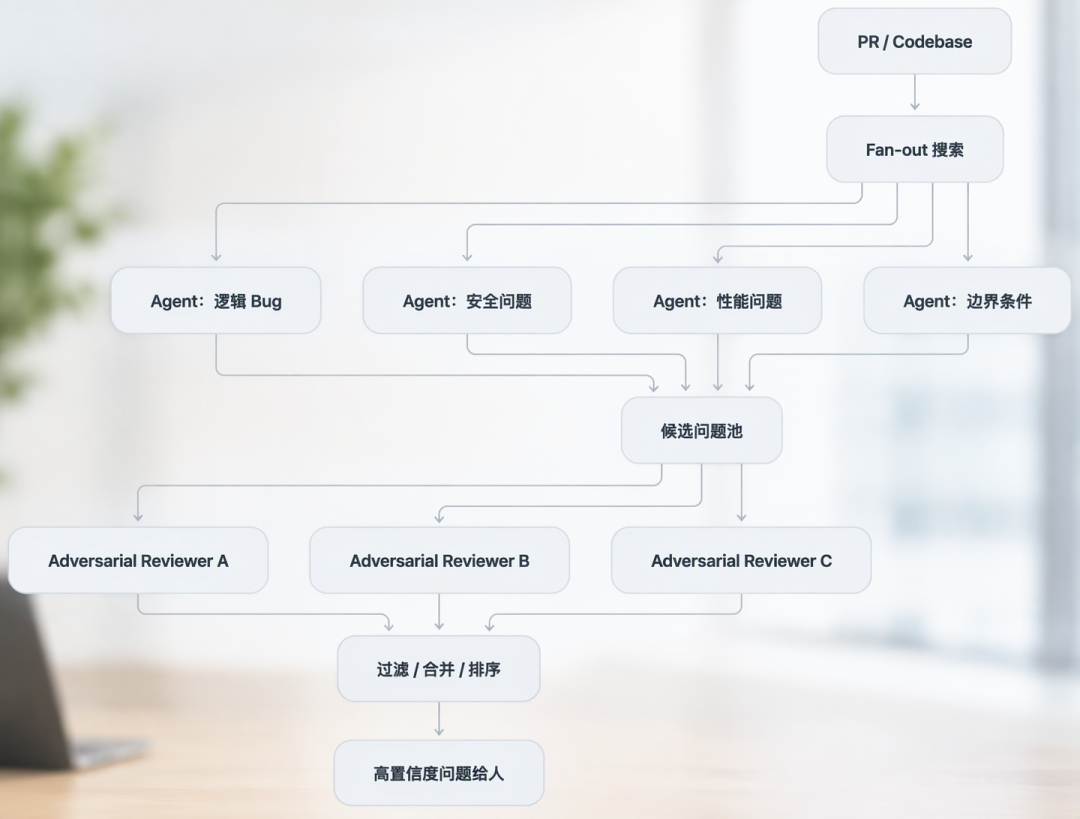
他们的几条工程规矩,直接抄就行:
别让代码改动审它的规则:审查规则只从基础分支读取,当前PR里的版本一律不作数;
修3轮还不过就停下来找人,严禁加 `sleep` 或"重跑直到通过";
用属性测试和差分测试补盲区:fast-check、Hypothesis自动生成几千组随机输入找反例;新旧系统喂同一批输入,diff出差异就是新bug;
规则定期瘦身:39个历史故障条目做成按diff触发的清单,而md文档越堆,模型越容易漏掉关键约束。
个人开发者也有自己的"验收流水线"。韩亦冰的三层打法:契约先行——先让AI写出页面状态清单(默认态、空态、加载、报错、边界值),审清单不看代码;状态机走查——照着清单点组合分支,AI爱错的都藏在状态组合里;盯指标——首屏、掉帧、包体积,代码质量可以伪装,数字不能。知乎
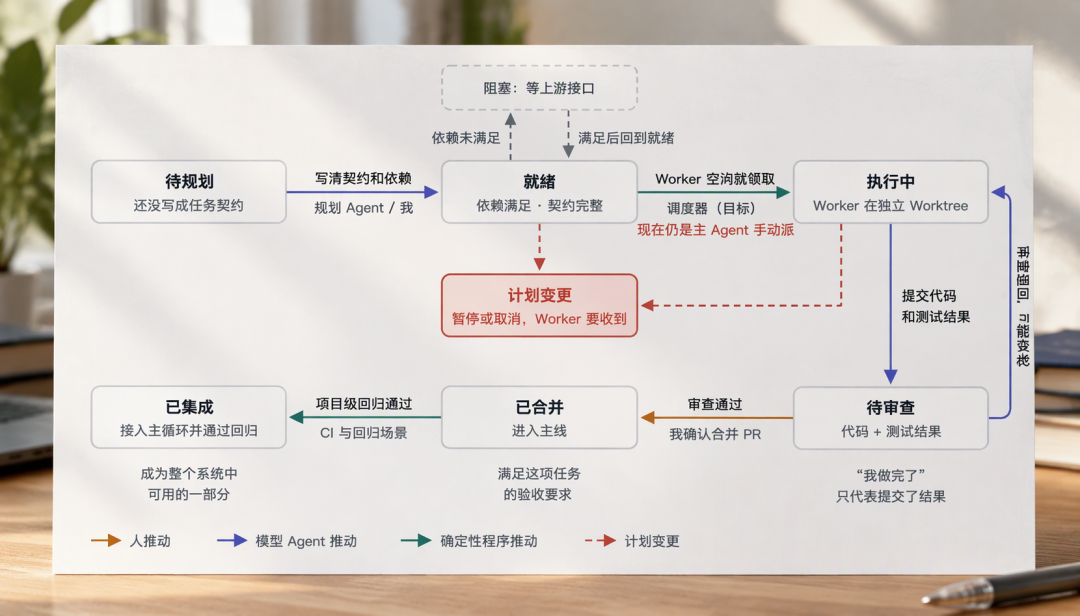
AI编程的乐趣已经换了地方:从写代码,变成定义"什么叫做完"。你的位置早就从打字员变成了质检员——而质检,从来不是把代码读得更多,是把"读"这件事做成机器。

当前文章无评论,是时候发表评论了