

最近"非技术出身、用几个月在家搭起AI集群"的话题又火了一轮。这类案例传递的第一个真实信号是:自建本地大模型的入门坎已经降到一键级——LM Studio、Ollama 这类图形工具,不会命令行的人也能把模型跑起来。真正拦住人、也真正吃掉"3个月"的,是后面四道坎:硬件账算不清、能跑不等于能干、集群搭得起养不起、以及这笔钱花得到底值不值。
坎一:显存决定装得下什么,带宽决定跑多快
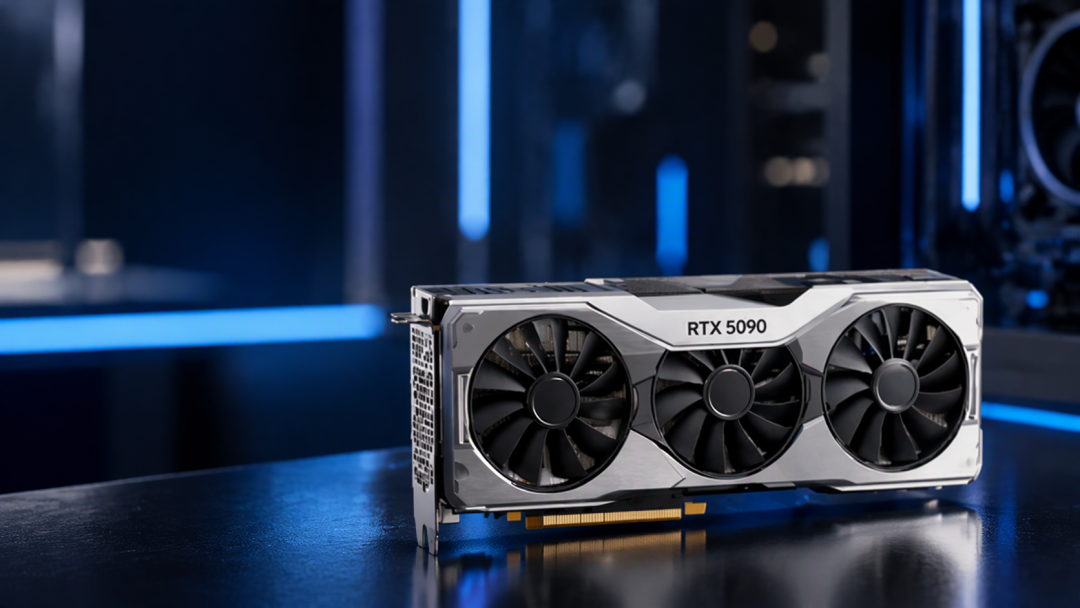
本地部署的第一笔账是容量账。以当前主流的千问系列为例,9B 量化版 8G 显存可以跑但很勉强,16G 才算舒服;27B 需要 24G 显存起步,量化后的模型文件就有 18G 左右;72B 量化版接近 40G,单张消费级显卡做不到,必须上多卡或 48G、96G 专业卡。有个粗略估法:可用显存减 3GB 再除以 0.6,约等于 Q4 量化下能塞进去的最大参数量。知乎知乎
装得下不等于跑得动。速度由带宽决定,这正是"大内存机器"最容易踩的坑:统一内存设备能把大模型装进去,但内存带宽远不如显存带宽,标称算力很强的迷你工作站,跑 27B 模型输出也就约 13 token/s。知乎
同理,AMD 显卡显存大而便宜,但主流推理框架都为英伟达 CUDA 优化,ROCm 生态本质上是在做"兼容性翻译",硬件性能要打八折。把旧卡显存颗粒加大的"魔改卡",则要接受无官方保修和品控风险。知乎
坎二:模型和上下文抢同一份显存,“能用"不等于"能干”
教程教你把模型跑起来,工作会逼你解决另一半问题。家用显卡上,模型权重和上下文共享有限显存:模型选大一点,留给上下文的空间就少;上下文开长一点,就得换小模型或进一步降低量化精度。知乎
单轮问答里"挺快"的体验,接到智能体工作流上就变了。一旦模型溢出到内存、输出掉到个位数 token/s,连续多步调用的任务基本不可用。有人用本地 27B 模型写长篇小说,实测出现"写到后面忘了前面、文风崩了"等问题,最后把复杂任务交回云端,本地只留隐私场景和简单活。知乎知乎知乎
坎三:装模型只占一成工作量,集群是"养"出来的
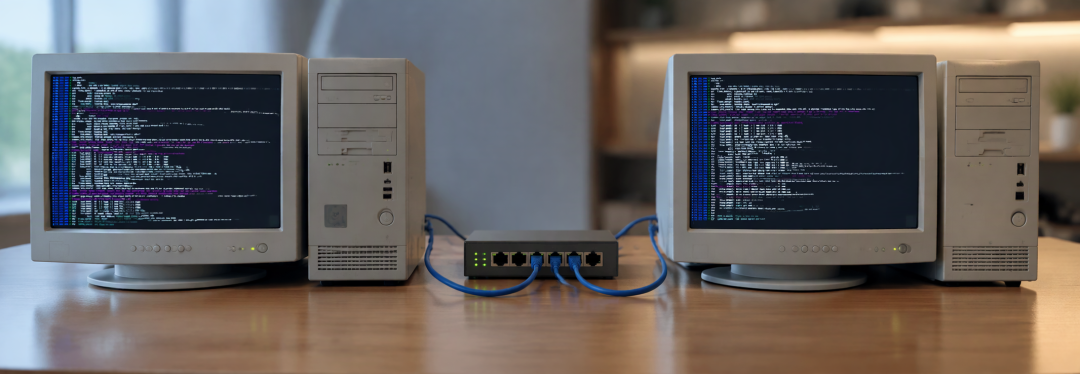
想搭"集群",先要过主板这关:受 PCIe 通道数、插槽位置和显卡厚度限制,双卡基本就是家用装机的实际上限。但有一条零成本路线被反复验证:llama.cpp 的 RPC 模式能把闲置旧电脑、NAS、旧笔记本按层切开拼成分布式推理集群,不需要 Docker 和 Kubernetes,两个 exe、一条命令就能跑起来,双机实测比单机快约 1.5-2 倍,瓶颈从显存转移到内存,而层间传输的中间结果只有几 MB,千兆局域网完全够用。知乎知乎
真正难的是"给多人用"。一份完整的团队落地复盘给出的比例很扎眼:装模型大概只占一成工作量,剩下九成是工程——一人一把 key 不然不知道谁把机器跑满、限配额不然一个人写死循环全员陪葬、并发上限必须按实测值设。知乎
实测数据比结论更直白:并发开到 8 是吞吐峰值,再加码吞吐反而下降、所有人一起被拖慢;三个模型同时打满时,最弱的那路吞吐直接掉七成。家用环境还有一对天然矛盾:这类主机轻载 100W 起、重载接近 1000W,关机省电,但下次用又要开机、加载模型,而搭助手图的就是随时待命。知乎知乎
坎四:电费加折旧,跑不跑得赢 token 套餐
折腾完硬件和工程,最后是经济账。判断标准可以很朴素:电价加折旧比云端 token 套餐便宜,本地部署才算成立。2026 年的新变化是,这条线在消费级硬件上确实开始成立——顶配开源 MoE 模型量化后,实测能力约在国产云模型前五名,电费也已低于 token 套餐。知乎
但另一面同样真实:两台迷你算力盒子的价位在 7-8 万元,大内存旗舰机接近十万。一次性投入大、日常利用率低、维护自己来,对多数人仍是"买得起马配不起鞍"。知乎
所以非技术出身者真正该抄的作业,不是某台神机配置单,而是顺序:先用现有电脑跑通一个小模型,认真用两个星期,确认常用且任务简单,再决定是否掏钱——先买设备后培养习惯,是绝大多数人浪费钱的起点。适合自建的场景其实很窄:数据不能出本地、高频次轻量任务、离线环境,三条占一条以上才值得迈这四道坎;否则云端 API 依然是更理性的默认选项。知乎
当前文章无评论,是时候发表评论了