

11月21日,一条 Reddit 帖子被多家科技媒体转述后冲上热榜:律师 u/TumbleweedNew6515 晒出自己的私人 AI 服务器,用 12 张二手英伟达显卡搭建本地推理服务器、整套设备花费约 9450 美元(约合人民币 6.3 万元),成功运行 DeepSeek-V4.1-Flash。他自述单代码流生成速度可达 157-184 tok/s,读取 128K 文件仅需 28 秒,成绩快过任何已发布的 4 台 DGX Spark 堆栈,价格却只有一半。这条热榜要回答的核心问题可以一句话说清:2017 年发布、早已从数据中心退役的“古董”计算卡,如今确实能跑起满足一位真实执业需求的本地大模型,而且整机门槛只有 6.3 万元上下。IT之家搜狐千里眼微博
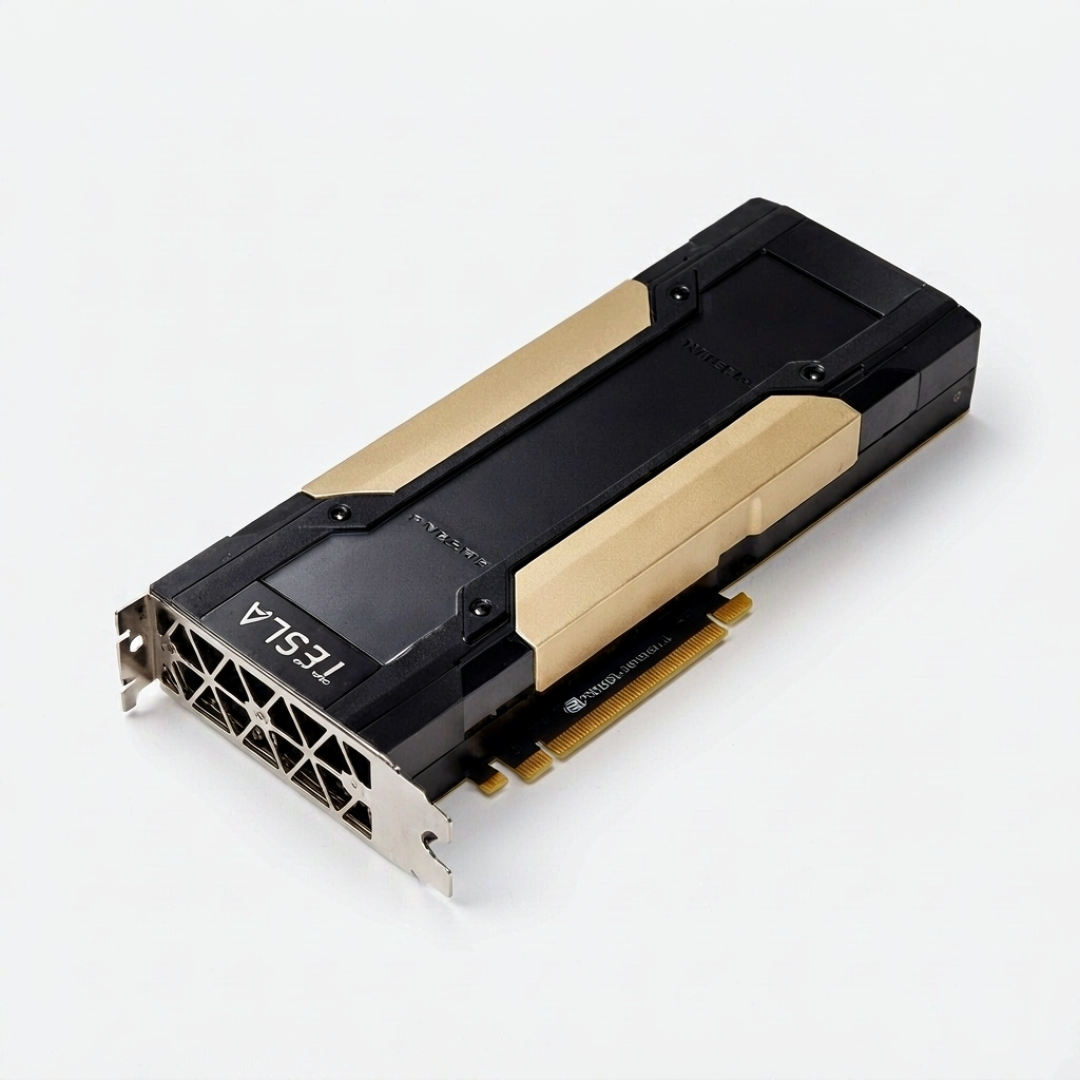
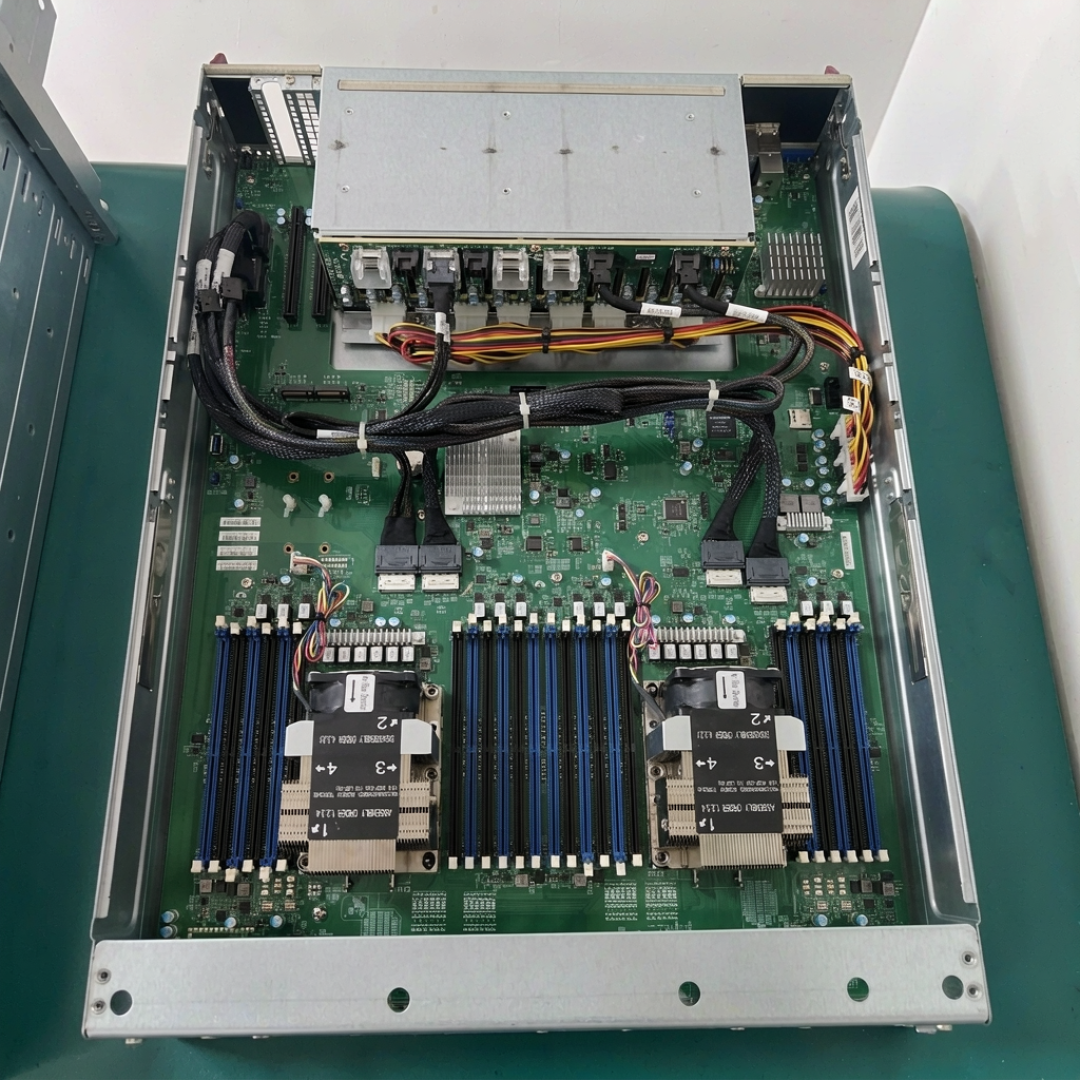
先看清这台机器的构造和数据边界。12 张卡是 Tesla V100 SXM2 32GB,通过 NVLink 与 PCIe 组成可协同推理的集群。显存合计 384GB,这是它能装下大模型的原因;需要留心的是,157-184 tok/s 绑定的是 “单请求、单流” 场景,而且发帖人自己也承认噪音较大、不太适合普通办公环境。换句话说,最高每秒 184 个词元是“一个人排队用”的速度,不是全所并发的产能。人工智能与科学搜狐千里眼
热榜词条里真正值钱的关键词其实是“律师”。知乎上的相关讨论指出了美国法律体系的一个要害:民事诉讼开庭前有很长的证据开示过程,直接把案卷发给第三方 AI 云端,可能被判定为对外披露保密材料、丧失律师客户特权。也就是说,你让 AI“排查案卷弱点”的记录,可能顺着程序进入法庭视野。知乎
国内虽然没有证据开示制度,但《律师法》第四十八条对泄露商业秘密或个人隐私有明确罚则,最高可停止执业数月。圈内流传的《关于律师使用人工智能(AI)辅助执业操作指引(2026)(试行)》,也把防范潜在执业风险、保障当事人合法权益写进目的条款。技术层面还有一个更直白的判断:数据只要传到别人的机房,内容合规审查就必然会在后台扫描文本。对律师来说,“断网运行”不是极客浪漫,是职业约束。Syunin疯哥说法来自皇后区的小子
成本端同样能算开账。国内二手市场上,商家给 Tesla V100-PCIE-32GB 报出的成交价是 ¥3,099 一台。闲鱼上二手 V100 的普遍价位也就几千块,多是机房淘汰下来的“洋垃圾”。卡不值钱,值钱的是把 12 张卡连成一台能推理的整机——机箱、转接、供电、组网,这才是 9450 美元账单里的大头。小红书知乎
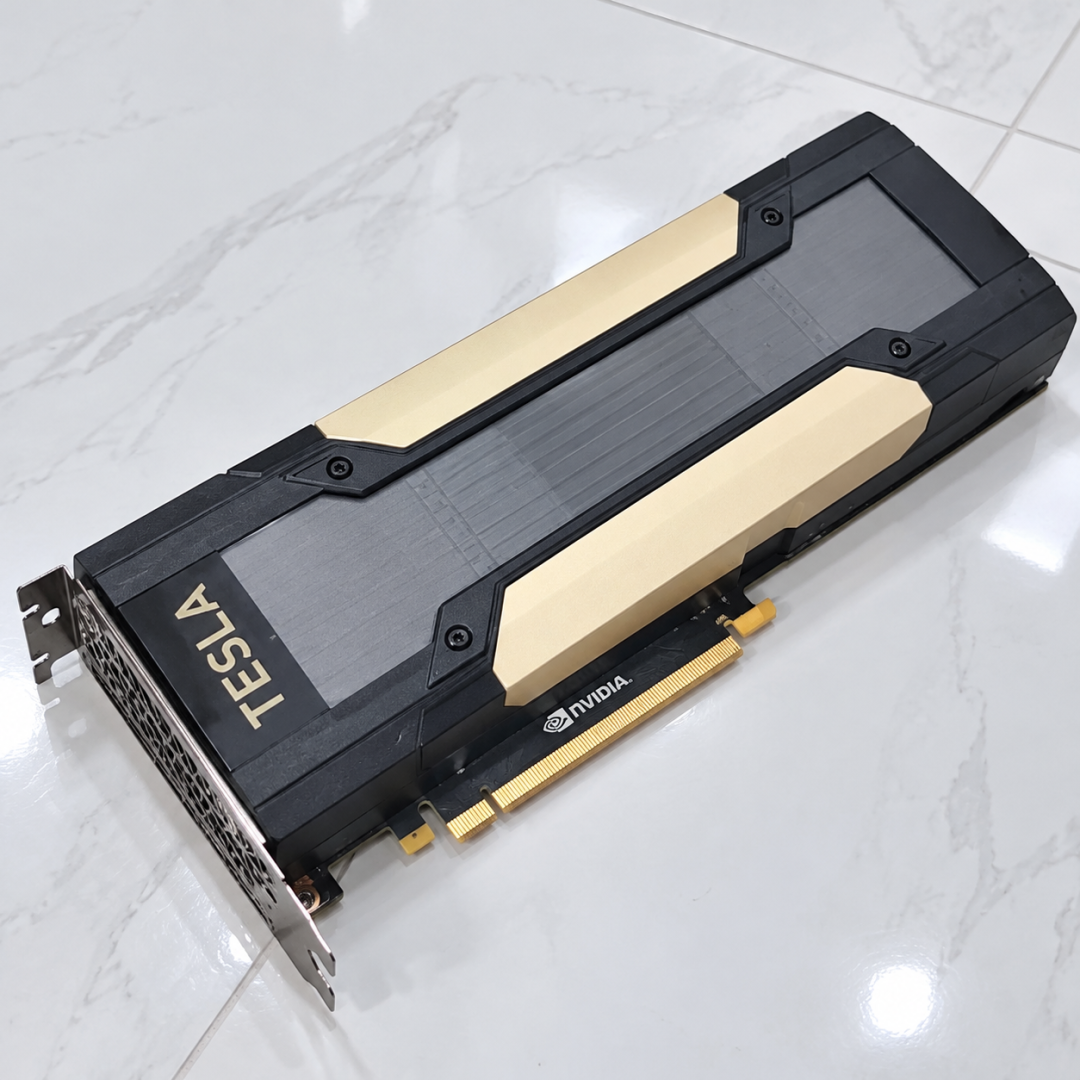
运行账也有现成参照。11 月中旬那波“某律师用 8 张 V100 搭建本地 AI 服务器”的知乎讨论里,当事人参照美国当地电价测算:低负载每月电费约 100 美元,长时间满载会涨到每月 400 美元上下。国内 UP 主对“律师 8 张二手卡”方案的实测评测里,一年电费约 3700 块,同时直言这台机器驱动也快停更了。12 卡集群只会更耗电、更发热,噪音和运维都建立在这套功耗之上。知乎哔哩哔哩
为什么这批老卡偏偏是“今年”跑起来了?答案在软件。同一位科技 UP 主的对比显示:还是四张 V100,2025 年用 llama.cpp 只有 25 token/s,2026 年换成社区新推理引擎跑 NVFP4 量化权重,单路生成冲到 202 token/s。还有引擎宣称 4 卡 V100 单流峰值可达 500 tok/s。模型侧同样放行:DeepSeek-V4.1-Flash 在社区推理项目里已被标记为对 A100、RTX 3090 等较早架构 GPU 完整支持。开源权重、社区引擎、退役卡三块拼图咬合,“本地跑大模型”的入场券才被压到万元级——这也解释了社区为什么把二手 V100 称作“穷人法拉利”:卡便宜,性能靠软件生态追回来。哔哩哔哩灵猫工作室LynxLabGPUStack
要不要抄作业,反方声音同样值得听。同一批知乎讨论里也有判断:只求稳定和本地大模型办公的话,直接选大内存的 Mac Studio 类工作站更省事——体积只有两个便当盒大小、满载功耗 100 多瓦、开箱即用,量化版 DeepSeek 直接跑得动,还省掉雇 IT 运维的钱。来自皇后区的小子
两条路线其实在回答同一个问题:这台机器值不值,取决于你有没有一份不能出这个门的文件。对法律、医疗、金融这些保密边界最硬的行业,答案往往是肯定的,6.3 万元可以当作生产资料投资;而对只是写周报润色邮件的普通人,网页和 API 按 token 付费明显更划算——这么用本地服务器绝对是亏的,还得自己伺候一台机器。这场热榜真正的信号是双向的:算力成本被退役卡和开源引擎压进了“几万元”区间,但单机跑通与稳定服务之间,仍隔着一整层运维——买它的不只是显卡,还有折腾机器的意愿。AI-X-ON知乎

当前文章无评论,是时候发表评论了