

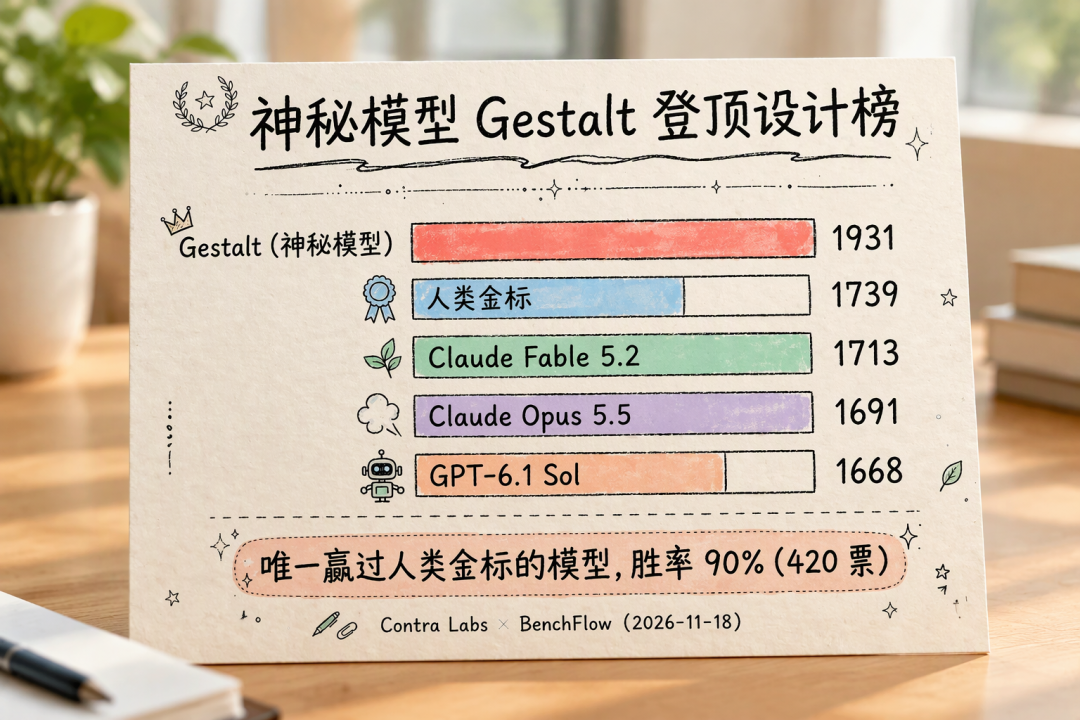
盲测是真的,Gestalt 也确实赢了——但“赢”不等于“被替代”,这场胜利有清晰的前提。11 月 18 日,Contra Labs 与 BenchFlow 上线首期 Frontier Design Benchmark 榜单,题目取自真实客户 brief,由 35 位专业设计师两两对决盲投注票算出 Elo 分知乎知乎。排名第一的是匿名模型 Gestalt,Elo 1931;第二名不是某个知名模型,而是人类设计师做出的金标参考作品,1739 分;具名模型里最强的 Claude Fable 5.2 以 1713 分排第三。这是目前榜单上唯一赢过人类金标的模型,赢了 192 分知乎。
这场测试考的是“认不认得出”,不是“做不做得出”
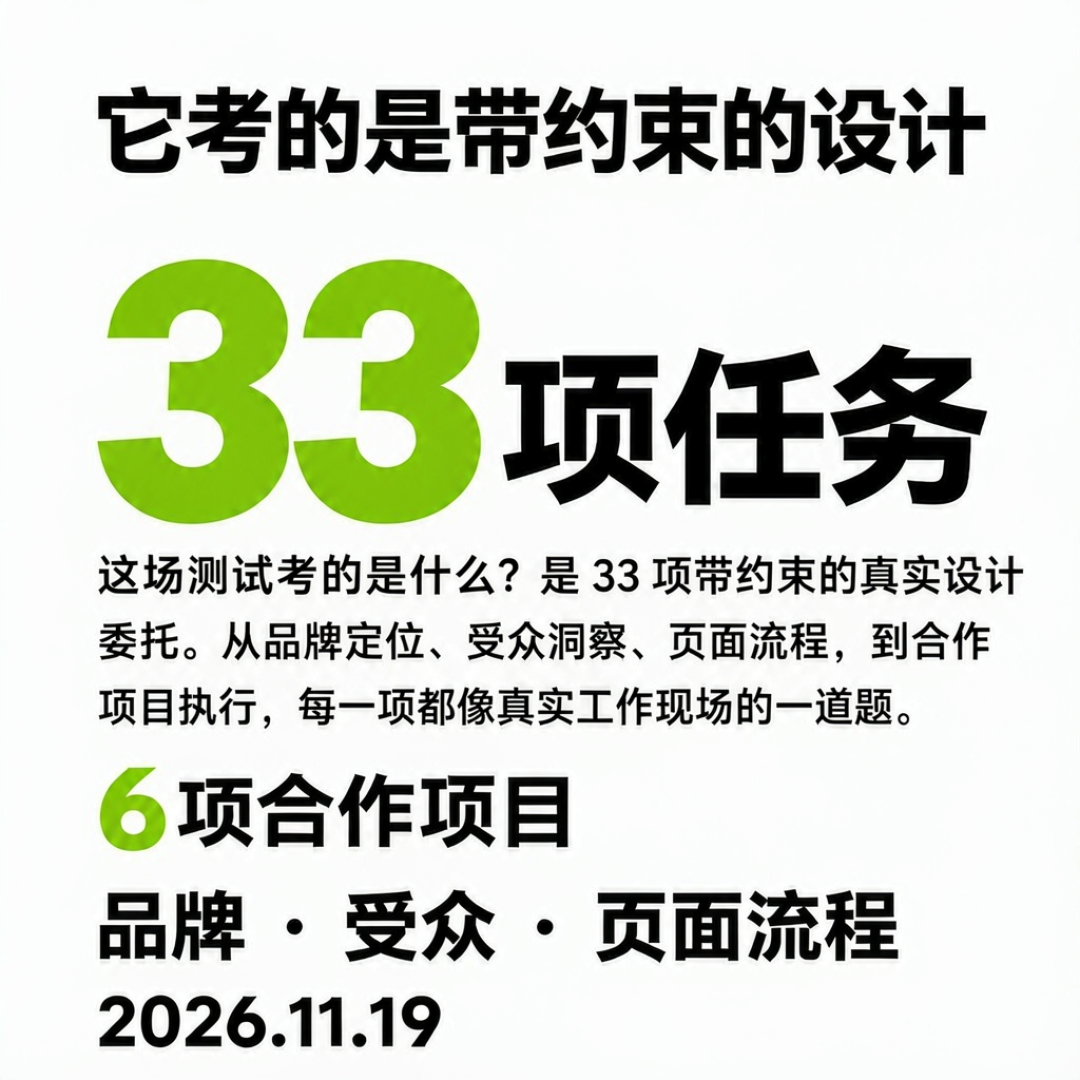
以前的 AI 设计榜比的是能不能做出图,这次比的是好不好:评分维度涵盖色彩、字体、布局、可用性以及对任务要求的遵循程度知乎。33 道题也不是玩具题:27 项改写自真实设计委托并隐去客户信息,另外 6 项来自创业公司合作项目,任务会带品牌材料、目标人群、页面流程等约束小红书知乎。两个细节让结果更有分量:榜单刚上线时,排第一的还是人类金标,Gestalt 是后来才冒出来登顶知乎。而在 Gestalt 与人类金标的正面交锋中,专业设计师在不知道作者身份的情况下,28 次里选了 Gestalt 20 次知乎小红书。
“赢 192 分”有三条边界
第一条,出题方与受益方重合。Contra 既运营设计师市场,又发布评测设计师能力的基准,结果至今没有第三方复现知乎。一条高赞评论点中了要害:真正该被公开的,是题集和评分规则,不是参数量知乎。
第二条,Gestalt 做出了什么,公众看不见。公开画廊只展示具名模型的产出,读者无法确认那 35 位评委究竟看到了什么页面知乎。
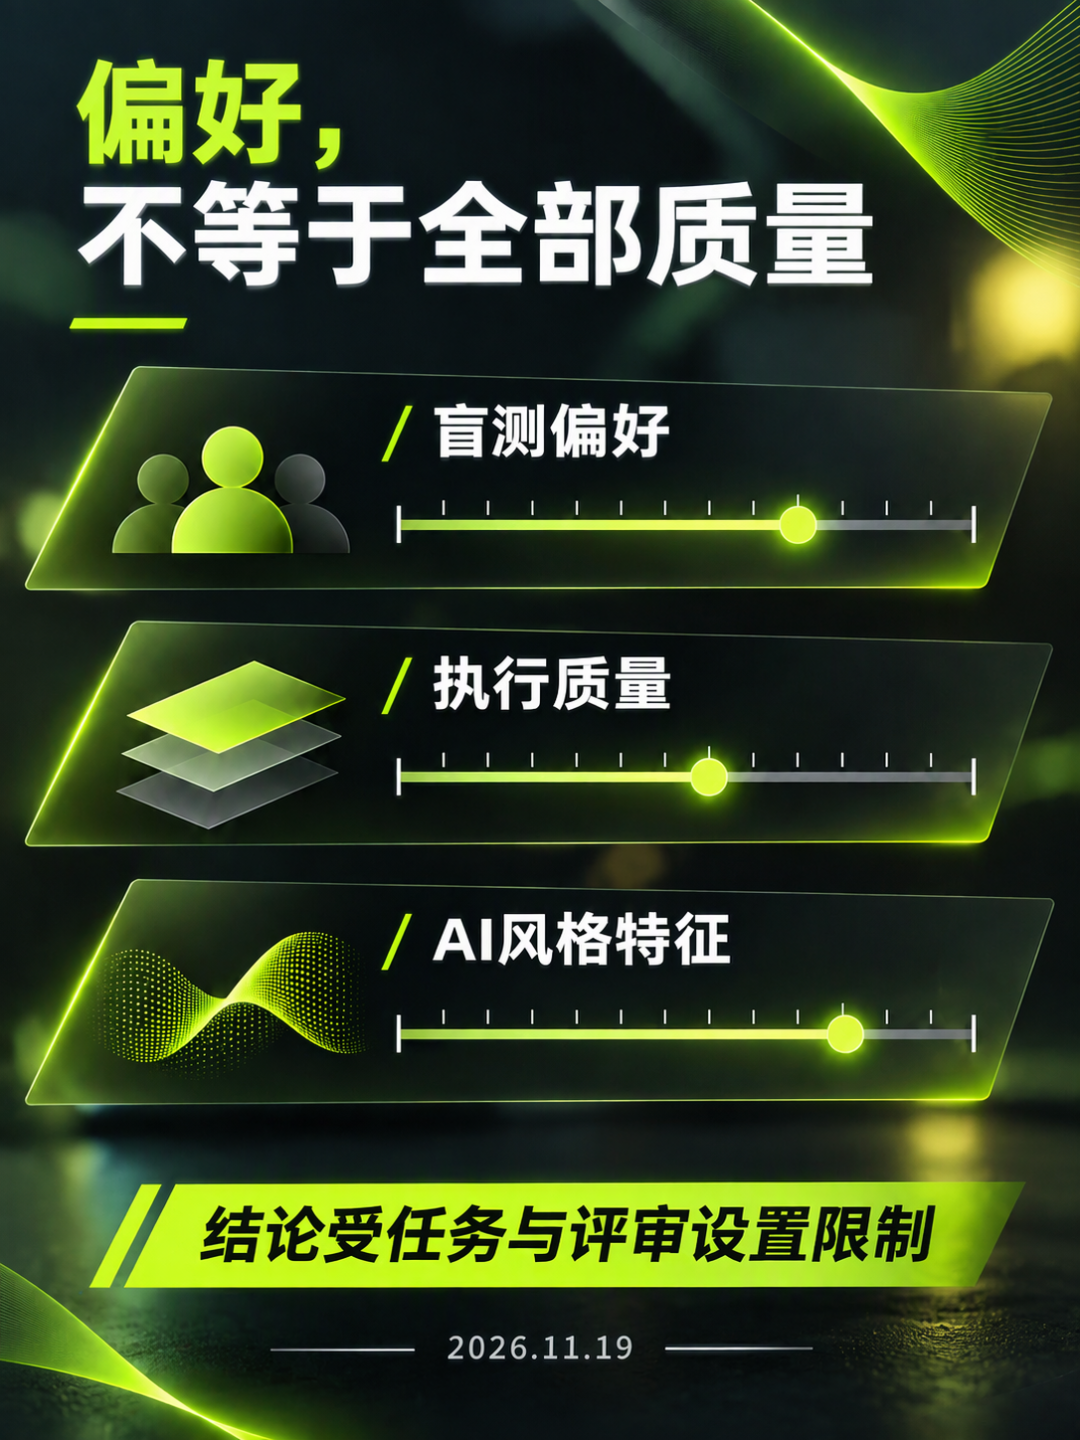
第三条,口径不统一,快照会漂移。在另一份拆解记录的设计规范评分小项里,Gestalt 得 83 分,Claude Fable 5.2 和 Opus 5.5 反而都是 84 分——不同评价方式得出的结论并不完全相同知乎。榜单本身还在滚动更新,官方博客快照里的 Gestalt 是 1928 分,混着不同时间的数字比没有意义小红书。
Gestalt 是谁,传闻还没变成事实
开发方至今没有现身,榜单上只有 Stealth(隐身)两个字知乎。发布前匿名参测是行业熟路:用化名在第三方盲测平台或设计基准上进行大规模 A/B 盲测知乎。官方尚未揭晓底牌,传闻里有几种说法:下一代 Claude,或者某家中国模型,但都只是传闻,没有任何官方确认知乎。中文圈的头号猜测则是智谱,理由是 8 月匿名爆火的 Ox Alpha 最后正是被智谱自己认领小红书。截至发稿,没有一个猜测得到官方确认。
名字本身就是技术宣言:Gestalt 是心理学术语,意为“完形”,强调视觉整体感与美学平衡知乎。今年 10 月,中国人民大学高瓴人工智能学院 GeWu-Lab 等团队联合发布过一个同名的多模态研究模型知乎。但同名研究不是隐身模型身世的证据,在开发方认领之前,两者必须严格分开。
设计师该担心的不是替代,是护城河换位置
这不是 2026 年第一次触发替代焦虑:今年 4 月 OpenAI 生图模型 image-2 爆火后,最先被推到问题中央的就是设计师36氪。区别在于,上一次被追上的是“出图”的执行层,这一次被击中的是整体判断——很多设计师视为最后防线的部分。榜单也覆盖不了真实工作:客户的反复修改、预算与工期、带着品牌上下文的取舍都不在考题里,官方甚至提醒过,AI 痕迹低也可能只是因为页面没做完,不能直接当成高质量证明小红书。真正在变的是技能的定价:把图做好不再稀缺,稀缺的是知道什么好看、为什么好看、哪里不对劲。最先承压的是纯执行类设计订单小红书。对普通用户,门槛反而在降——先让模型出一个像样的版本,再用自己的判断去改。
接下来决定这件事成色的,是三个信号:开发方何时现身并开放试用;第三方能否用同一套题集复现结果;把它扔进真实 brief 的反复修改和工期里,成绩还站不站得住。在这三个信号落地之前,1928 到 1931 都是一个需要被认真对待、但同样需要被认真怀疑的数字。

当前文章无评论,是时候发表评论了