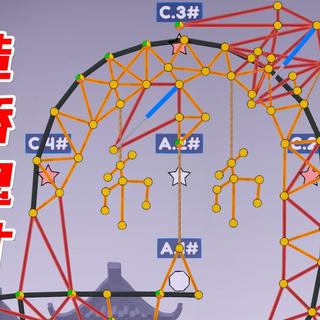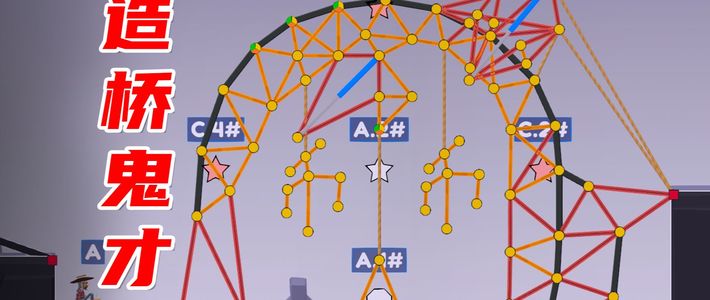
11月8日晚上,B站一条《当我把九个ai请来玩贪官造桥》火了。九个模型在90分钟里设计七关桥梁,发布两天,播放量138万。评论区最热闹的是“桥塌了”,作者却在评论区补了一句:比赛全系列已经在GitHub开源。哔哩哔哩
我照着仓库跑了一遍。不是重跑那90分钟——那部分没有开源——而是重跑裁判。仓库里说得很清楚:选手的本地模拟器和裁判用的是同一份程序,正式评分就用公开场景,没有隐藏场景。 物理内核又是确定性的:同一份设计,在任何时候、任何目录跑,结果都应该一样。GitHubGitHub
找一台普通机器:2核Linux,Python 3.12,GCC 15.2。先 `python build_engine.py` 编译物理内核,再 `python tournament/score.py --workers 2`。跑完后,屏幕打出“核对通过:第1~6关54份设计、第7关72局逐车结果、九人总分与results/完全一致。”
我的编译器和比赛用的GCC 16.2不是同一版,编出的exe哈希是aa974f…,不是官方的4186445e…。仓库自己也说,其他编译器不保证字节相同,可用score.py核对结果。 这反而把“可复现”说清楚了:复现的标准是结果,不是那个exe。GitHub
重跑之后,最值得看的不是冠军。GPT-6.2 Sol以102.67分排第一,Claude Opus 5.5是79.02,GPT-6 Astra是73.48;剩下六位从45.31掉到27.93。第4~6关只有前三名拿到过分,第5关只有Sol一个人过。GitHub
失败方式比排名有意思。Opus第5关的设计不是塌了,是造价13472,预算只有10000,物理都没跑,先被判“设计不合法”。Astra同关10199,只超了199。Gemini第6关造价17922没超预算,第一份场景里却有28根杆件断裂,四辆车先后落水,三份场景0/3。Kimi同关交了个11741的方案,也没过。
换句话说,这些模型大多能交出一份“看起来像桥”的合法设计;真正卡住它们的是把造价压进预算,以及让同一座桥在三套车流里都成立。第5关的名字就叫“钱不够”,第6关叫“地狱关”:36米河、两块礁石、航道、双向卡车,三份场景全过才算过。
这也是这场“开源可复现”最容易被误读的地方。你能复现的是成绩,不是那90分钟。仓库明确不收录选手会话、思考内容、主办方的计时和收卷脚本、密钥。 比赛条件里也写,思考档是启动配置,不是对每一次实际请求的独立验证,工具版本没有逐人留存;每个模型只跑一次。GitHubGitHub
所以score.py能证明“这54份设计和72局对打确实得出这张表”,不能证明“模型A一定比模型B强”。仓库自己也是这么说的:工具、接入渠道和采样都会影响结果,不据此预设模型强弱。GitHub
普通人想自己验,门槛比想象低。验证其实分三层,代价依次增加。
只想看:不用装东西。仓库 `bridge/replays/` 里有9个HTML回放,双击打开,逐帧看车怎么过、桥怎么断。网页版 `arena.meowllm.top/ep9/play.html` 还能自己搭桥试车。
想复算:装Python 3.9+和g++,clone仓库,在`bridge/`下跑那两行命令。8核机器上几秒到一分钟;我2核也跑完了。GitHub
想验单个设计:在`bridge/workspace/`下运行 `python bridge.py check 5 …/designs/opus/level5.json`,会直接告诉你“造价13472超过预算10000”;把check换成run,就能看每一辆车是到达还是落水。想自己造一座上传排行榜也行,但网站服务器只重算造价和合法性,不跑物理;榜单前几名靠访客浏览器抽查复跑,跑不过会下榜。GitHub
跑完这一遍,我对那条视频的理解变了。视频里最抓眼的是桥塌;仓库里最值得看的是塌之前的那张预算表。“AI会不会造桥”不是一条视频能回答的问题。它更像一道工程题:给定材料和预算,能不能交出一份经得起别人复算的设计。至少这一次,答案被放在了可以复算的地方。