

2026年11月,韩国政府公布总规模约8002亿韩元的端侧AI半导体研发计划,排期到2030年。高通把面向PC的NPU算力堆到了80TOPS。苹果智能大陆首批功能上线。淘宝、小米接连开源0.3B、0.8B的端侧小模型。所有人都在把AI往你口袋里塞。知乎知乎知乎知乎知乎
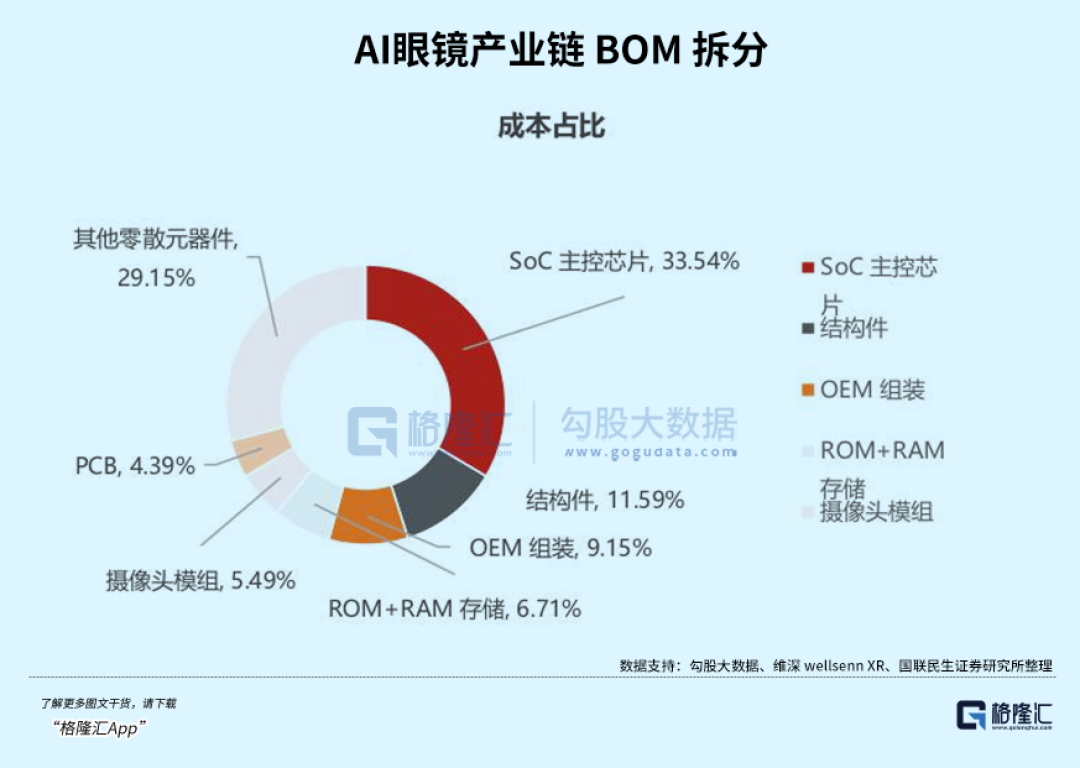
这个赛道是不是必争之地?是。但他们争的从来不是模型,而是三道物理墙。
为什么突然都在抢
过去讲故事的是云端"大力出奇迹",现在端侧有了一条新定律支撑:清华孙茂松、刘知远团队提出的"密度定律"——大模型能力密度约每3.3到3.5个月翻一倍。什么概念?芯片算力大约两年才翻一倍,而每隔一百天,一半参数量的模型就能摸到今天最优的水平。摩尔定律决定终端"装得下多大的模型",密度定律决定"装进去的模型有多聪明",两条曲线在2025到2026年交叉,装模型才从演示变成生意。知乎知乎
头豹研究院测算,2026年国内端侧AI市场规模约8661亿元,2029年奔着1.22万亿去,手机、PC的AI渗透率今年分别有望到45%和62%,这笔市场账算得过来。更关键的是入口价值——车内摄像头数据要传云端,有用户直接拿衣服把它盖住。车进隧道断网,功能不能跟着失效。高频、实时、隐私敏感、离线可用,这四件事云端替代不了,谁占了终端,谁就占了下一代AI的入口。知乎知乎
但瓶颈真不在"算力不够"
第一道墙:内存带宽,TOPS数字会骗人。 模型生成每个字,都要把全部权重从内存里搬一遍,瓶颈在"搬"不在"算"。有人实测同一个0.6B模型,两块开发板解码速度差5倍以上:一块24.6 token/s,一块只有15.59。发布会爱讲几十TOPS,但TOPS测的是"读题",你天天用的"生成"靠带宽。知乎知乎
第二道墙:热和电。 手机持续推理几分钟,温度上来就降频,速度腰斩是常态。你测的峰值速度和用户实际用到的,根本不是一个数。demo聊10秒很惊艳,连续聊10分钟原形毕露。知乎
第三道墙:量化掉点和幻觉。 7B模型不量化根本装不进手机,4bit量化后有的任务掉1个点没感觉,有的直接没法用。更要命的是,模型越小越容易一本正经地胡说。知识、检索、纠错全被压缩掉了。信通院《端侧智能产业发展报告(2026年)》的原话是:模型"可运行"并不等于"可信运行"。知乎知乎知乎
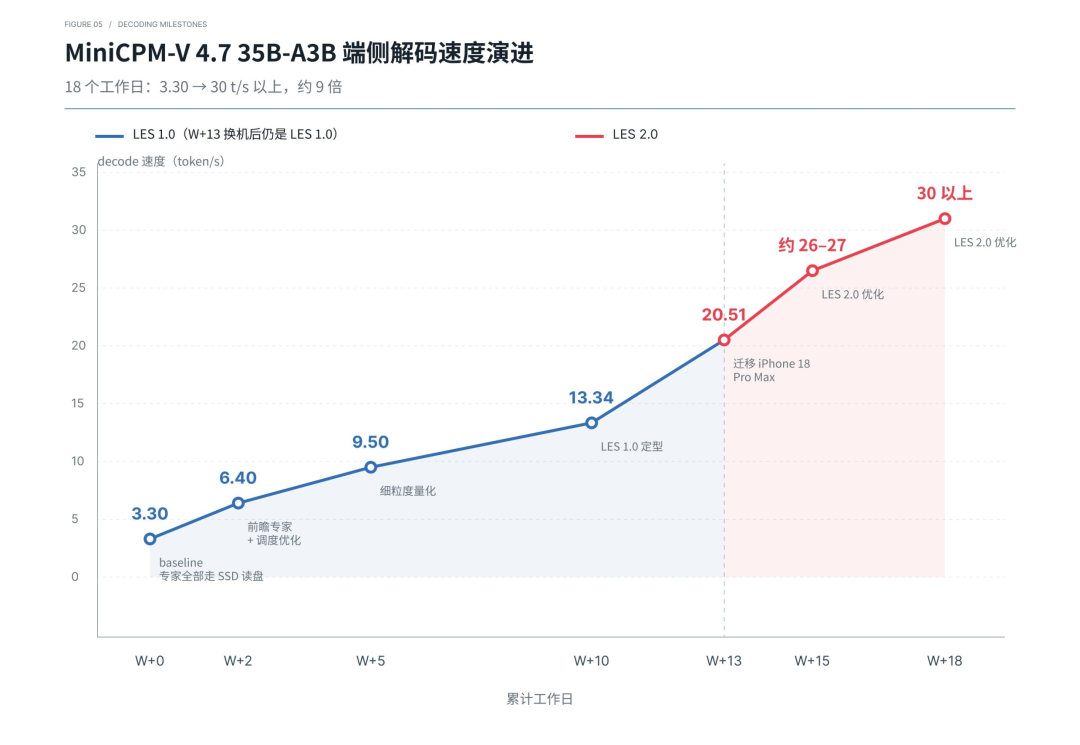
给你的判断方法
别被"全离线"话术忽悠,商用的端侧AI几乎全是端云协同,ZEDEDA 2026年调查显示47%的企业已经这么干。合理的分工是:拍照增强、离线转写、隐私查询给端侧,长文写作、复杂推理回云端。知乎
看新品发布会上的端侧AI卖点,就记三件事:拿真机测token/s而不是看TOPS;盯内存规格而不是存储;信"连续跑十分钟"的评测,不信"演示十秒"的发布会。
必争之地是真的,地图是内存、散热和量化画的。

当前文章无评论,是时候发表评论了