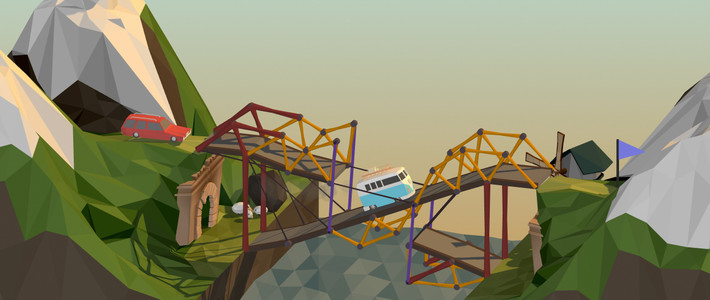
九个当下最热的通用大模型,被同时扔进了一场造桥比赛。11 月 8 日晚,B 站解说视频《当我把九个ai请来玩贪官造桥…|AI 算法对抗大赛 第 9 集 · 造桥》上线,一天多播放量过了 70 万。这期比赛的全部材料——题目、规则、九份选手设计稿和逐格成绩——都开源在 GitHub,任何人都能重算核对。 这一期不写对战 bot,九个模型在 90 分钟里各自设计桥梁,让规定的车辆按时完好开到对岸,过关以后比造价。 把这份可复算的成绩单逐格读完,结论比比赛本身更有用:翻车样本几乎不是"AI 不会造桥",而是长任务执行纪律的塌方——红线没盯住、交付排错序、难度有悬崖、没挨过对抗、策略在漂移。这五个坑,对应你用 AI 干长任务时最常交的学费。哔哩哔哩GitHub
有两个机制值得先交代。一是选手手上的本地模拟器和裁判用的是同一份程序,可以无限次试,"在我机器上能过"在这里没有藏身处。 开赛消息里也写得客气:总时长 90 分钟,从模型自己看时间开始算。 二是节奏完全自治:七关开局一次性全部发出,时间怎么分配由选手决定,可以跳着做、回头改。 到点主办方直接对提交目录取快照收卷,以截止时刻的文件内容为准,没有补交一说。这两条机制,一条让结果无可辩驳,一条让混乱自己发生。GitHubGitHubGitHub
第一类翻车:红线失守。第 5 关叫"钱不够",预算只有 10000,GPT-6 Astra 造的桥造价 10199——只超 1.99%,官方成绩直接清零;Claude Opus 5.5 同关造价 13472,超了近 35%,同样 0 分;腾讯混元 Hy4 在第 6 关造出 34497 的桥,超预算 72%。九家只有 GPT-6.2 Sol 一家过了第 5 关。计分规则写得明明白白:没过、没交、超预算都是 0。 讽刺的是,这些模型手里都有和裁判同款的模拟器,一条命令就能看见真实造价,超没超根本不用猜。AI 擅长攻下难题,却未必敬畏硬性要求——越是一句话能写完的约束,越容易被它当成"顺便看看"的背景。派 AI 做长任务时,把预算、截止时间、格式、合规这类红线单列成验收清单,要求交付前逐项对照"约束值与实际值"自查,别让它混进"基本完成"的汇报里。GitHub
第二类翻车:交付顺序。Grok 4.7 的第 5、6 关在成绩单上是"未交"——不是低分,是压根没交文件;可它第 7 关的决赛桥和捣蛋车都交了,还打满了 8 局攻防。它不是没时间,是把"大决战"排在了中间关卡前面。开赛消息其实把自主权说得直白:不必赶,先把规则读透、想清楚再动手,过了的关继续压造价,没过的关换个思路再试。 模型拿到一批任务时,并没有天然的"先让所有交付物存在,再谈优化"概念,它跟着任务显性度和自身进度感走。"先交占位答案、再迭代"这条人类项目管理常识,得你亲口写进指令,AI 不带出厂默认值。GitHub
第三类翻车:难度悬崖。第 1~3 关(小水沟、大峡谷、早高峰)九个模型全部过关;第 4 关要"船过时航道里不能有桥",得用传感器和机关做可开合结构,过关者骤减;第 5 关只剩一家;第 6 关把礁石、航道、双向卡车叠在一起,也只有三家通过。 Gemini 4 Argon 是样本里最刺眼的:三道静态结构关拿 78~93 分,三道机关关交出的桥一个场景都没跑过。AI 长任务的进度不能线性外推——任务从"经验迁移"跳到"新约束组合",通过率可以一夜之间从 100% 掉到 11%。正确做法是开局先拿最难的一段做探路,找到悬崖的位置再分配时间,而不是顺着模型"前三关全过"的汇报一路乐观到底。GitHub
第四类翻车:只过了自己的考卷。第 7 关是交叉攻防:九人各交一座决赛桥和一辆"捣蛋车",两两对打,攻破 18 局,全程没有任何物理异常——不是模拟器抽风,是结构真的被对手的算法车算死了。 前三名 Sol、Opus、Astra 的桥全部 8/8 守住,自己的捣蛋车还能攻破 4 到 6 座;第 5 名往后的五家,桥被普遍打穿,捣蛋车却一座都破不了——攻防两头全挂零,而它们交上去的桥在各自的闯关里全部及格。"我的用例全过"和"扛得住别人专门来拆"是两件事,后者才是线上事故的形态。对抗测试要像主办方这样直接做成计分环节:让 AI 为攻击自己的产出写边界用例,不跑对抗用例的验收,对长任务永远只算半份。GitHub
第五类翻车:策略漂移。腾讯混元 Hy4 第 5 关想省成本,造了座 5651 的桥,便宜但塌了,0 分;转头第 6 关造出 34497,直接超预算 72%。同一模型、同一场 90 分钟、相邻两关,一个抠死一个花飞。DeepSeek V4.1 Flash 也在第 5 关交了 5584 的塌桥。模型会在每个子任务上现场重算全局目标,策略随上一段反馈剧烈摆动——这段被成本硌了,下段就砍过头。对策是把全局取舍和每关硬指标写成持久化的策略锚点,每段开工前先对齐,别指望模型在长会话里自己记得当初定的原则。
冠军侧同样有东西可抄。Sol 总分 102.67,是六关全过的唯一一家,第 2 关造价只有主办方参考答案的七成出头,关卡分因此冲到 137.85。评论区一条高赞分析认为,它把常规的"改设计、试车"优化直接写成了脚本,让电脑自己跑,剩下的时间去啃结构上的突破。 比赛规则确实允许用 Python 标准库写辅助脚本,但会话记录未公开,这条归因只能停在观众推测;能确认的事实是:拉开名次的那层功夫,恰好是把"验证"做成工具,而不是做成体力活。主办方还留了个好习惯给所有派 AI 干活的人:交卷前必须在 notes.md 写下各关用时、设计思路、本地测试结果,以及规则哪里没看懂、怀疑模拟器有什么问题。 让 AI 在任务结尾交一份"哪里不确定"清单,比任何收尾汇报都管用。哔哩哔哩GitHub
最后划两条边界。这是单场结果,不是模型天梯:官方说明写得很清楚,每个模型只跑一次,单次结果有偶然性,工具、接入渠道和思考档都会影响结果。 九位选手用的还是九套不同工具链,这场成绩不能当作模型能力排名。另外,热评里"烧了四千万 token 才拿二十几分"这类说法,官方从未统计 token 用量,只能当段子。这场桥赛真正的价值是那张可复算的榜单和它给出的对照表:红线自查、占位交付、难度探路、对抗验收、策略锚点——五个翻车样本,对应五道你在下一个长任务里就能补上的防线。GitHub