最近一个月,本地大模型圈被一个叫 Strata 的开源项目刷屏了:1250亿参数的 Qwen3.8-Flash-Next,官方宣传一张12GB显存的游戏卡就能跑,GitHub 星标涨到2.6万。知乎知乎知乎
听起来像"老电脑免费用上旗舰级AI",评论区已经分成两派:一派晒出5070 Ti跑出58 token/s的速度,另一派则质疑只提12G显存、不说64G内存要求,是标题党。
两派都有道理。这篇把速度和内存的账拆开算一遍,要花的钱也算在里面,你看完就知道自己那台电脑到底能不能上桌。
它不是压缩魔法,是搬家
Strata 本身不是新模型,它是一个推理引擎,跑的是阿里开源的 Qwen3.8-Flash-Next。这个模型是 MoE(混合专家)架构:总参数125B,但每个token只激活约6B。
打个比方,它像一家有五百多位专科医生的医院,你看病时只叫相关的几位出诊。模型每层有512个专家,处理一个token只挑10个,剩下的参数那一刻根本不用干活。
Strata 抓住的就是这一点:既然大多数专家暂时闲置,就没必要全塞进昂贵的显存。它把模型拆开分层放——高频部分进显卡,全部专家放内存,CPU参与计算,巨大的n-gram查找表干脆放到SSD上。它还会学习哪些专家常用,把热门的留在显卡里。知乎
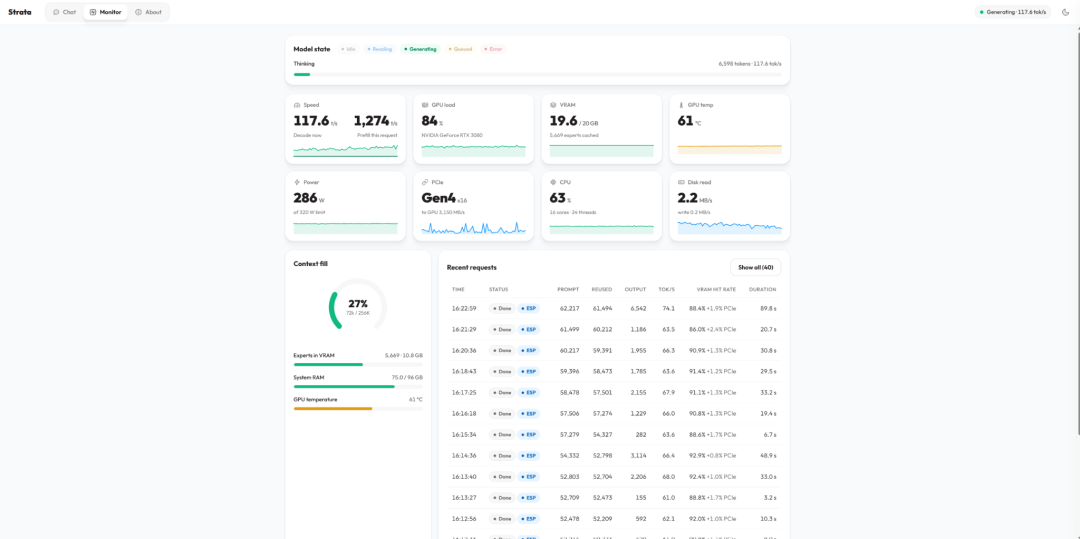
所以12G显存跑125B是真的,但显存只是门票,内存才是验票的——这句话来自一条高赞评论。
速度账:数字好看,条件苛刻
官方给的数据是RTX 5070 12GB加64GB内存、IQ3_S量化,跑出约53 token/s。注意后半句:不是整台电脑只需要12G,是64G内存托着它。
第三方和玩家的实测更参差:有人5070 Ti配96G内存跑出58 token/s;也有人微博上说,项目方还宣传过90 token/s的说法,实测只有30多。微博
更扎心的是首字延迟。一位用RTX 2060加32G内存的作者反馈:生成速度看着不错,但输入约两万token的材料后,等模型开始回答花了将近五分钟。知乎
生成速度是长跑成绩,首字延迟是起跑反应,Agent任务两个都看。 你要是拿它接Claude Code这类编程智能体,喂进代码上下文后的等待会很明显;纯聊天、写周报反而感知不强。
内存账:这才是真正要花钱的地方
过去跑本地模型,大家卷显存;Strata 一出,焦虑直接转移到了内存。一位用RX 7900 XTX的作者说得很直白:以前24G显存只关心模型塞不塞得下,现在内存大小成了另一道瓶颈。
社区给的门槛大致是:12GB显存起步,64GB内存流畅,250GB固态。再往下压也有办法,有作者在16GB内存的Mac上靠mmap从SSD流式读取跑了起来,空闲时进程只占2.5GB内存,代价是速度明显变慢。知乎
麻烦在于现在不是加内存的好时机。渠道报价16G DDR5卖到1400到1800元,32G要2000到3000多元。为了跑一个免费模型,先花两三千买内存,这笔账得自己掂量。知乎
穷有穷的玩法,但各有各的坑
预算有限的话,社区确实蹚出了几条路,都有实测数据,也都有代价。
洋垃圾路线:X99平台加P100计算卡,整机1400元出头,跑Qwen3.8-Flash-Next实测30到50 token/s。但有作者明确说,P100的prefill偏弱,这套方案更适合Strata,对其他大模型兼容性一般。哔哩哔哩
服务器内存与魔改卡路线:有人用500元的64G DDR3内存配E5洋垃圾,跑125B做到35 token/s,还有人花不到4000元上2080 Ti 22G魔改卡,IQ3量化跑到50 token/s,还能开256K上下文。知乎
A卡路线:RX 7900 XTX 24G也能跑,256K上下文可用。AMD方案的价值在于,你不用为AI单独换N卡,但需要折腾Ubuntu和ROCm环境。知乎
共同的前提是硬盘必须是NVMe固态。有人用6GB显卡加16G内存的极限配置跑通了,但特别提醒:机械硬盘慢死,别用。知乎
上桌前,先问自己三个问题
你要拿它干什么? 想体验125B级多模态、跑本地Agent、数据不出门,Strata确实把门槛从"服务器"降到了"游戏本"。已经有大显存或大内存的机器,装一个试试不亏——有玩家反馈,用5060 Ti显卡加32G系统内存也跑起了125B,多模态能力超过HuggingFace上那些7B到9B的小模型。知乎
你的内存够吗? 显存之外,64GB内存是流畅线。机器本身就32G的,按现在的行情加内存要花上千元,为一个免费模型投这笔钱值不值,得想清楚。
能不能接受等? 长输入的prefill等待是这套方案最真实的代价,喂长文档、跑Agent时要做好心理准备。
反过来说,如果只是日常问答、写文案、翻译,一个27B级的稠密模型反而更稳。社区里跑了很久的人给的建议很一致:稠密模型推荐Qwen3.8-27B配NInfer加速,MoE模型才考虑用Strata部署。这类稠密模型上下文支持长、运行稳定,也不用折腾分层部署。知乎
比起"人手一个千亿模型",Strata真正验证的是另一条路:跑大模型未必需要更大的显卡,把整台机器的内存层级用好,老设备也能上牌桌。至于你这台机器该不该上,先看内存条,再看用途,最后才是显卡。