

随着大模型、AI智能体的应用持续落地,不少用户开始重新考虑算力方案。长期使用云端AI,不仅存在数据上传的隐私顾虑,持续的Token消耗也会带来长期的使用成本。在此背景下,搭载NVIDIA RTX Spark超级芯片的桌面形态算力终端,正在给本地AI工作流提供新的选择。全球首批发售的RTX Spark主机已经集中上市,机械革命、微星、华硕相继推出对应机型。这类产品共同的特点是体积小巧、性能强大,主打本地AI部署,数据可以保留在本地,规避云端Token焦虑,适合开发者、创作者长期托管智能体、运行大模型。
NVIDIA RTX Spark超级芯片与统一内存
三款机型的基础,都来自NVIDIA RTX Spark超级芯片。这颗芯片采用20核Arm v9.2 Grace定制CPU,GPU为Blackwell架构,拥有高达6144个CUDA核心,可运行NVIDIA CUDA平台。对本地AI来说,CUDA生态意味着模型、框架和工具链的兼容性有现成基础,AI与RTX图形技术也能在同一套平台上协同。
统一内存是另一个看点。三款产品至高配备128GB LPDDR5X 9600统一内存,CPU与GPU共享这部分内存资源,模型可以整体驻留在本地,不必像传统独立显卡那样受显存容量限制。对运行大模型、长期托管智能体来说,内存容量往往比峰值算力更直接地决定“能不能跑起来”。这也是这类桌面算力终端把统一内存作为核心卖点的原因。
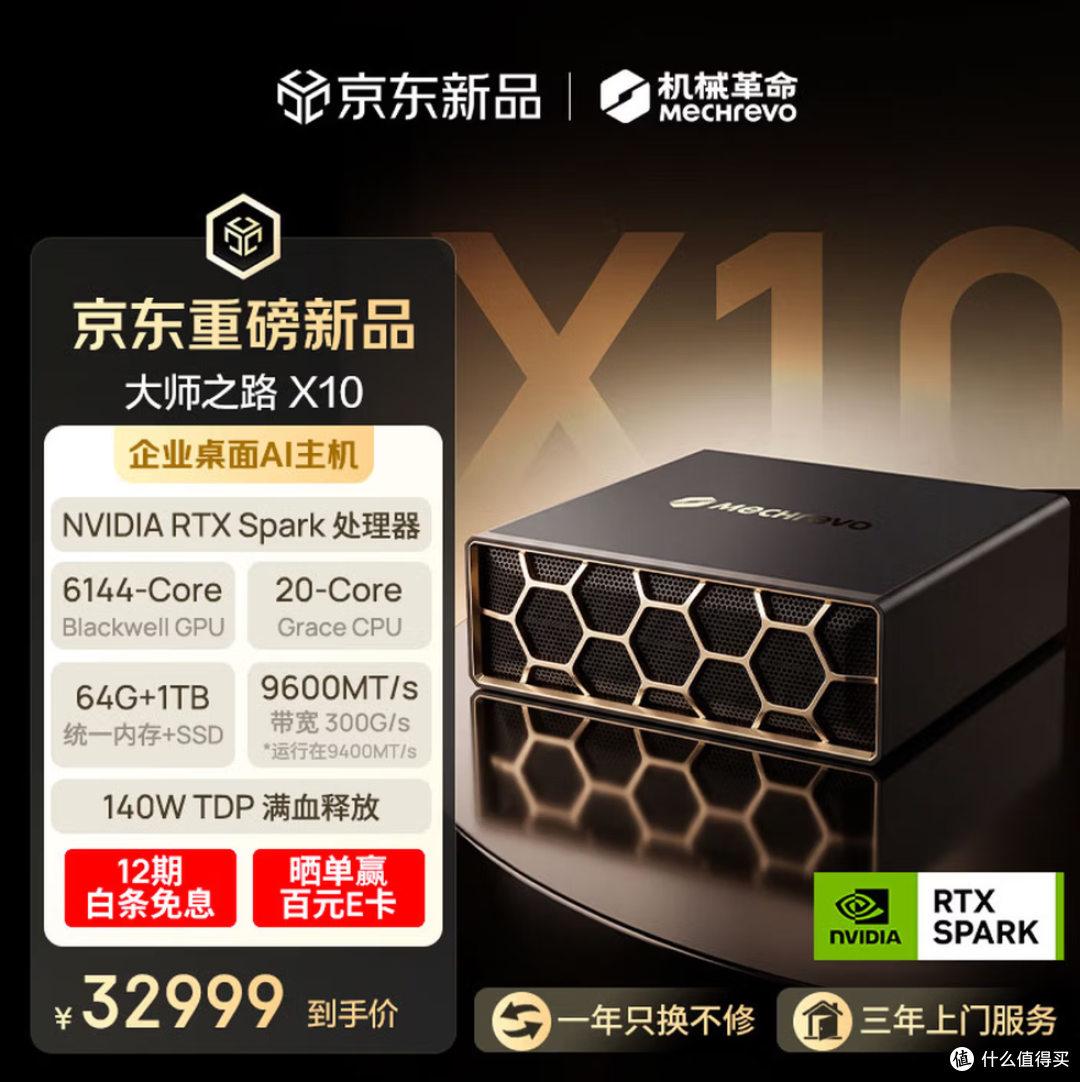
机械革命大师之路X10:32999元起
机械革命大师之路X10提供两个配置版本,旗舰版128GB+2TB售价49999元,专业版64GB+1TB售价32999元。整机把大模型算力装进1.25L的机身里,尺寸155mm×158mm×51mm(不含脚垫),重量约1.42kg,体量接近手掌大小,摆放灵活性较高。外观采用全金属CNC工艺,搭配金色铝框与六边形蜂窝前网,设计风格偏沉稳。
整机可实现140W TDP性能释放,散热由70片高密度散热鳍片与109片增强涡轮扇叶组成,扇叶以1.1mm等距排布,配合大尺寸风扇,兼顾高负载下的散热与噪音表现。接口覆盖USB-C全功能接口、USB-C PD3.1 240W供电、HDMI 2.1、RJ45 10Gbps网口以及三组USB 10G接口,另有肯辛通防盗锁孔与电源开关。售后为一年只换不修、三年上门服务。
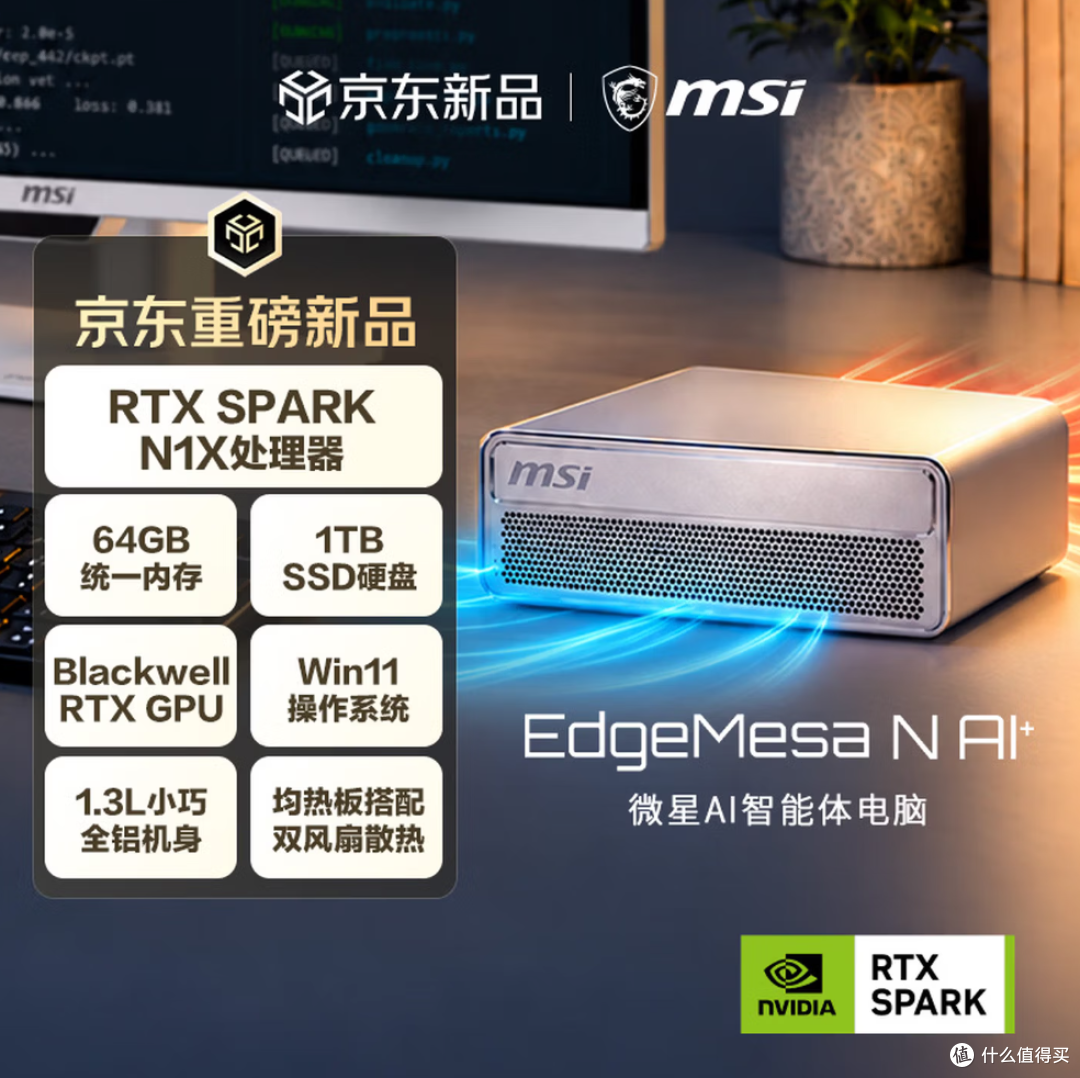
微星EdgeMesa N AI+:33999元起
微星EdgeMesa N AI+提供两个配置版本,128GB+4TB定价56999元,64GB+1TB定价33999元。整机体积1.3L,全铝机身带防指纹涂层,在有限的桌面空间里提供本地AI算力。
散热采用智能脉冲散热系统,融合均热板散热技术与双涡轮增压风扇,稳定维持140W TDP性能释放,设计上偏向保障AI智能体7×24小时不间断运行。高速连接是它的一大亮点,自带Wi-Fi 7、万兆网口,机身配备4个20Gbps USB-C接口、HDMI 2.1(FRL)接口以及肯辛通锁孔,支持四屏输出,适合需要多窗口监控AI推理任务、频繁传输模型素材的用户。
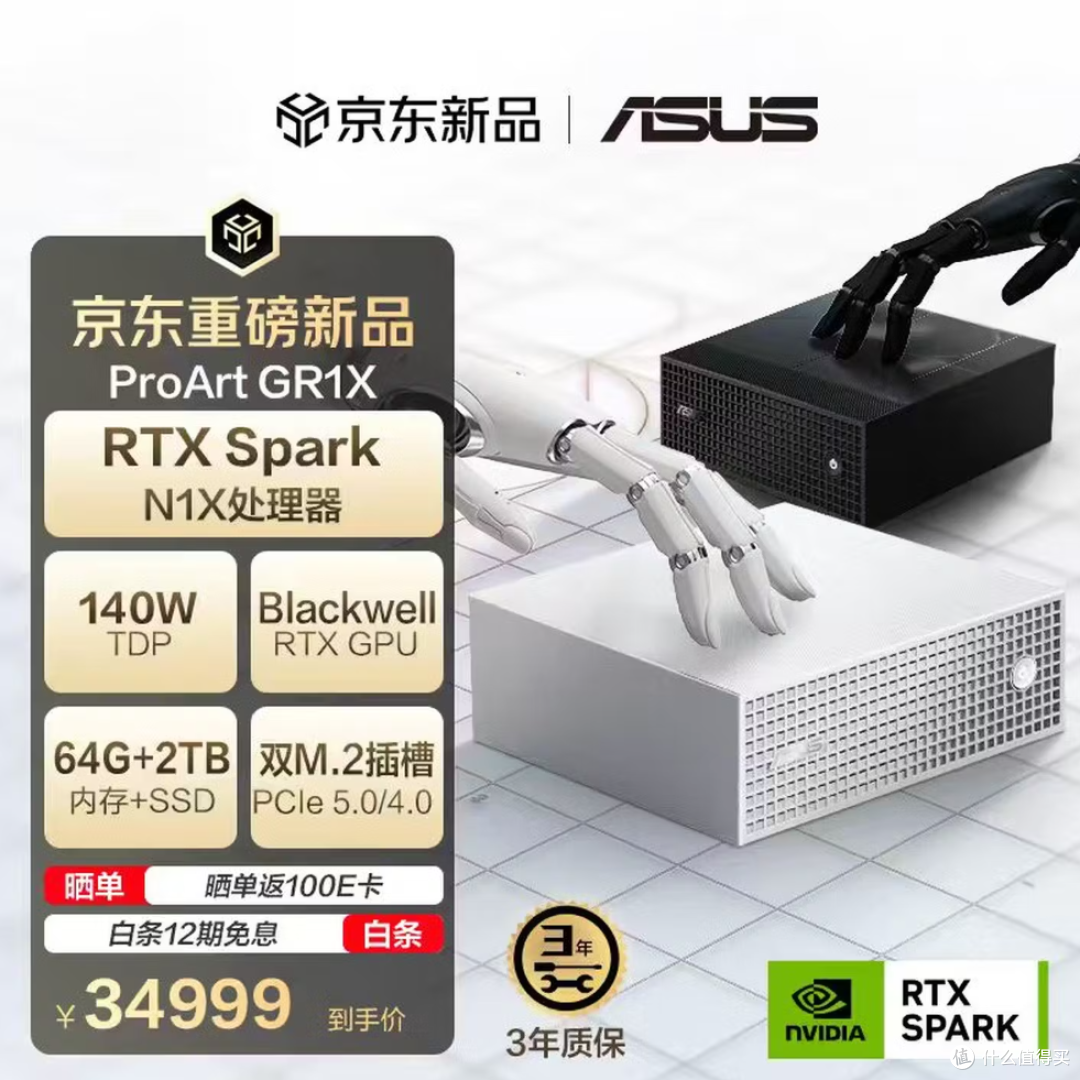
华硕ProArt GR1X:34999元起
华硕ProArt GR1X提供两个配置版本,128GB+4TB版本54999元、64GB+2TB版本34999元。机身尺寸150×150×51mm,提供星耀银、曜石黑两种配色,延续ProArt系列设计语言。整机支持140W TDP功耗释放,搭载双风扇散热结构,配备双SSD位,至高支持PCIe Gen 5 NVMe SSD,高负载场景下可稳定运行。
扩展性上支持四屏输出,HDMI 2.1最高支持8K视频输出,搭配三路20Gbps USB-C接口,另有一路USB 3.2 Gen 2x2 Type-C负责供电输入,搭配10G万兆网口与肯辛通锁孔,适配工作室与专业创作场景。
本地算力新选择,和云端形成互补
三款机型共享RTX Spark超级芯片与统一内存的基础能力,在定价、散热方案、接口与存储配置上各有侧重。其中机械革命在同内存档的价格更优惠,对预算敏感、希望控制本地AI使用成本的用户更值得关注。
本地算力并不是要完全替代云端,而是为本地AI部署提供了一种新选择;遇到超大规模的重度计算任务,依旧可以和云端协同。随着这批全球首批发售的RTX Spark主机推向市场,本地AI的硬件选择变得更丰富。对于在意数据隐私、需要长期运行AI智能体、不想持续承担云端Token成本的用户,这类小型桌面算力终端值得纳入考虑范围。仅供参考!
当前文章无评论,是时候发表评论了