这周用AI编程的人,信息流基本是爆仓的:
9月22日,小米开源 MiMo-V2.6 Pro/Flash,当天登上 Artificial Analysis 开源模型智能指数第一(46分);xAI 同日发布 Grok 4.7,官方副标题写着"Twice as fast, at half the price of comparable models"。哔哩哔哩
9月23日凌晨,Anthropic 跳过原本内测的5.2,直接发布 Claude Opus 5.5:API定价每百万token输入4美元/输出20美元,官方称运行成本比 Opus 5 低约40%;OpenAI 同日推出降价版 Sol/Luna 应战。知乎知乎
B站AI早报单期冲到10万+播放,知乎"如何评价Opus 5.5"两三个问题同时挂热,评论区最高赞的问题是:“Cursor 60美元和20美元的套餐,到底选哪个?”
对每个月拿真金白银交订阅的人来说,真正的问题从来不是跑分好不好看,而是:这些"半价"“省40%”,能不能变成下个月账单上少掉的钱?这篇不堆评测,直接拆账。
先给结论(对三类人)
主力做重构、代码审查、长程Agent任务的付费用户:Opus 5.5的"便宜40%"有真实的成本结构支撑(单价降+单任务token降,缓存读取压到$0.2/M),值得开个小任务实测一下额度消耗率再决定加不加仓。
指望Grok 4.7"比4.6还便宜一半"的用户:官方标准版的价格和速度都和Grok 4.6一致,"速度翻倍、价格砍半"是相对竞品说的,不是相对昨天的自己——这句营销话术,是本轮最容易误读的一条。
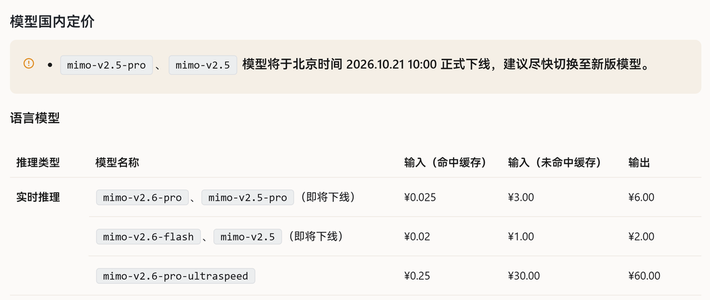
想用开源/低价模型压API成本的用户:MiMo 2.6 Flash单价确实低、无峰时定价,适合后台跑长任务;但评论区"雷霆大思考"的反馈非常集中,别拿它当要即时反馈的主力。另外还在用 mimo-v2.5 系列的,旧版本10月21日10:00下线,迁移窗口已经进入倒计时。
Grok 4.7的"半价":一半是参照物的魔术
先看官方公告的精确口径:Grok 4.7标准版定价每百万token输入2美元/输出6美元(缓存输入0.5美元),与Grok 4.6完全一致;提示词超过20万token后,输入/输出单价直接翻倍到4/12美元。想要"快一倍"?可以,Fast版本单价也是两倍,而且只在Cursor和Grok Build提供,不进公开API。微信公众号
所以"半价、翻倍"的真实含义是:它比同档竞品便宜、比竞品快,而不是它自己降价了。xAI把钱押在能力上:CursorBench 4.0从Grok 4.6(High)的40.4%提到4.7(xHigh)的46.3%,DeepSWE v1.1拿到71.0%,上下文给到50万token。微信公众号
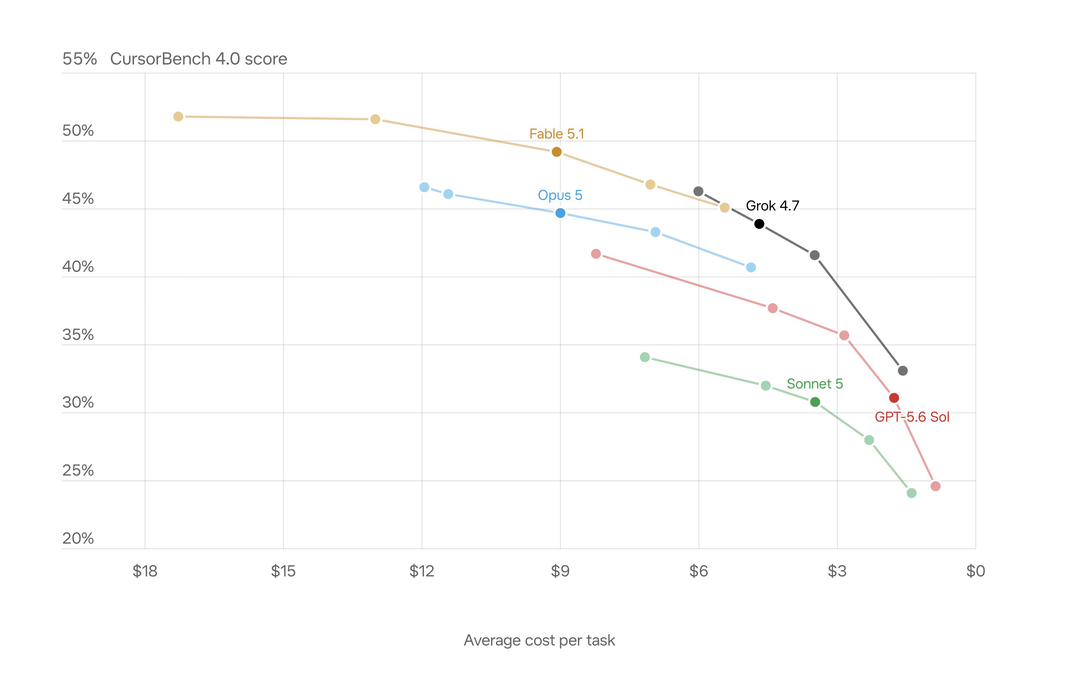
社区买不买账是另一回事。B站UP主"渐近自由JJZY"那期3.8万播放视频的置顶评论(99赞)相当不留情面:“Terminal-Bench 4.0比不过DS v4.1 Flash、能力比不过Kimi K3、还不如MiMo v2.6”。经典鹈鹕骑车SVG测试被弹幕刷"很唐";NixAI实测结论是"任务成本更高、完成效率更差,比4.6更难推荐"。另一边,译制的海外测评却说"跑分紧咬Opus 5、token消耗更低"。同一个模型,官方分、国内实测、海外实测三个口径互相打架——现在下"Grok 4.7全面升级"的结论,证据不够。如果你本来就停在4.6,等更多第三方长任务实测完全来得及。哔哩哔哩哔哩哔哩
Opus 5.5的"省40%":两个因子相乘,还有一个你没想到的坑
Anthropic公告里的"运行成本比Opus 5低约40%",拆开是:单价降(Opus 5是$5/$25,5.5是$4/$20;对比Fable 5.1的$10/$50,输出单价直接2.5倍差)×单任务消耗token更少。对长程Agent真正伤钱的缓存读取,这次压到了每百万token 0.2美元(写入5美元)。知乎
更可信的样本来自知乎用户的一个A/B:同一篇未投稿论文,在Cursor开两个会话分别用Fable 5.1和Opus 5.5评审,Fable吃掉20美元套餐约4%的月额度,Opus 5.5约1%;两份审稿结论质量接近,Opus 5.5还多追问了论文前提。作者自己先泼冷水:单样本、单任务,而且4倍差距里有2.5倍是标价差——“单价便宜的模型如果反复返工未必便宜,单价高的如果一次做对反而划算”,任务成本才是那本账。知乎
值得表扬的是官方态度:公告里主动写"到这个能力水平,benchmark的差距越来越不能反映真实差异"。厂商第一次给自家跑分降温,等于明示你们去看账单。知乎
但有个技术细节必须知道:官方测试里的Opus 5.5开着production safeguards——网络安全类任务实际路由给Opus 4.8,生物与前沿LLM开发任务交给Opus 5完成。你调用的从来不是一个checkpoint,而是一个"模型+路由+安全层"的系统。以后任何测评标题写"XX模型实测",先问一句:测的是哪一层?知乎
MiMo 2.6:参数表给一半诚意,体验还欠一半
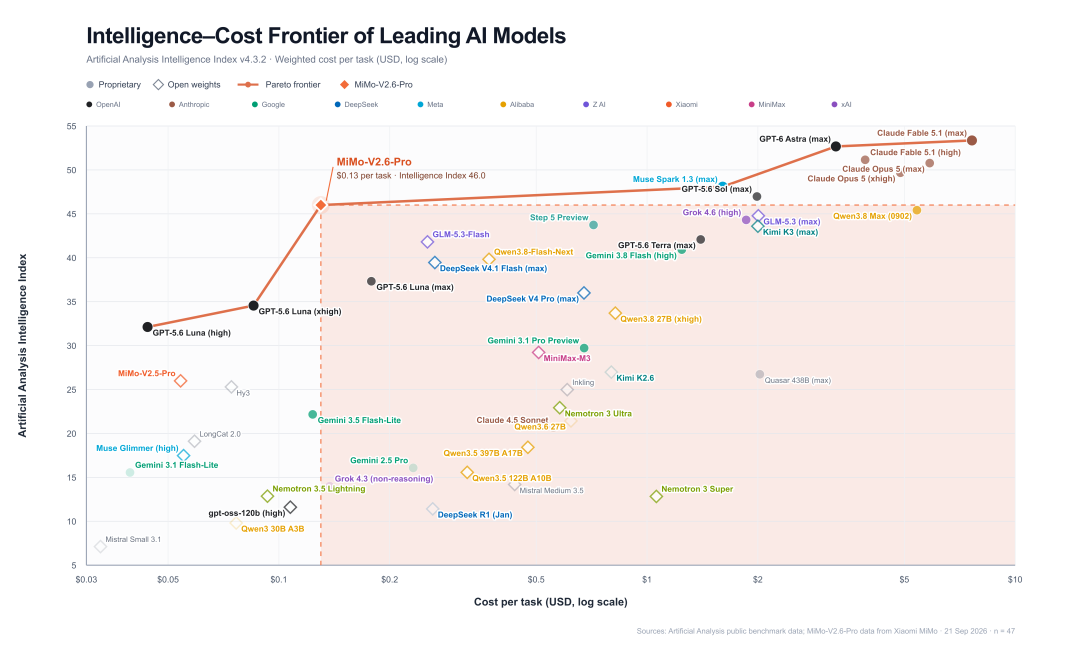
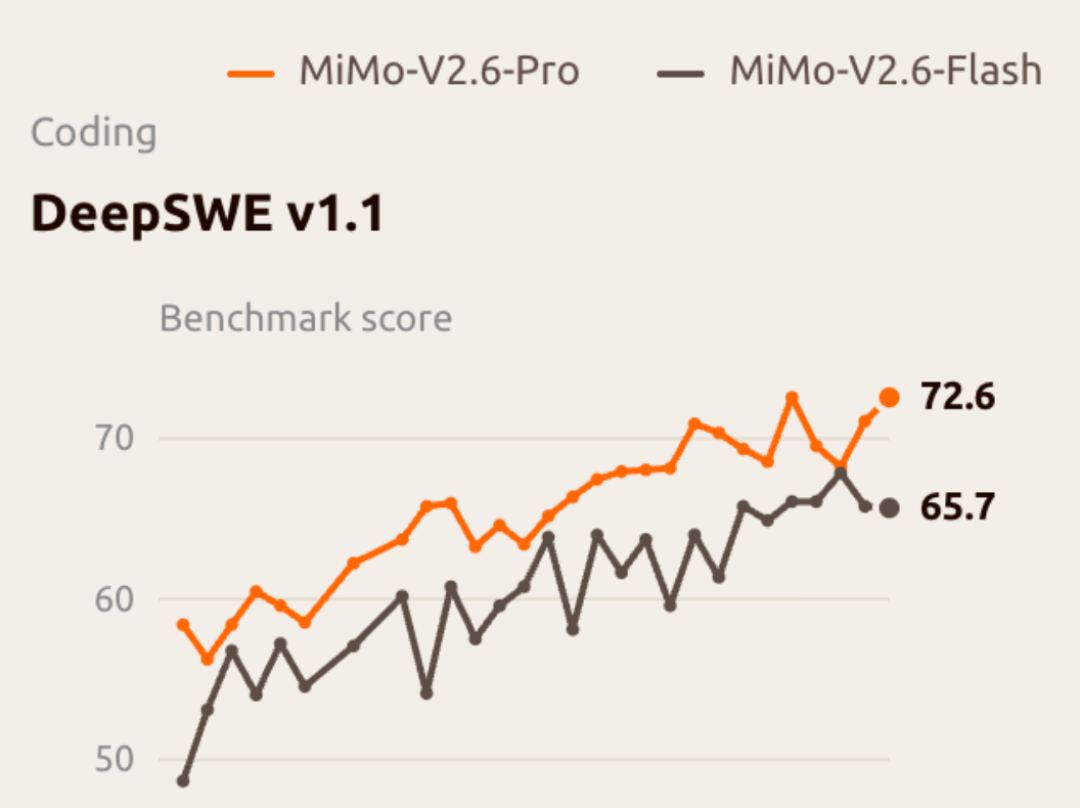
这次小米把账本摊开给你看:Pro为1.02T总参/42B激活的稀疏MoE,Flash为309B总参/15B激活,全部原生全模态+1M上下文;技术报告连训练成本都公开了——不到6天完成30步强化学习,Flash花了约85万美元、Pro约262万美元,累计约75万条轨迹;权重、蒸馏模型、7K+个RL环境、端到端训练框架一起开源。API价格沿用V2.5。Artificial Analysis智能指数46分,高于Kimi K3和Qwen3.8 Max,官方称多项Agent基准接近Claude Opus 5和GPT-5.6 Sol。微信公众号哔哩哔哩
然后你翻到评论区,会看到公告里没有的另一半。吐槽最集中的是"雷霆大思考":有用户让Flash执行一份已经由顶模写好的计划,光是"读计划并执行",每次调用思考五六分钟,一次任务烧掉1.11M tokens、其中12万全是输出里的思考;有Pro用户跑一个代码审核子任务,两小时没跑完;最惨的新注册用户拿5块钱体验金让Flash分析一段错误日志,死循环烧到402欠费,项目代码还没读完。评论区锐评一针见血:“跑分王,体验亡”。哔哩哔哩
但也有清醒的反向声音:“便宜是真的便宜,Flash比DS v4.1F更听得懂人话、没有峰时定价,适合养后台干脏活”;“Pro慢工出细活,结果确实不差——长任务丢后台跑,敏捷开发还是用Flash档”;还有人实测"desktop版比CLI强一百倍,能用了"。把这几种声音合起来,MiMo 2.6的正确用法其实很清楚:当廉价后台工人,账算得过;当即时响应的主秘书,会绷不住。哔哩哔哩
一张对照表,两种口径
Opus 5.5 | Grok 4.7 | MiMo-V2.6 Pro/Flash | |
|---|---|---|---|
发布 | 9月23日 | 9月22日 | 9月22日(开源) |
标价(输入/输出,每百万token) | $4 / $20(缓存读$0.2) | $2 / $6(>20万token提示翻倍至$4/$12) | 沿用V2.5定价 |
官方主打 | 比Opus 5成本约-40%,逼近Fable 5.1 | CursorBench 46.3%、长任务与自检 | AA开源榜46分、全模态、训练成本公开 |
Terminal-Bench 4.0(官方口径) | 66.4% | 38.0% | 未列 |
社区主要存疑点 | 省额度仅单样本验证 | "不如4.6"声音不小 | 大思考耗时、死循环烧钱 |
同一个Terminal-Bench 4.0,66.4%对38.0%,28个点的差距全在官方公告里;而两家官方都默认了同一件事:跑分和钱包之间,隔着一个叫"返工率"的变量。知乎微信公众号
下一步动作与观察清单
别急着换订阅,先做一次"任务成本"实验:拿你现在的套餐跑一个小而真的任务(一次code review或修一个bug),记下额度消耗率、交互轮次、返工次数。拿这个基线去对"40%"“四分之一额度”,对得上再换仓,对不上就当没看见发布会。
Grok 4.6老用户不用焦虑:4.7同价同速,你没有被版本抛弃的成本风险,实测样本攒够了再说。
接了mimo-v2.5 API的,把10月21日下线写进日程;想试2.6,建议Flash档+桌面端+非即时任务起步,顺手设个用量提醒——那位5块钱烧到欠费的老哥,起点也只是"试试"。微信公众号
要用Opus 5.5跑安全研究、生物相关任务的:知道会被路由给4.8/5系模型,行为风格和评测里那个5.5可能不是一个味道。
接下来的观察信号:Gemini 4 Pro(这周唯一还没亮牌的头部厂商)、阿里Qwen4四款"已宣布未定档"、马斯克放话"4.8也训完了"、以及最关键的一条——Opus 5.5"省额度"能不能从单样本变成社区统计。哔哩哔哩哔哩哔哩
最后记录一组反方观点,供你校准:社区里始终有人坚持"这波价格战是发布会营销,订阅根本不用动"——知乎有热门回答直言现在的榜单离顶级程序员的真实任务太远、“我只看ProgramBench”;评论区也有"AA榜单野鸡"的调侃。这些声音值得留着,但对你来说,它们和官方跑分一样,都只是别人的数字。这轮混战唯一值得马上做的,是把它变成你自己的数字:花半小时跑一次任务成本基线,以后每次发布会,你都用账单投票,不用情绪投票。哔哩哔哩知乎