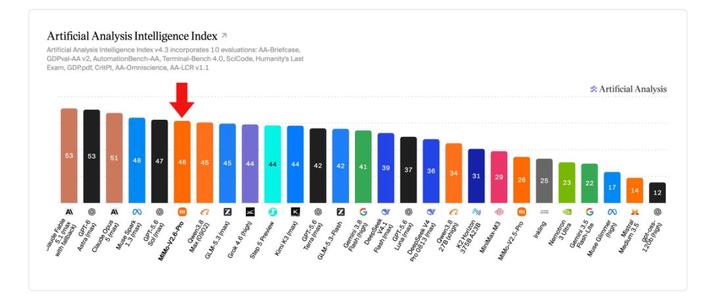
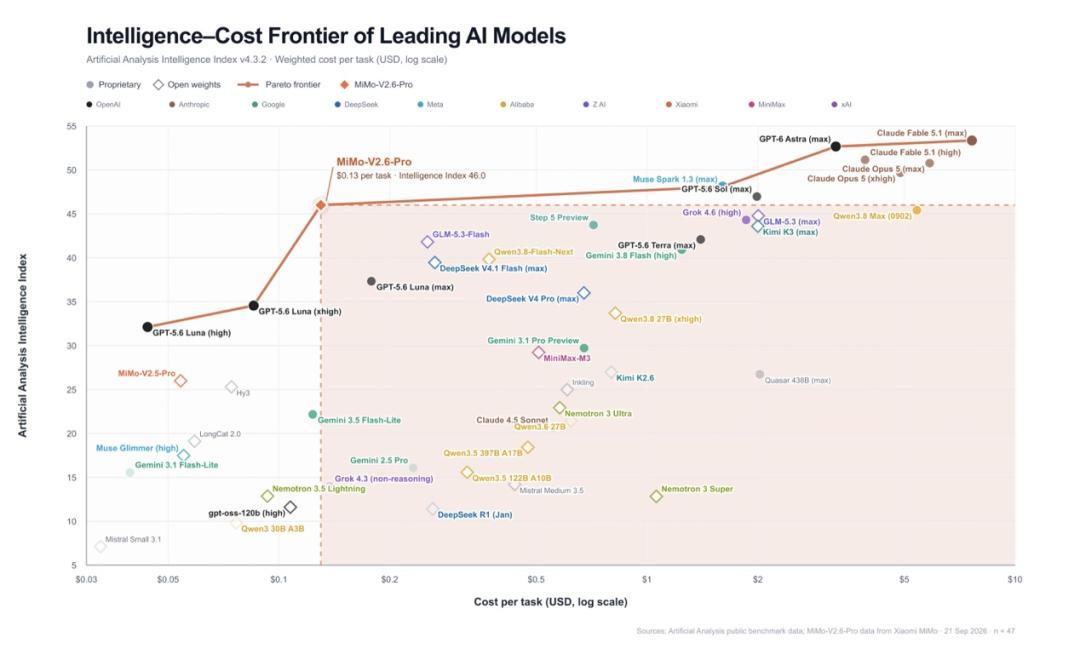
9月22日凌晨,小米把MiMo-V2.6直接开源了——不是只放权重,连强化学习训练后的RL版本一起放,Pro和Flash两个原生全模态模型。小米技术官方微博宣布后,ArtificialAnalysis综合智能指数榜单上,MiMo-V2.6-Pro以46分冲到114个开放权重模型第一,压过Kimi K3和Qwen3.8 Max。微博科技号连夜刷屏,罗福莉一篇《扩展强化学习规模的艰难之路》被开发者社区转发到手软。哔哩哔哩微博
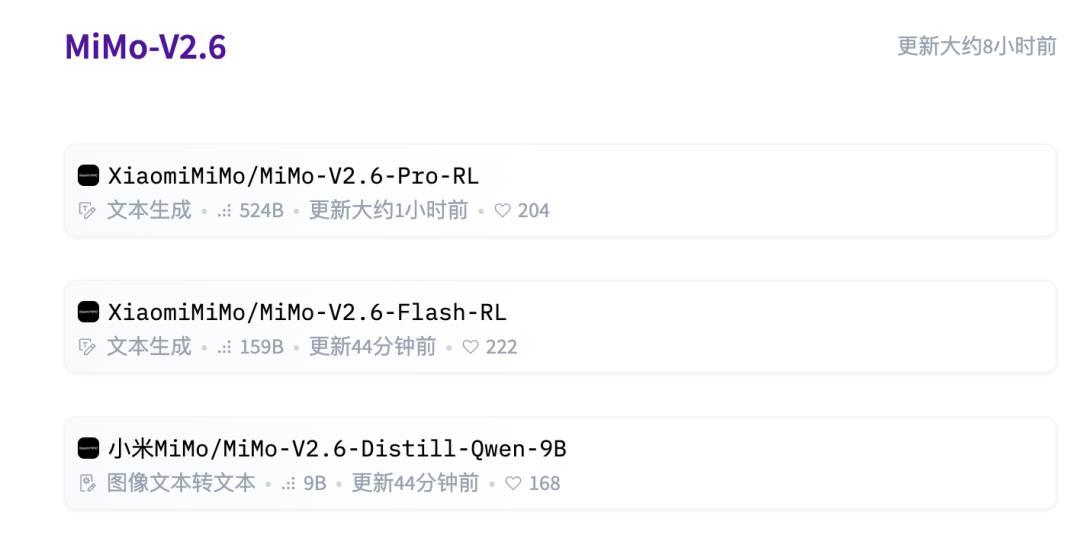
但本地党真正关心的事,从当天下午就开始霸屏各平台:这次不是"又一个跑分新闻",而是9月这波开源模型,密集到普通人的电脑第一次有点"吃不下但够得着"的味道。我花两天把知乎、B站、小红书、微博这72小时里的实测帖过了一遍,发现大家吵的根本不是榜单,而是三个非常具体的问题。
一、这周全网在问的,其实就三个问题
“9月的新模型,我的卡能跑哪个?” 这是知乎问题池和本地部署社区里密度最高的一类提问。小红书那篇《本地跑大模型到底要多大内存?一个公式秒算》800多赞、1000多收藏,评论区几乎全是报配置求判的;B站"从4GB到512GB显存都能跑"这类按显存分档选模型的视频,本周也是稳定产出。小红书哔哩哔哩
“能跑起来,等于能用吗?” 这是吵得最凶的一点。能打开网页聊天框当然叫能跑,但连续干十分钟活、内存不被吃光、速度不掉线,才叫能用。
“要不要为本地AI升级硬件?” 一边是"为了跑模型换16G显存卡值不值"的账,一边是"为什么苹果能堆128G统一内存,NVIDIA消费卡卡死24G"的经典争论,9月又被M5 Max的实测数字点了出来。知乎哔哩哔哩
二、先给结论:9月模型×硬件档位对照表
把本周各博主的公开实测拼起来,按你手里的硬件对号入座即可(速度均为各家自测,环境不同会有出入,当量级参考,别当标准答案):
你的配置 | 这一波能跑什么 | 实测口径 |
|---|---|---|
无独显/16G内存 | Q4量化的9B级小模型(Qwen3.5-9B、Ornith-1.5、MiMo-V2.6的9B蒸馏版) | 知乎博主"实名用户"9/23连测多款,9B级Q4量化是当前8G显存16G内存机器的甜点 |
8G显存 | 文生图QwenImage2.1(社区有6G显存可用的工作流)、部分量化9B视频对话类应用 | B站UP主实测ADM集成Qwen-image-2.1后8G显存可本地出图 |
12G显存 | Qwen3.8-27B量化+长上下文 | 知乎"随便看看"9/23用kvmem把上下文交换进内存,5070Ti笔记本上27B模型128K上下文、decode 50+ tok/s |
16G显存 | Qwen3.8-27B的IQ3_S量化(11.8GB),AIME25、LiveCodeBench与基础模型持平 | ISTA-DASLab出的GSQ+RCO非均匀量化,被4060Ti 16G+32G内存机器实测验证 |
Mac 24-64G统一内存 | 中量级模型推理、9B蒸馏版全模态 | oMLX、Edge0这类工具把模型放硬盘、按需载入,宣称提速最高59%;海外博主测M5 Max跑千问到144 tok/s |
Mac 128G+/工作站 | 30B-70B量化、MoE大总参模型 | B站已有博主拿M3 Ultra 512GB部署MiMo-V2.6-Distill-Qwen-9B,测长上下文和Agent场景 |
只有16G内存的旧笔记本 | 744B级MoE也能"活下来" | GitHub 3.1万星的colibri把NVMe当显存用,按专家路由热度流式读权重,速度取决于你的硬盘 |
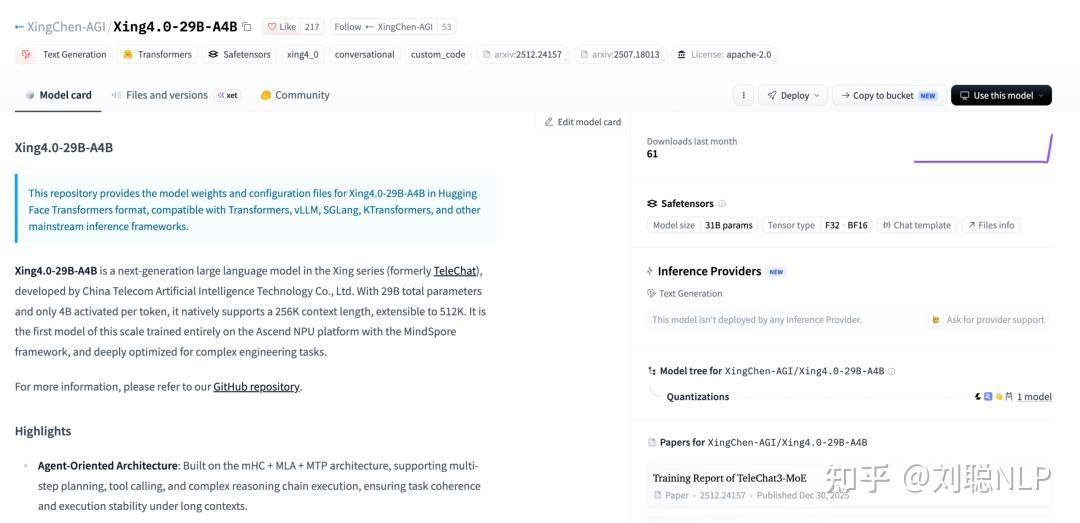
这张表里最有信息量的不是哪个模型多强,而是一个共同趋势:9月能进普通家里的模型,全是"小激活参数"路线。Qwen3.8-27B是稠密架构,跑得动但慢,于是社区才会在9/22热捧电信的Xing4.0-29B-A4B(30B总参、激活只有4B)和Ornith-1.5-35B-A3B这类MoE;MiMo-V2.6 Flash同样是稀疏MoE,蒸馏出的9B版才是本地党的真正入口。哔哩哔哩知乎
总参数是厂商的军备竞赛,激活参数才是你显卡带宽的生死线——这一点,绝大多数单篇测评不会替你串起来。
三、"token自由"的另一面:赛博守夜
看到这儿别急着上头。本周传播最广的反方证据,是知乎"二冰"用一台8G显存笔记本搭完整视频生成环境的实录:官方推荐32G内存的活,他16G内存硬着头皮跑,系统可用内存能掉到1G出头;一条5秒带音轨的视频,单镜出片约11分钟,一条完整短片拆九个镜头,串行跑下来快两小时,显卡全程占满,电脑什么都干不了。他管这叫"赛博守夜"——本地部署,token是自由了,但你的人被绑在了进度条前面。知乎
另一篇低配部署的长文(知乎"AI工具小栈",9/22)给"值得折腾"划了更清醒的前提:门槛不在显卡,在内存容量和耐心;只适合"明确、高频、文件必须留在自己电脑里"的文字类任务——整理内部资料、固定格式文档、辅助写代码。偶尔问两句的,云端更省事。它顺带点破了一个几乎没人提的误区:离线不等于安全,插件、调试日志、联网接口任何一环都可能把数据带出去;本地起的API服务,没配认证防火墙之前只监听127.0.0.1。知乎
工具链的选择倒是已经收敛了,直接抄作业:想快速跑通顺便给其他应用供API,用Ollama;追求低资源和兼容性,上llama.cpp;不想碰命令行,LM Studio;要统一管理模型加知识库,再叠一层Open WebUI。量化从Q4起步,别一上来就下最大的。知乎
四、要不要升级:先看一个阈值价格
这轮对照表看下来,本地生成的硬件阈值其实非常清晰:16G显存是2026年9月的甜点线——11.8GB的"任务无损"27B正好躺进去,还留得出KV缓存的余量。而据站内商品数据,RTX 5060 Ti 16G已经落到2699元价位段(七彩虹,天猫百亿补贴口径;华硕TUF款3019元),往上5070 Ti 16G在7099元起步。也就是说,"无损跑27B"的门票已经不是万元工作站,而是两千多。有博主晒的正是去年花2800买5060Ti 16G入坑本地——这笔账在2026年9月,对高频用户已经算得过来了。知乎
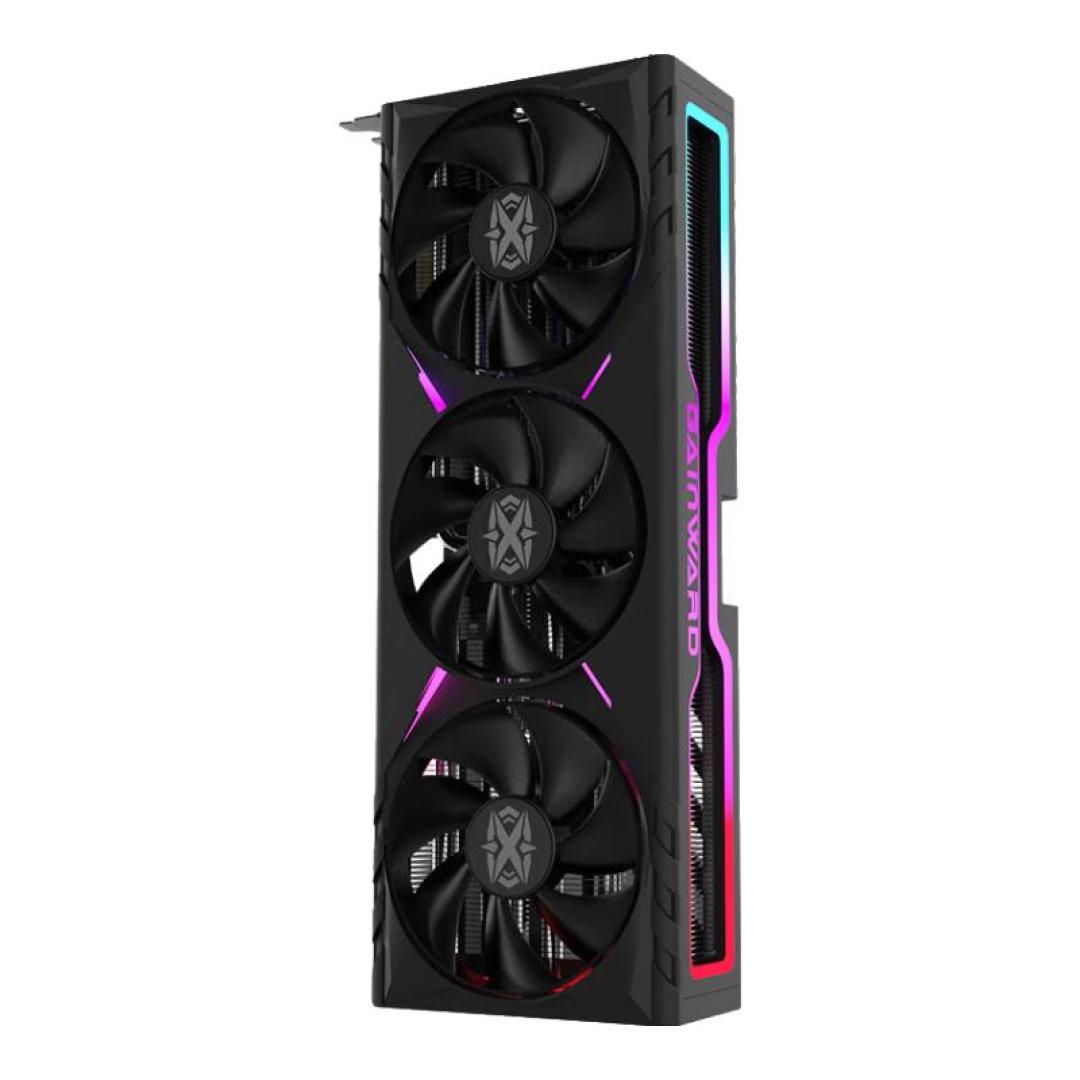
至于"攒显卡还是上Mac":消费N卡的逻辑是显存带宽硬、推理快、生态全;Mac统一内存的逻辑是能塞进同价位N卡给不了的容量(M4 Max轻松128G),配合oMLX、Edge0这类硬盘换入内存的新工具,"大模型装进小内存Mac"正从玄学变成日常。9/24刚放出的RTX PRO6000 96GB对M5 Ultra 512GB的十几万工作站之争,本质是这个分叉的极端版本——个人用户大概率用不上,但它说明了一件事:本地生成的硬件路线,已经正式分裂成"N卡跑快"和"Mac跑大"两条。哔哩哔哩哔哩哔哩
五、谁现在上车,谁再等等
建议直接上车的:手里已有16G显存N卡或24G+统一内存Mac、且有高频出图/出文档需求的人——9月这波(QwenImage2.1、MiMo蒸馏版、27B无损量化)刚好都是给你们准备的;以及工作内容涉及不能上传的合同、内部资料的,本地是目前唯一干净的解法。
建议再等等的:8G显存以下只想尝鲜的、指望"跑起来就等于生产力"的、以及还没想清楚自己周产出量的。colibri这种硬盘流式方案把744B的门槛打到了16G内存,但它改变的是"能不能装下",不是"能不能用"——速度仍然取决于NVMe和模型激活量。知乎
接下来盯三个信号:一是colibri、kvmem这类"存储换显存"工具会不会被Ollama/LM Studio原生吸收——一旦被产品化,旧电脑的判决会重写;二是MiMo-V2.6和Qwen后续会不会放出A3B-A4B级别激活的更多尺寸,"激活参数军备竞赛"才是本地党真正的春天;三是显卡价格,5060 Ti 16G这条2700元线如果失守(涨回去),"为本地AI配卡"的窗口期就算关了。
这波开源潮里,真正变了的不只是模型分数,而是"够得着"的定义。你手里的机器大概率比你以为的更能干——但能不能干,别问参数表,问你的硬盘和进度条。