编程圈脾气最臭的男人,改口了。
最近有开发者刷新Linus Torvalds的个人Linux内核仓库时,发现了一个名字扎眼的新分支:noref-filemap-read-with-llm。后缀「with-llm」明明白白写着——这份代码,有AI参与。新智元
补丁说明里,Linus大方承认:实现代码、测试程序、问题分析,连说明文档初稿,都是Claude Code在他指导下完成的;性能测试由他本人在自己机器上跑。那个说过「AI九成是营销」的人,真香了。全球主机测评cnBetaIT之家新智元
AI干了什么:让「读同一个文件」快了3倍
动刀的地方是内核最核心的页缓存读取路径。
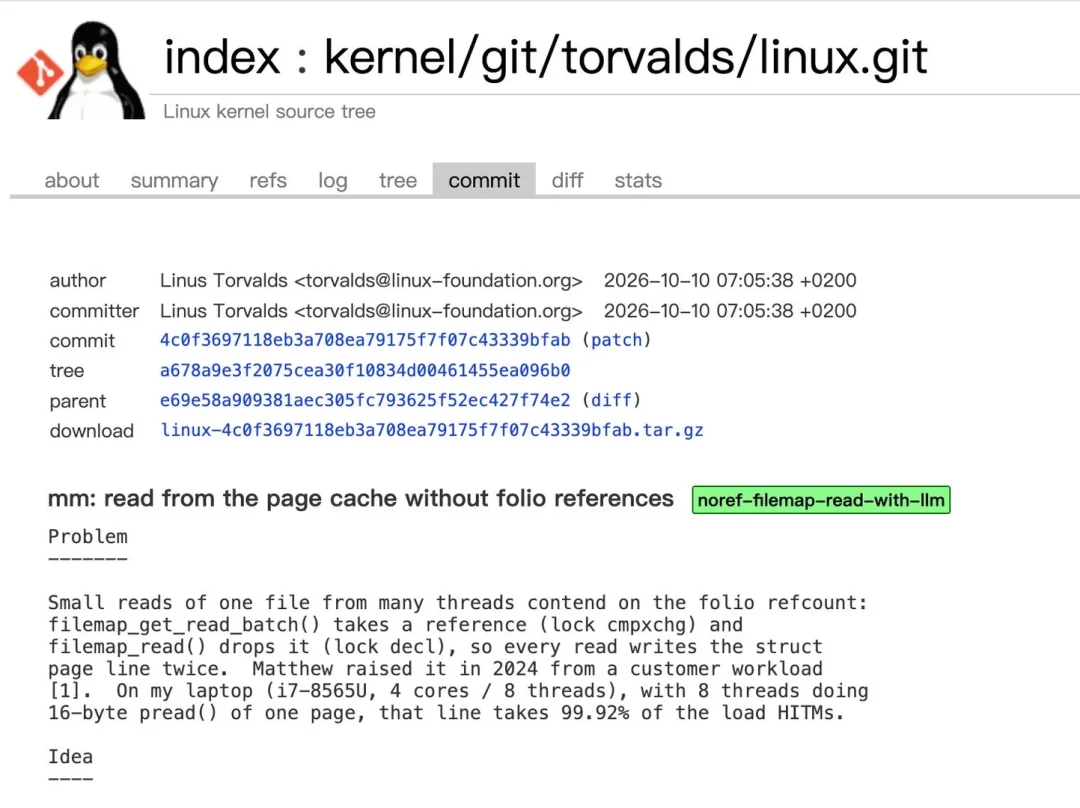
说人话版:Linux把文件数据缓存在内存里,读取时直接取缓存。但原有机制要求每次读取,都得给承载数据的内存块(folio)引用计数加一、读完减一。8个线程同读一个文件,就是8个人抢着改同一张登记表,CPU核心为这条缓存行来回颠簸。单次只读16字节,读取本身飞快,「登记」反倒成了瓶颈——Linus测试机上,它占全部Load HITM开销的99.92%。这颗雷2024年就被内核开发者Matthew Wilcox指出,来自真实生产环境。新智元
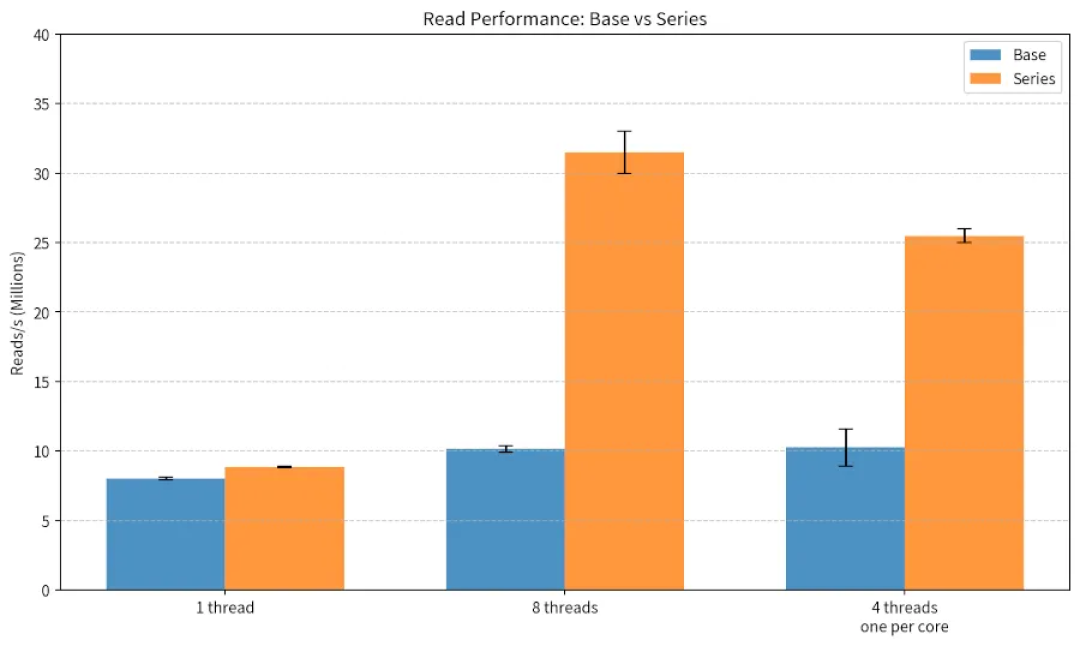
这次的思路:不再每次翻页都登记,改用RCU机制延迟释放——缓存内存被移除后,晚一点再归还给分配器,保证正在读的人安全读完。结果:一台i7-8565U(4核8线程)笔记本上,8线程反复读同一个文件,吞吐量提升到约3倍;单线程提升约一成。IT之家新智元
但真正的看点,是他接着写了什么
如果你以为这是「AI让Linux快3倍」的爽文,那就低估了。同一份补丁说明里,Linus把丑话也全写了:某些场景新路径反而回退——单线程16字节读取尚未建立映射的内存页时,内核CPU周期从约4100~4200涨到约6500~6600。尚未解决的问题他也逐条列出:内存分配器无法完整感知等待释放的页面、连续内存分配可能受影响、部分架构和测试配置尚未验证,一项测试甚至暴露过内存不足。全球主机测评
而且这只是实验分支,尚未合入主线内核。特定微基准3倍,不等于整个Linux快3倍。漂亮数据和难看的回退一起摊开,这才是Linus。IT之家
第二天,AI又挖出13年前的旧账
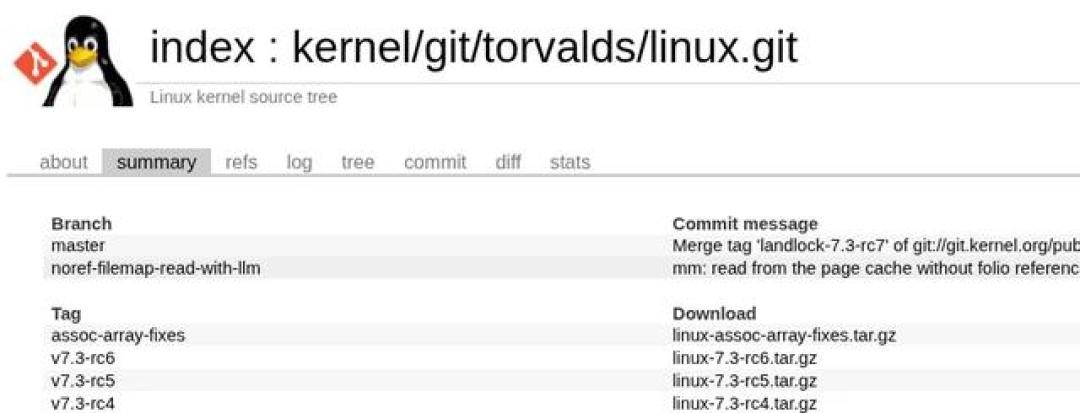
故事没完。分支出现第二天,仓库里又冒出一个assoc-array-fixes。起因是开发者Nils Ollrogge提交了一份bug报告,但那段关联数组代码写于2013年,晦涩到Linus本人都难以跟清逻辑。他借助大模型把庞大函数拆开、理清边界,再放进用户态测试框架里跑——除了确认报告的问题,还额外挖出3个bug。新智元
四个缺陷全部能追溯到2013年这个库合入内核的首次提交。IT之家新智元
一份bug报告,牵出藏了十三年的三处暗伤。
对用AI写代码的你,意味着什么
Linus这套打法就是普通人的标准答案:AI出实现初稿、写测试、梳理问题、起草文档;但改什么、对不对、怎么验证,牢牢攥在人手里;验证数据、性能回退、遗留问题,如实公开。
AI已经走进了系统编程最硬核的深水区,但入场券不是「生成」,是「验证」。Talk is cheap——只是这一次,连code都不用自己敲了。真正值钱的,是知道该写什么代码,以及判断写出来的代码对不对。