10月17日,DeepSeek把V4.1-Flash升级到V4.1-Flash-1017,官方公告直接把标题写成 Wish-Driven Programming Made Real——此前还被用来嘲讽说不清需求的“许愿式编程”,这次成了官方卖点。网页端、App与API当天同步切换,模型价格不变,权重也已开源。DeepSeek官方文档新智元
“许愿”靠的是模型自己批改作业
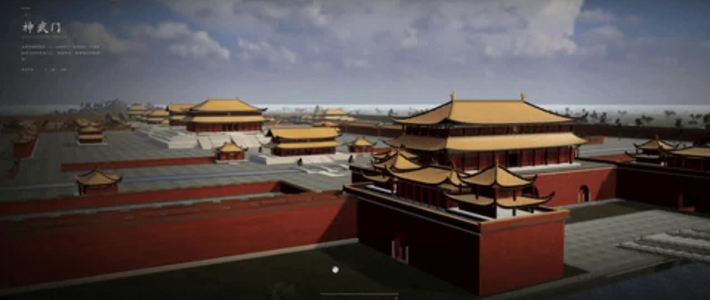
以前让AI做项目,得把功能、结构、技术栈掰开了一项项讲;现在只要说清楚想要什么,剩下的规划、写代码、运行、检查和修改,模型自己接着往下推,背后靠的是一套基于自反馈的强化学习——模型写完第一版不立刻下班,会检查自己做出的东西,发现不对再回头修。随更新放出的四个官方演示:3D故宫、网页赛车游戏、用Godot引擎做的《传送门2》复刻、从史前演变到现代的动态城市Valley of Ages,起点都是一句话需求。梨视频DeepSeek官方文档
分数全涨,但别按字面读那张对比表
官方对比表里,1017较上一代在11项基准测试中全部上涨。几项代表成绩的变化更能说明方向:Terminal-Bench 4.0从31.2升到42.3,ProgramBench从20.3升到29.1,软件工程Agent基准DeepSWE v1.1从74.2升到77.0。知乎新智元
这张表要带着脚注读:不同测试用的评测框架并不相同,Terminal-Bench走Claude Code框架,DeepSWE用Mini-SWE-V2,HLE只测了文本子集——模型之间的横向分数看趋势就好,抠到小数点会读出错误结论。知乎
比涨分更值得盯的是账单:在DeepSWE v1.1上,新版max档通过率77%,平均每任务费用1元到2元;上一代通过率74.2%,每任务要3元到4元,近乎减半。通过率更高、花钱更少,DeepSeek把这称为性能与成本的帕累托改进——输出比上一版短,任务结束得更快,API的token单价没有变。计费规则里还有一个现成的省钱开关:高峰时段为工作日的白天,其余时间均为半价。新智元DeepSeek官方文档DeepSeek官方价格页
一周之后:语义翻转,“抠门”上了热搜
舆论场上有个耐看的插曲:这个词的语义一周内完成翻转——发布前“许愿式编程”是骂人话,讽刺小白不会用AI;发布后它成了夸奖,说明模型很强。质疑同样存在:外国模型擅长许愿编程被夸作“Vibe Coding的灵魂”,国产模型能力追上来,就被改称“针对许愿式编程特化”,标准似乎是浮动的。至于同期流传的“蒸馏GPT”指控,目前没有任何权威第三方验证,只能算口水战。知乎知乎
10月25日一早,“DeepSeek新版本太抠门”挂上微博科技热搜,和一排AI词条同屏——这轮大家聊的已经不是模型有多聪明,而是它的代价。AI博主karminski-牙医的实测印证了观感:后端Agentic Coding和前端能力确实接近官方描述的许愿式编程,但这个Agent被训练得过于抠门,做事一旦有代价,它倾向于不做。他同时提醒:把旧版Flash接进自家Agent框架的开发者,升级前先单独做适配,否则大概率翻车。另一部分用户反馈,1017在文字创作和角色扮演场景反而不如旧版。“抠门”与“输出更短”出自同一个训练取向:这次升级明显把资源押在把活干完上,聊天体验和文字惯性要付出代价。赛博茶馆微博知乎
打算用新版的,先做三件事
第一,升级是平滑的:API的调用方式和单价都没变,继续用模型名deepseek-flash就能调用新版。想吃满全部优化,需把DeepSeek Harness升级到v0.2.1-rc.1及以上,官方点名腾讯CodeBuddy、WorkBuddy也获得了专项适配。第二,盯住计费节点:随新版开放的Search/Fetch接口,目前经由Harness、Claude Code、Codex发起的服务端工具调用尚未收费,11月1日起将按次收取调用费,重度依赖Agent联网搜索的要先算账。新智元DeepSeek官方文档DeepSeek官方价格页
第三,校准预期:它擅长把一句模糊需求从零变成能跑、能玩的交互原型,但在最难的通识推理和长程任务上,与旗舰档模型仍有差距——把批量任务排进空闲时段,把它当成便宜、能干、随叫随到的干活搭子,眼下是最划算的用法。知乎