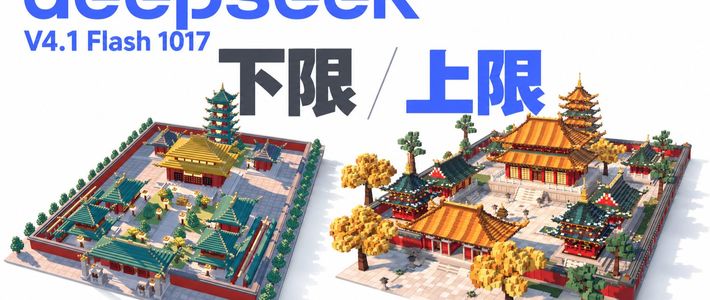
10月17日,DeepSeek把V4.1 Flash更新到V4.1-Flash-1017(社区简称V4.1F 1017),网页端、App、API三端同步切换。第二天,一位B站UP主用双盲方式给这个版本做了"上下限测试":同一道题反复生成,看最好和最差能差多远,标题里留着疑问——“依旧神神鬼鬼?”。结果是:上限能摸到Claude Opus级的输出,下限只到国产模型中游,有参与盲测的用户形容"它这个上限实在太强了,但这个下限拎出来只能说,在当前的环境(把小红书、美团、小米那些乱七八糟的模型扔一边去)中,属于中上,但和它的那个上限比大的离谱了"。所以结论很直接:靠模型自身硬知识和深度推理的任务、要求稳定复现的生产管线、一次交付且没有返工预算的高风险项目,这3类需求千万别硬上。哔哩哔哩
它不是新模型,是一次"偏科式"升级
先把更新本身说清楚。1017不是架构换代:官方配置文件和9月10日那版完全一致,7630亿参数的规模没变,MoE的骨架没变;API调用id和价格也没动(输入$0.15/百万token,输出$0.60/百万token,非高峰时段),权重以MIT协议开源,已退役的旧flash型号统一路由到它。官方强调的新能力,来自基于自反馈的强化学习训练,练的是在游戏开发、3D建模等方面"从零开始构建完整项目"的能力。知乎知乎
官方自测对比9月版,11项基准全部上涨,涨幅从2.0分到11.1分;涨得最狠的Terminal-Bench从31.2跳到42.3(相对提升35.6%),ProgramBench从20.3到29.1(相对提升43.3%)——两项都测"能不能在真实环境里把活干完",而不是"知道多少"。知乎
但同一张官方表里,和Claude Opus 5逐项对比是4胜7负,官方宣传只讲了"在4项agentic测试中超过Claude Opus 5"。看懂"全涨"和"只赢4项"并存,就看懂了这个模型:它是能干完活还特别便宜的那个,不是最聪明的那个。知乎
需求一:靠模型自身硬知识和深度推理的,别硬上
11项对比中输得最惨的是HLE(“人类最后的考试”,跨学科硬知识、工具帮不上忙的题型):42.6对56.3,差13.7分。同维度上,Kimi K3的HLE成绩也比它高。知乎哔哩哔哩
根子在架构取舍:5520亿参数的主干,加上1960亿的"Engram"记忆模块,但每处理一个token,输入阶段只激活80亿、输出阶段激活160亿——大存储,小激活。这套设计的收益是快和便宜,代价是遇到需要深度思考而不是熟练执行的任务就露底。知乎
而这次涨分靠的强化学习,练的是执行,不是见识。所以医疗、法律、金融这类依赖模型自身知识深度、错了要担责任的判断,别只交给V4.1F;确实要用,就叠加检索和更强模型的交叉验证。知乎
需求二:要求严格遵循工具链、稳定复现的管线,别硬上
上下限测试的作者自己划了测试边界:只测了前端,不代表其他方面突出,并指出它的指令遵循等问题依旧是Flash模型难解决的通病。这不是理论担忧。有开发者把固定提示词和工具跑了很久、一直稳稳没毛病的长期项目更新到新版后,模型不会看工具了,飘了,自己要搞一大堆东西出来。哔哩哔哩知乎
方向相反的反馈同样存在:一位花约7亿token构建写作Agent的用户说,它严格照提示词办事了,但相应的就是发散性不太好,不喜欢多干活。两种反馈合在一起说明:模型行为在变,给不出稳定预期;盲测区的共识是输出像抽卡,一轮结果证明不了什么。哔哩哔哩
还要留意迭代节奏。10月15日,DeepSeek的对话服务、V4 Pro API和V4.1 Flash API陆续中断,当天13点04分才恢复,开放平台傍晚发布《服务恢复及补偿通知》。36氪当天的报道标题就是DeepSeek服务器全球宕机。对没有人工质检、要求重跑结果一致的自动化管线,这种迭代速度本身就是风险——至少先固定版本号、跑完回归测试再切。知乎36氪
需求三:一次交付、没有返工和验收预算的高风险项目,别硬上
“上限比肩Opus"这句话,两边都要打折扣。故宫3D建模、网页赛车游戏、Godot复刻《传送门2》这些演示是官方挑的案例。社区双盲榜单一度把它抬到第二,但测试发起人自己承认排名是"被离谱地刷到第二了”:多数人测出好几个结果后只传最好的那个,还有人没认真左右对比,有个用户41次选择都是在5秒内做出来的。高分里混着幸存者偏差,上下限之间的落差才是真实分布。知乎哔哩哔哩
判断标准很朴素:项目能容忍多抽几次卡、有人肉验收,1017的上限足够惊喜;如果是对客户的交付、发布会演示、只能跑一次的付费项目,把宝押在抽卡上就不该用flash档位——要么生成多份候选再筛选,要么关键部分换更稳定的模型兜底。
那它适合什么:干活、便宜、快
避开三类需求之后,1017的价值反而更清楚。有用户实测修同一个bug:某顶流模型跑了20分钟没有结果,1017用14分钟修好。AI产品经理Paweł Huryn发布当天的测试则认为,它找bug、修bug的能力接近Opus 5.5 xHigh,价格只有后者的三十五分之一。两个都是个案,但方向和官方基准一致:高频次、成本敏感的执行型任务——补全、批量改代码、跑脚本、搭原型——是它的甜区。知乎知乎
配套的DeepSeek Search/Fetch接口(各5元/千次)目前免费开放,2026年11月1日零时起计费;做Agent的可以把这个窗口用起来,省下的钱和工夫花在验收上。知乎
一句话收束:别被"全涨"迷惑——它11项全涨是相对于自己9月版说的,不是相对于竞品;选模型要对齐任务,不是对齐跑分。知乎