把一段"往杯子里倒水"的视频倒着播,再交给现在最强的视频大模型。它大概率还是会说:一个人正在往杯子里倒水。
这不是某个模型的偶发失误。Vinoground 用成对短视频测顺序,只把前后调换,很多模型的准确率就掉到接近随机。
把视频帧随机打乱再喂进去,不少视频问答的成绩几乎不变。问"他是先开门还是先开灯",模型答对的概率只比抛硬币好一点。知乎
我们以为它在看视频,它其实在看一叠照片。
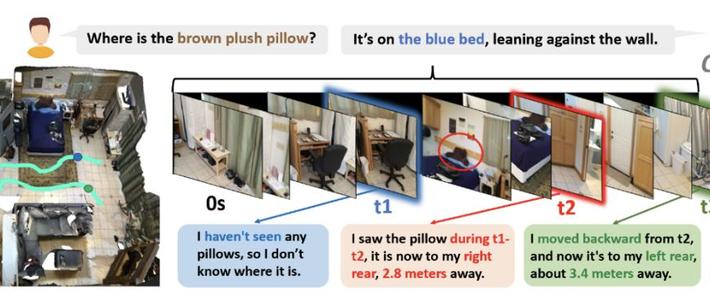
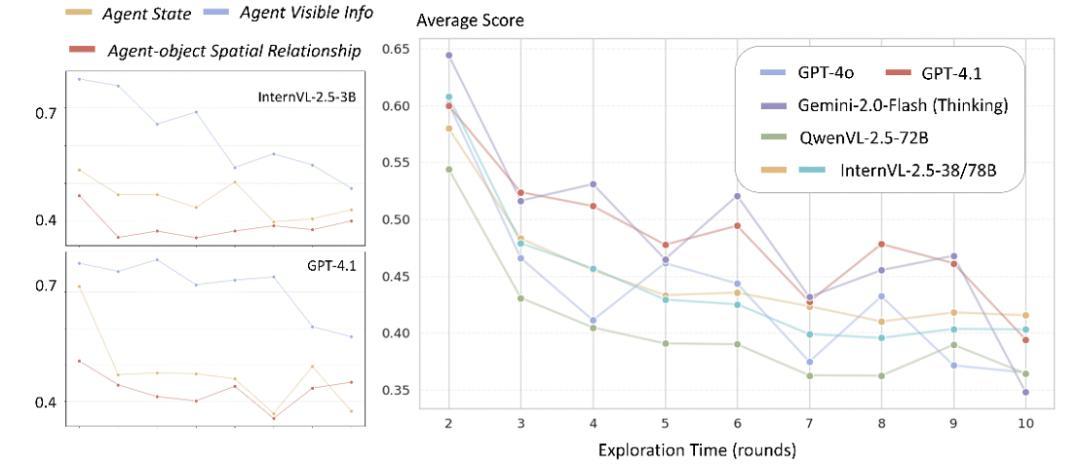
上海人工智能实验室等机构的 OST-Bench 更直接。它让模型跟着一个在房间里不断移动的视角走,边看边回答"枕头现在在我左边还是右边"“我转了多少度”。
GPT-4.1 的平均分是 53.4,人类是 83.5。探索轮数从 2 增加到 10,多数模型的曲线一路往下。走得越久,忘得越多。36氪
问题先从采样开始。30 帧每秒的一分钟视频有 1800 帧,模型通常只抽 8 到几十帧,大约一秒一张。知乎
手一挥、球一弹、杯子一倒,这些几百毫秒内完成的动作,很可能正好落在两张采样帧之间。它没看到,也就无从谈起。
抽完还要压。每一帧会被编码成几百个视觉 token,帧一多就超过上下文长度,各家都会做池化、合并、丢弃。压缩时优先保住的往往是"画面里有什么",帧与帧之间那点细微位移,最容易被当成冗余扔掉。
更隐蔽的是,模型不知道两张帧之间隔了多久。它看到的是"第 1 张、第 2 张、第 3 张",却不知道中间是 0.1 秒还是 5 秒。采样率一改,同样的画面变化代表的速度就完全不同。
很多视频模型用的还是 CLIP、SigLIP 这类图像编码器,一帧一帧单独看,编码器本身不知道上一帧是什么。时间顺序只能靠位置编码告诉它,而那只能说明谁先谁后,说不清"过了多久"。知乎知乎专栏
训练数据也在帮倒忙。大量视频字幕是"一个男人在厨房里做饭",这种句子看一帧就能写出来。真正写清"先切洋葱,再烧热锅,最后倒油"的样本很少。
研究者把这种现象叫"单帧偏差":在很多视频问答数据集上,只用一帧训练和测试,成绩和用多帧差不多。既然一帧就够,模型何必学时间。
语言先验还会替它脑补。问"先倒水还是先喝水",它不用看视频也知道先倒后喝。正常视频上总能答对,一遇到倒放或故意反着做的画面,立刻露馅。它学到的是常识里的顺序,不是这段视频里实际发生的顺序。
于是评测也容易失真。模型在静态内容上分数很高,一到时间方向、速度、先后关系就明显下滑。
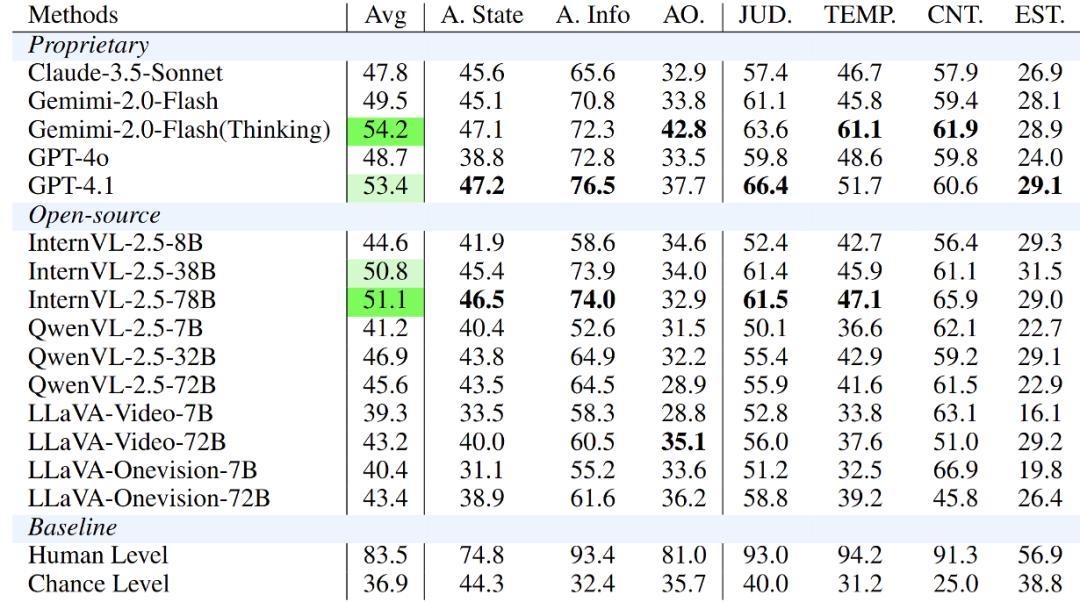
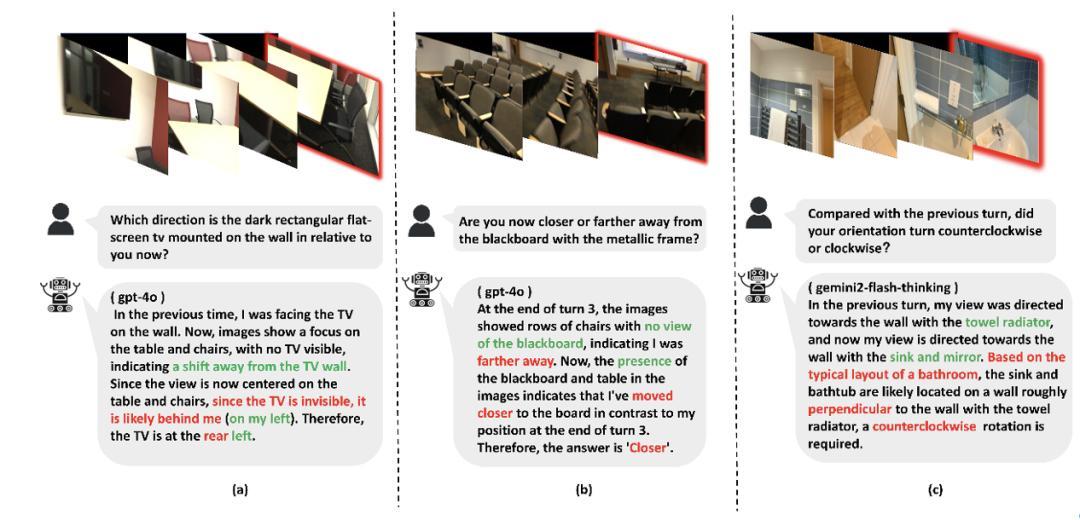
OST-Bench 的错误分析里,研究者给这种现象起了个名字:“时空推理捷径”——模型不回头找线索,只拿眼前几帧就地猜一个看起来合理的答案。36氪
现在有人开始补这块短板。MaLoW 通过超网络把历史写进 LoRA 权重,让"看过的东西"变成参数。小红书
它在 OVO-Bench 和 StreamingBench 上分别达到 74.5% 和 84.8%。小红书
另一项 ViSS+TVS 工作把"记住什么"和"看哪几帧"拆开训练。基于 Qwen3-VL-8B,它在 StreamingBench 上拿到 86.33 分,比原基线高 5.81 分。哔哩哔哩
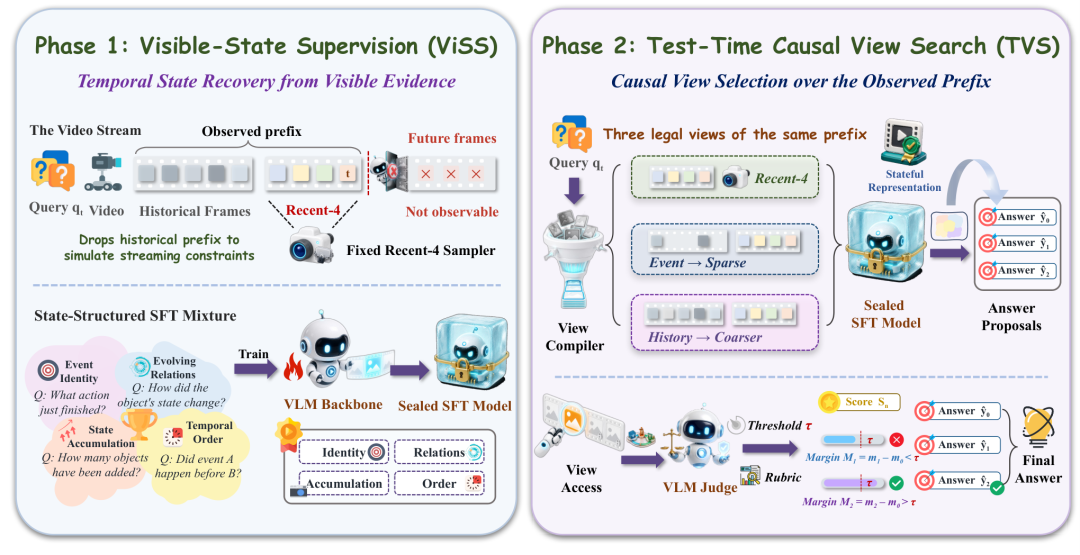
这些数字说明方向可行,但离"理解时间"还很远。对自动驾驶、机器人、体育分析和医疗视频来说,真正要紧的往往就是那几百毫秒里的先后和因果。眼下的视频大模型可以当副驾,不能当司机。
它认得出一帧里有什么,却说不清这些帧是怎么连成一件事情的。从"看照片的集合"到"看连续发生的事件",中间隔的不是一个模块,而是一整套采样、记忆、训练和评测的改法。