







96
46
Kimi半年第三次道歉,补回25%额度:模型越强,你的会员额度烧得越快
2026-11-05 03:09:15
0点赞
0收藏
0评论
一条“审查项目架构”的指令,后台拉起5个子Agent,5小时的会员额度十几分钟就见了底。
这是Kimi新模型K3.1 Pro在10月24日上线后,付费会员在社交平台晒出的投诉。10月26日凌晨,月之暗面发布致歉公告,承认会员使用K3.1 Pro时出现“限流及不必要的额度消耗”,原话是“问题出在我们,我们本应更早修复”。补偿方案是所有档位的有效订阅会员,重置月度总额25%的额度,用量不足25%的归零重算。
你要是Kimi的付费会员,或者给任何AI会员掏过钱,这事都值得看。它捅出来的不是一家公司的偶发bug,是所有“包月AI”背后那份你看不见的额度账。
道歉之后,投诉并没有停。11月2日,有用户晒帖说自己刚充了49元档,读了两次文献,月度用量就掉到12%,帖子标题是“kimi你就继续圈米,一天没到用12%”。699元顶配档的用户反馈不到2小时用完额度,终端一直弹限流报错。更让人看不懂的是,额度还有剩的会员,也会看到“Kimi正在高峰期,请稍后再试或升级会员加速”的提示,有人已经因为额度不足升级过一次套餐,升完又看到这句。
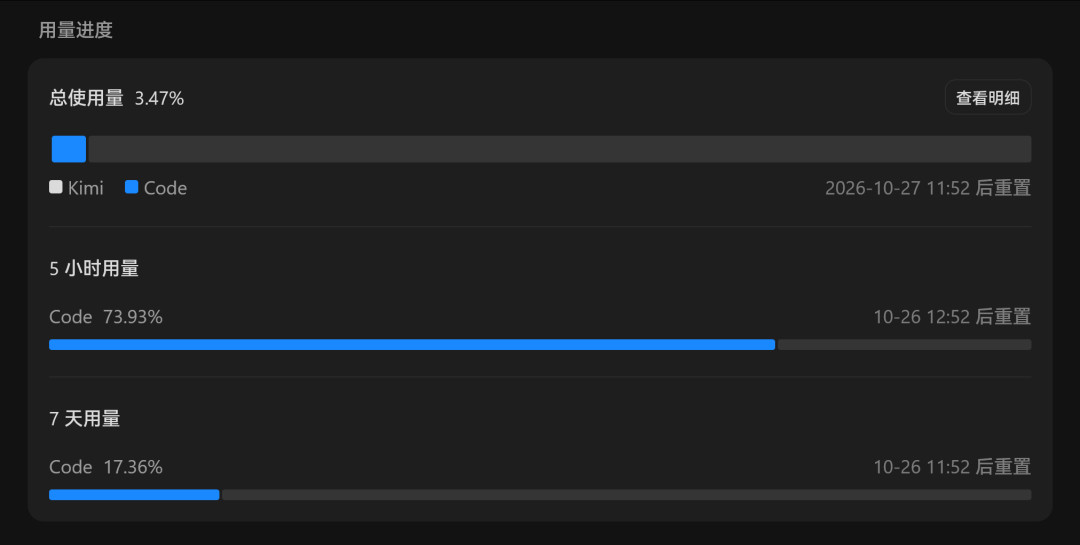
Kimi的会员额度分两本账,一本是5小时的滚动窗口,一本是月度总量。上面这些案例,十几分钟见底的是窗口账,12%是月账。哪本账,你都只能看到一个剩余百分比,看不到是谁烧的。
表面原因不难找,新模型太强、用的人太多,算力顶不住。
但把时间线翻出来,就没这么简单。今年4月22日,K2.6发布后因为限流与额度计算错误道歉。7月19日,K3上线48小时,又因为“需求逼近GPU容量极限”道歉,顺带暂停新用户订阅,有用户统计这一停就是一个多月。再加上这次10月26日,半年三次,每次都踩在新模型发布之后。
一次是事故,三次就是模式。
额度到底烧在哪?K3.1 Pro是个2.8万亿参数的模型,每次调用激活约千亿参数,还默认全程开着思考模式,每个回答都带一长串思维链和中间推导。更要命的是Agent机制,你丢给它一个问题,它在后台自己拆成多轮调用,有时还自己派出子Agent。你只看见最后一行回答,看不见中间跑了多少圈。
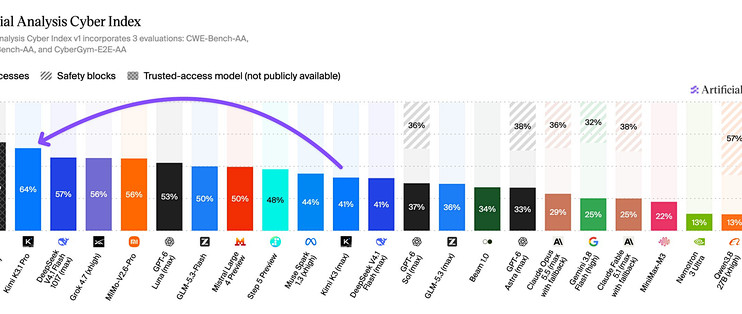
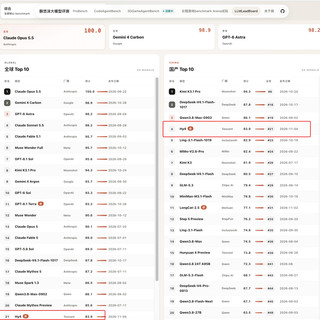
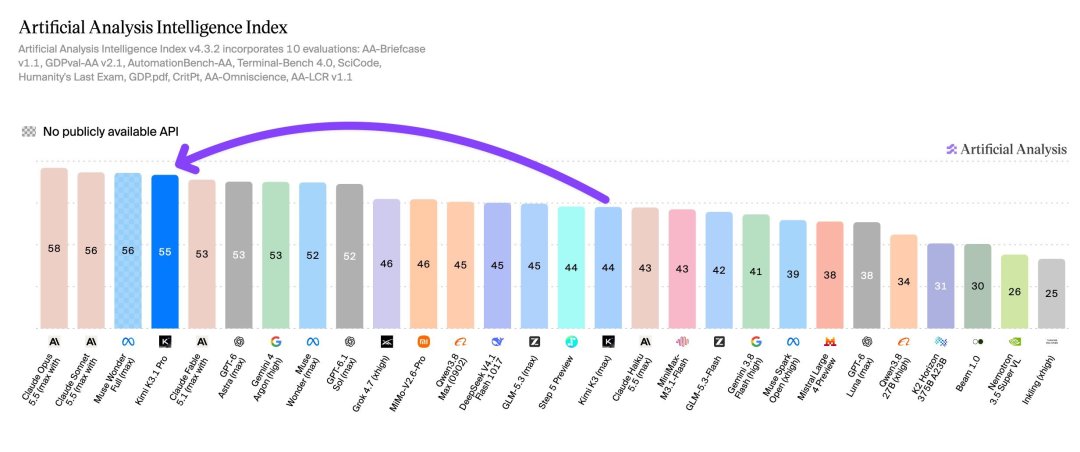
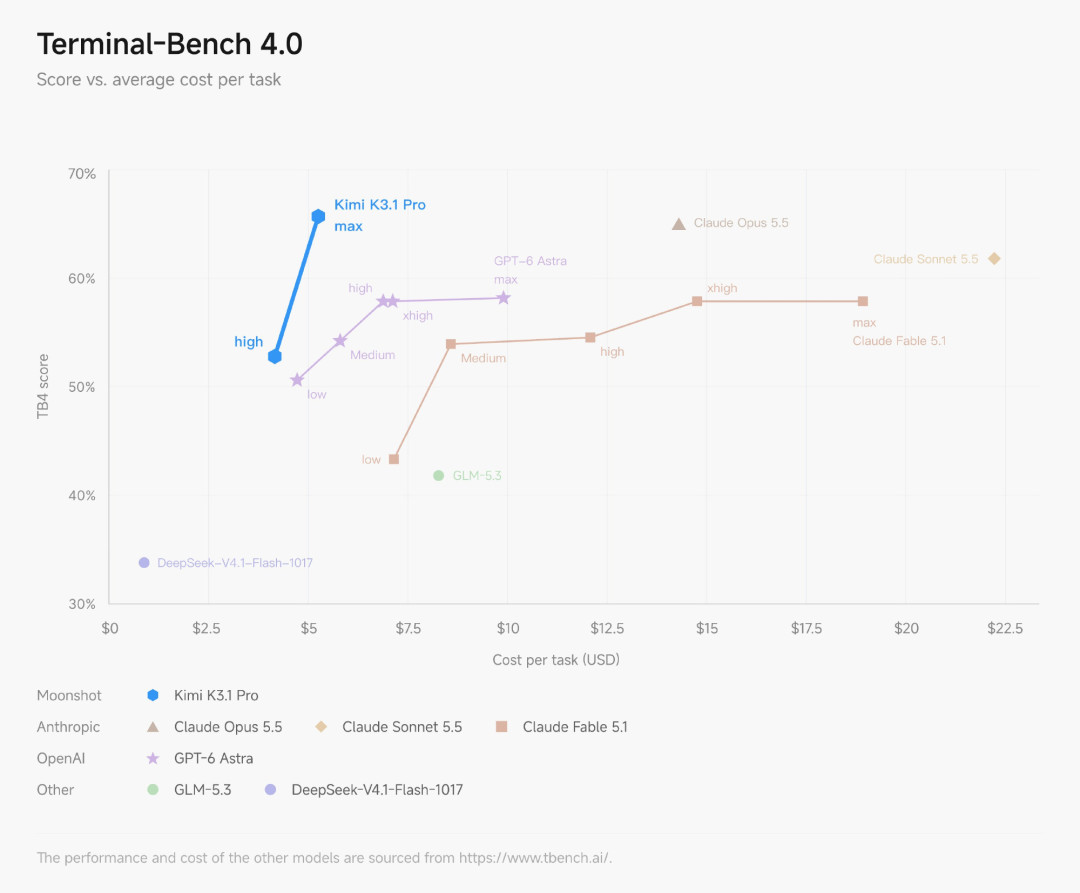
有个数字能说明问题。评测机构Artificial Analysis的Intelligence Index整套测试里,K3.1 Pro累计输出约1.5亿Token,比参测模型的中位数高出72%。能力是真强,同一机构把它排到全球第四,是榜上得分最高的开源权重模型,Terminal-Bench 4.0也刷新了历史最高分。但它每干一次活,吃掉的量也比同行大。
致歉公告其实把这层也承认了。公告里说“正在减少不必要的子Agent调用和输出长度”,翻译过来就是,之前确实有不必要的调用,而这些调用,照样从你的额度里扣。
有位用户的吐槽说到点子上。他说他最烦的不是AI贵,是月费明码标价,扣费却是一坨黑箱百分比;还有人拿一句“你好”去测,后台已经烧掉几万Token。他要的不复杂,额度不全是你用掉的,有一部分是AI自己派出去的小工偷偷烧的,那他就想看到主任务、子Agent、缓存重试各烧了多少的明细。
最拧巴的地方在这。K3.1 Pro的API价格其实比上一代降了三分之一,输入从每百万Token 20元降到13元,输出从100元降到68元。单价降了,单任务消耗涨得更多,两头一抵,会员的性价比就被悄悄抹平了。
替月之暗面说句公道话,这不是一个恶意圈钱的故事。模型确实冲到了全球第四,价格确实降了,算力确实紧张,按彭博社的报道,它的算力很大一部分依赖与阿里巴巴协议下约2万枚英伟达芯片的集群,K3那次暂停订阅,也是需求真顶到了GPU容量上限。道歉态度也不敷衍,“问题出在我们”这句话,没几家公司说得出口。
但难处承认了,不等于难处就能抵账。订阅制有个天生的矛盾,月费是刚性的,模型一代比一代强,推理开销不降反涨,用户的预期是“付了钱就该够用”。这个矛盾短期无解,也就意味着下次K4、K5发布,额度大概率还会紧张。道歉解决的是这一次的愤怒,解决不了下一次限流。
老舅我劝你一句,算力贵是公司的难处,额度黑箱是用户的难处,两个难处不该互相抵账。你收明码的月费,就该给明细的扣费。会员要的不多,就是知道自己这一单烧了多少,烧给了谁。
那现在该怎么办?你要是Kimi会员,先去会员中心看一眼这个月的用量,补偿的25%额度重置到没到账。
用的时候记住一条:别把开放式大活儿随手丢给顶配模型。“审查架构”“分析项目”这种指令最容易拉起一串子Agent;把范围收窄、把要求说死,额度烧得会慢很多。
想升级更高档位的,先别上头。看看你这个月用掉了百分之几,再算这笔账。顶配套餐2小时用完的例子摆在那,升级不等于敞开用,只等于高峰期烧得更快。
双11正打算囤AI会员的,这一步也别省。AI会员跟囤纸巾不一样,少囤、按月买,这个月用完了再想下个月的事。
那个读两次文献用掉12%的用户,用量其实不重。重的是每次提问背后,模型自己的工作方式,和你看不见的那根用量条。
内容由AI生成