

话还没开始,窗口已瘦一成。
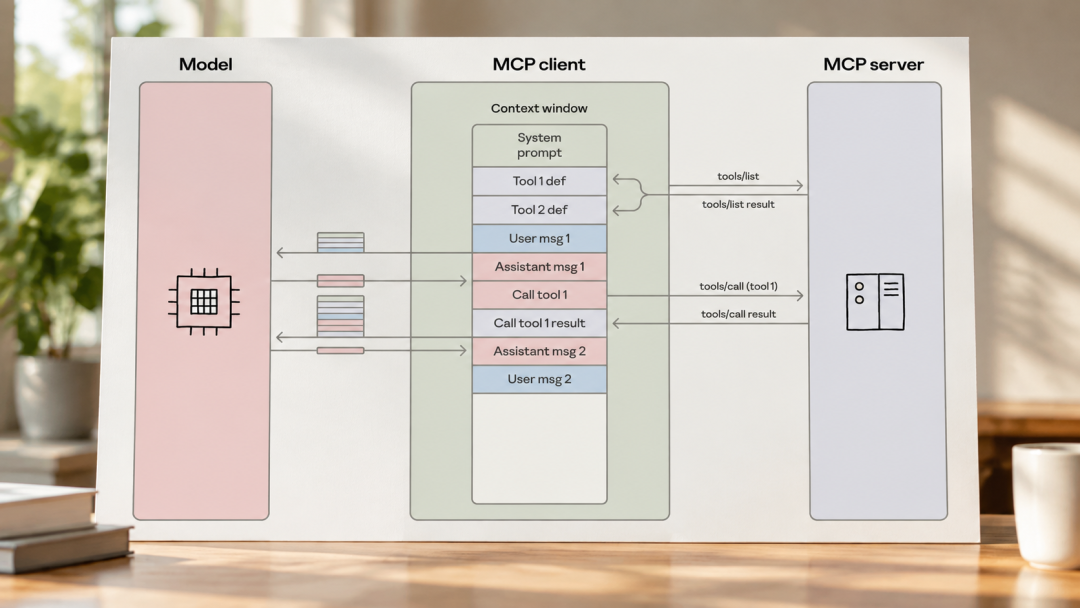
这不是贩卖焦虑,是不少做 Agent 的人都算漏的一笔账:你挂载的每个 MCP server,它的工具会"摊在桌上"给模型看——server 动辄暴露十几二十个工具,每个带着名字、描述和完整的 JSON schema,几个 server 叠起来,几千甚至上万 token 的固定开销,而且它不管你这轮用不用,都常驻在 prompt 头部。知乎知乎
最扎眼的两组实测数字
Playwright MCP:21 个工具吃掉 13.7k token,约占 Claude 上下文的 6.8%;Chrome DevTools MCP:26 个工具吃掉 18k token,约占 9%。同样的能力换成 CLI + 一份 README,只要 225 token。知乎
另一位开发者在 256K 上下文窗口里挂载 REA(约 130 个工具)加 OpenPencil(约 150 个),近 280 个工具说明,还没干活,窗口先撑爆了。知乎
真正疼的不是 token,是缓存
工具说明放在前缀里,命中缓存时这部分成本大约只有原价的十分之一,看起来可以接受。但缓存有 TTL——它奖励"一鼓作气"的工作方式,惩罚真实的人类节奏:上午开了头,被拉去开会,下午回来接着干,缓存一过期,几千 token 的说明就要按全价重新付一遍。知乎
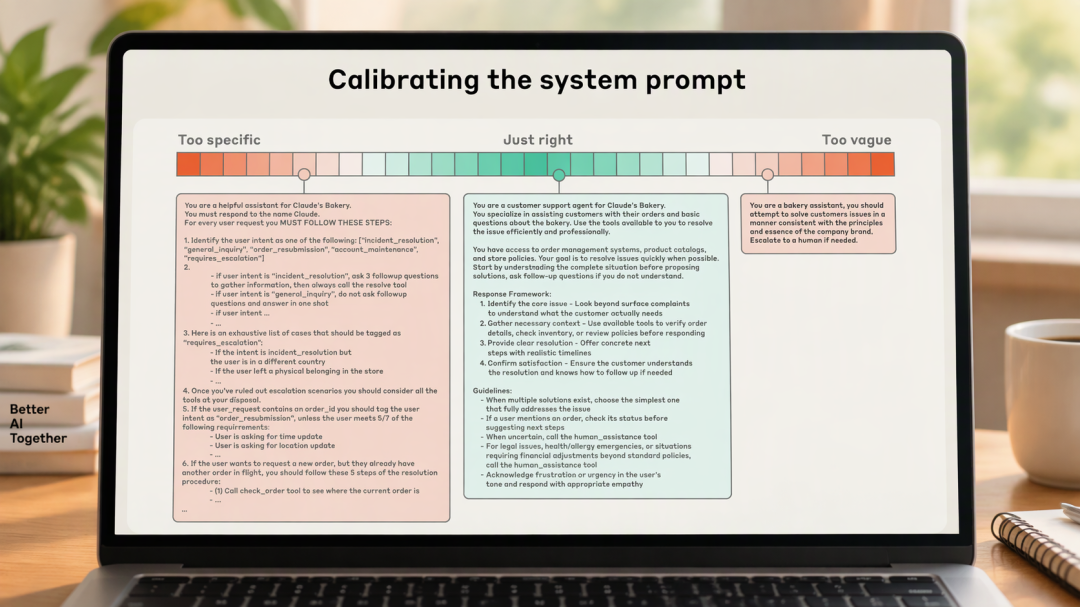
更扎心的是另一笔账:假设 5 个 server 合计 8000 token 的说明,里面可能有 7000 对应这个会话压根碰不到的工具。为闲置能力付费,才是大家愤怒的真正来源。知乎
年末复盘:两条相反的新闻,砍的是同一刀
年末复盘里有两个时间点对称得扎眼:3 月,Perplexity 的 CTO 公开说内部已弃用 MCP,退回 REST API 加 CLI;9 月 29 日,首页挂了快一年"No MCP"的编程 agent Pi,把这句话划掉,换成了"Now with MCP+Codemode"。看似相反,动作其实一样:把工具声明从请求前缀里拿掉,模型需要时才给它看。与其说是协议之争,不如说会死的不是 MCP 本身,是”无脑全量挂载”的用法。知乎知乎
三个今天就能动手的瘦身动作
数一数你的工具,3~8 个是交叉点。 有人把挂载工具数做成可调的空白 server 实测对比两种计费形状:3~8 个工具以内,全量注册更省;超过这个区间,切到按需加载模式,付一笔固定租金反而更便宜。知乎
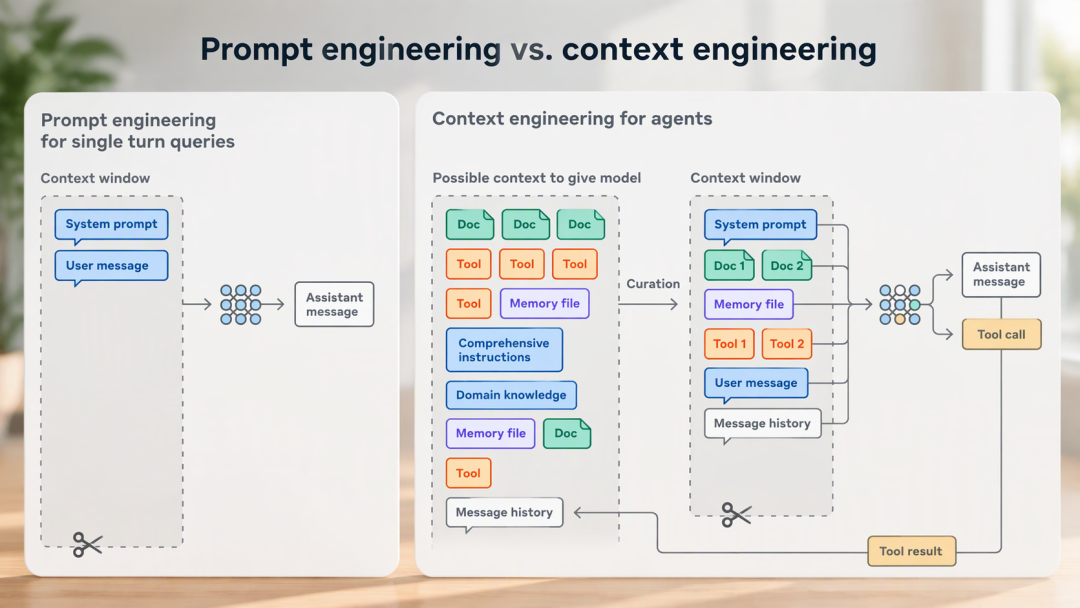
优先用延迟加载。 Claude Code 已支持 MCP Tool Search(先搜工具目录,需要时再加载完整 schema),OpenAI 侧有 defer_loading 机制——工具定义先注册成可搜索的资源,模型找到相关工具后再加载完整定义。还有社区插件把 1000 个工具藏在 2 个入口后面(作者特定测试环境的数据,别直接换算成你的 token 节省率)。知乎
分清权限白名单和 schema 过滤。 白名单管的是"能不能调",工具定义照样常驻上下文;真正把 token 省下的是把定义从上下文里拿掉,这俩经常被当成一回事。知乎
最后提醒一句:别急着投奔 Skills 就万事大吉——渐进式披露只是把 token 的支付时间推迟了,没有消灭;摘要再短也是钱,五十个 skill 的摘要加起来同样可观。文档松散导致模型调错、重试、自我修正的隐性开销,积少成多未必比 MCP 省。知乎
有个比喻很贴切:上下文等于钱包,你得盯着它,才知道钱花哪了。年末给 Agent 做性能优化,第一刀往往不是换模型,而是先把工具列表瘦下来。哔哩哔哩

当前文章无评论,是时候发表评论了