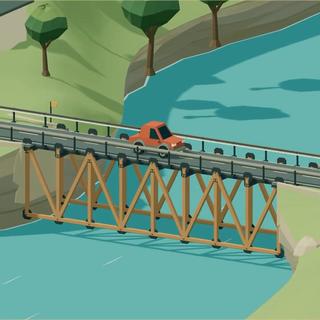
30 米宽的大峡谷,GPT-6.2 Sol 交出的桥造价 7702 元,是九款模型里最好的。比赛页面的玩家榜上,一个叫 LittleSurvival 的玩家同样把车送过了峡谷,造价 3022 元。
公开的设计文件里,这份“桥”只有 2 个节点、4 根杆件:两段短路面,两根液压杆。按比赛价,光铺 30 米路面就要 4500 元;3022 元连一条完整的路面都买不起。车开上左岸的短坡,液压杆一抬,把车弹过峡谷,落在右岸的短坡上。它不是桥,是一台弹射器。
这是 B 站 up 主“喵了个猫了个咪了个猫”办的 AI 算法对抗大赛第 9 集。 九款模型——GPT-6.2 Sol、Claude Opus 5.5、DeepSeek V4.1 Flash 等——拿到同一套材料。 它们在 90 分钟里设计七关的桥。哔哩哔哩AI 算法对抗大赛GitHub
第 1 到 6 关,车按时完好到对岸就算过,过关后比造价,关卡分 = 100 × 参考答案造价 ÷ 你的造价。造桥大赛官网
官方成绩里,Sol 六关全过,总分 102.67,排第一;Opus 5.5 第二,79.02。前三关九款模型全过;到了过船、钱不够、地狱关,分别只有 3、1、3 款模型过关。
但比赛页面还挂着一个玩家榜。任何人可以上传自己造的桥,按造价从低到高排,只显示每个人最便宜的一次。 到 11 月 9 日晚,六个关卡的榜首造价全部低于九款模型的最好成绩。第 1 关便宜 34%,第 6 关便宜 17%,中间四关便宜 41% 到 64%。AI 算法对抗大赛
榜上的“普通人”是谁?有人一关提交二三十次;昵称“古法搜索(Cr)”在第 6 关提交了 30 次,“小白头疼药”在第 1 关提交了 24 次。前几名的造价咬得很紧,差几毛到几十块。他们未必是桥梁工程师,但也不全是徒手画图——更像是普通玩家加一个不知疲倦的试错循环。
原因很朴素:这是“最小值”和“一份”的比较。六个关卡,玩家榜一共收了 617 次提交;九款模型每关只交一份,一共 54 份。六百多次里挑最低,和五十四份里挑最低,本来就不一样。模型也能在本地无限次跑模拟器,但 90 分钟要分给七关,最后只交一份;玩家可以把更多时间砸在一关上,交几十次,榜单只留最低的一次。
真正有意思的是,造价最低的那几关,赢家把“桥”删了。第 2、3、4、5 关的榜首设计分别只有 2、4、4、3 个节点,核心是液压杆和短坡道,把车弹过去。规则写得很清楚:普通的桥、拱、悬索、开合桥都行,把车弹射过去、搭跳台让车飞过去也算合法。 九款模型交上来的,几乎都是正经的桁架、悬索、开合桥。它们在回答“怎么造一座更便宜的桥”;榜首在回答“为什么一定要造桥”。造桥大赛规则
这也解释了差距的形状:四关靠弹射的,榜首比 AI 便宜 41% 到 64%;两关必须造真桥的,只便宜 17% 到 34%。第 6 关有船、有双向车流、有卡车,弹不过去,只能老老实实搭木桁架——这一关榜首 14360 元,Sol 17213 元,只便宜 17%。
所以,“普通人造价更低”这句话,得拆开看。它不证明业余爱好者比九款前沿模型更懂桥梁工程;它证明的是,当目标被写成一个可反复试错的数字,赢家往往不是最会“造桥”的那个,而是最会“重新定义问题”、并且愿意在一个点上磨几十遍的那个。
对 AI 来说,这恰恰是一个不舒服的提醒:生成一个合格方案,它已经不比参考答案差——Sol 在第 2、3、4 关的得分都超过了 100 分(参考答案记 100 分),Opus 在第 1 关只差 0.6 分。它缺的不是结构知识,而是两件事:一是把“造桥”还原成“让车过去”的胆量;二是在一个目标上持续搜索、承受大量失败样本的耐心。
当然,真实桥梁工程的“造价”不是一条可以弹射过去的沟。它还有规范、疲劳、维护、通航、抗震、审批。第 6 关那种必须造真桥的场景,才是更接近现实的压力测试;在那里,人类榜首只领先 17%,而不是第 4 关的 64%。
把这场比赛当成“普通人打败 AI”的证据,会看漏真正有价值的部分:AI 已经是一个很好的方案生成器,缺的是一个更快的试错回路和一个更会定义目标的人。人把目标定对,AI 把候选做多,这可能比争论谁更聪明有用得多。
九个模型都在回答“怎么造桥”。榜首在回答“为什么一定要造桥”。