双11想装台机器在家跑大模型,多数人的第一反应是:买张显存大的卡。可最近一个多月的实测,把这套逻辑打穿了一半。
12G显存,跑通了125B
10月初,B站UP主「AI观模者」用开源推理引擎 Strata,在一张12G显存的卡上跑通了125B参数的 Qwen3.8-Flash-Next,速度93 token/s。这条视频现在有27万播放、2.2万收藏,评论区吵了两千多条。哔哩哔哩哔哩哔哩
它不是玄学。MoE模型把参数拆成海量「专家」,每个token只叫醒其中一小撮;显存放不下的专家就先住在内存里,缺哪个搬哪个,计算始终留在GPU上,16GB级别的消费卡因此也能跑MoE大模型。哔哩哔哩
Strata 的做法是把硬件拆成三级:NVMe固态映射查找表,系统内存常驻24576个专家的池子,显存只留注意力层和高频热点专家。但这只对稀疏MoE成立,换成27B这类稠密模型,没有专家池可拆,还是得老实按显存算。哔哩哔哩
能跑,不等于能用
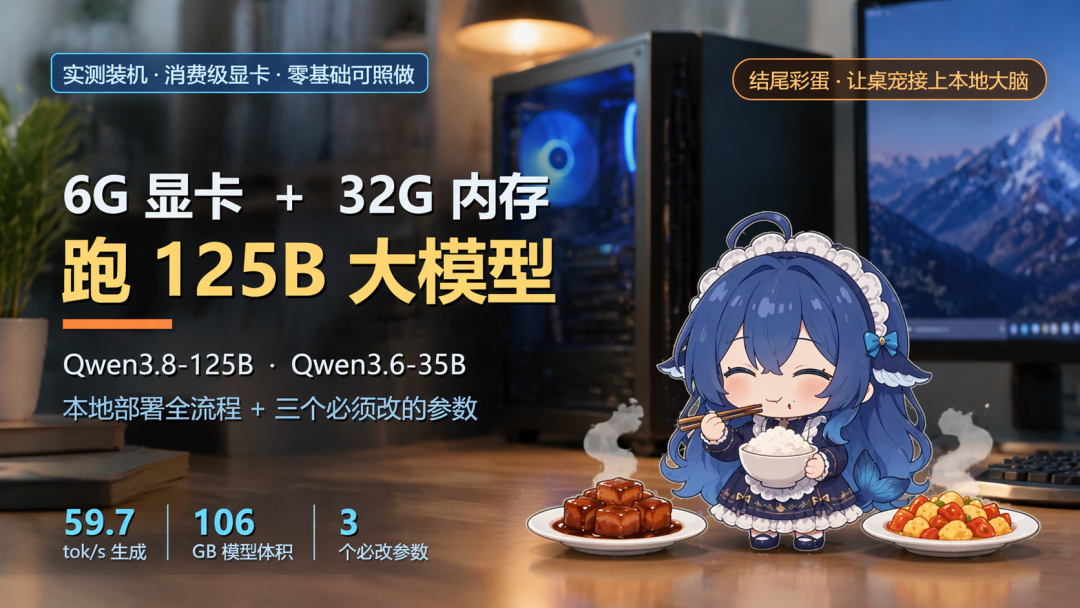
另一位UP主「月下雪之奶」交了份更扎心的实测:一台RTX 2060 6G + 32G DDR4 + i5-12400F的老机器,同样用Strata跑125B的Q2_0量化版。35B模型59.7 token/s,挺舒服;125B短提示20.7 token/s,但1K提示首字要等57秒,16K等104秒,之后掉到7 token/s左右,64K上下文直接起不来。哔哩哔哩
他的警告值得抄下来:别把125B接进Agent——一条24,951 token的请求里,81个工具定义占了94%,按这个速度预填要18分钟,客户端等不到就重试,永远出不来。哔哩哔哩
下单前先算两笔账
装得下吗?粗算公式是显存 ≈ 参数量 × 位数 ÷ 8,再给KV Cache和运行开销留几G;按4位量化,8G约够80亿参数,12G到140亿上下,16G两百多亿,24G刚好320亿,70B的4位版要40G上下,单张消费级显卡放不下。哔哩哔哩
跑得快吗?速度上限 ≈ 显存带宽 ÷ 模型大小;同一个4位8B模型(约5G),RTX 4060(272 GB/s)上限五十多个token/s,4090(约1 TB/s)两百个左右。带宽才是天花板,不是容量。哔哩哔哩
行情这头也不轻松。华强北的RTX 50系列连涨11个交易日后,从10月28日起掉头向下,5080最低价回落到1.6万元,较10月下旬约2万元的峰值回调约两成。新快报
但别高兴太早:均价仍停在建议零售价的1.7倍,之前较大的价格涨幅仍未消化。新快报
更反常的是老卡:海外市场传出RTX3060 12GB报价来到610美元,折合人民币四千余元,反观性能更强的3060 Ti售价仅约它的一半——该消息源自海外社交平台媒体转述,并非英伟达官方信息。显存本身,已经在被单独定价。微博
钱该怎么分
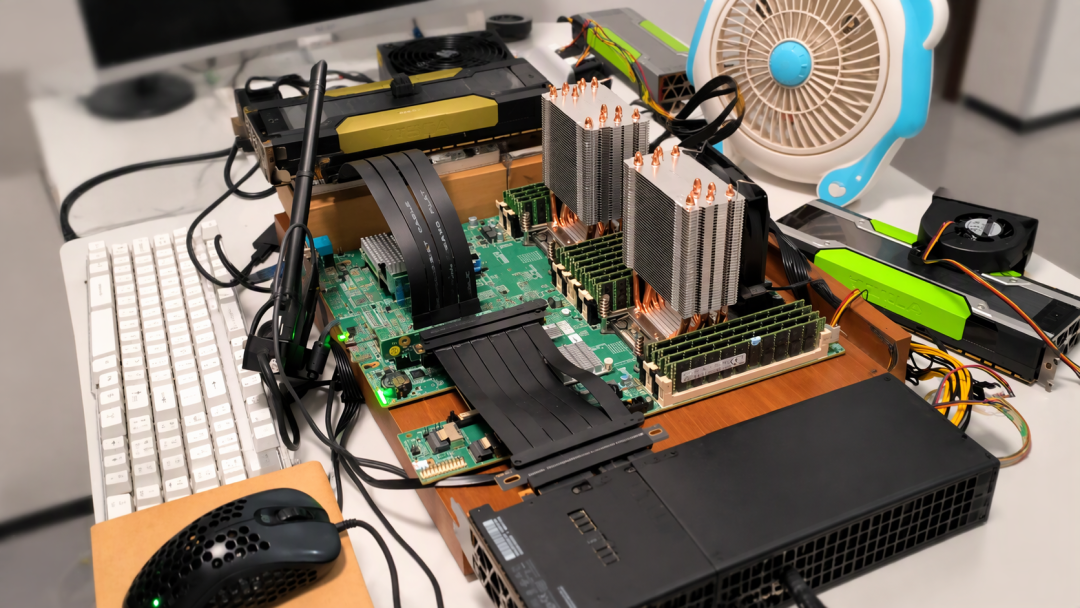
如果你要跑的是MoE大模型,优先级是系统内存(48–64G)> 显存容量 > 显卡型号。极端例子是B站那台「洋垃圾」:一台老旧的DDR3服务器,硬是把几百GB的DeepSeek跑到了双显卡33.5 token/s。它靠的不是显卡,是二手服务器堆出来的512G内存。哔哩哔哩
「每GB显存多少钱」也成了新比法。海外渠道的Intel Arc Pro B70是32GB GDDR6、608 GB/s带宽,11月初官方店1299美元;同样32GB显存的NVIDIA RTX 5090现在要6550美元起,每GB价差五倍。哔哩哔哩
代价也直白:长上下文仍是弱项,215k提示词首字在SYCL下要8.6分钟,llama.cpp到11月初还在修这张卡的bug。哔哩哔哩
还有个很具体的取舍:RTX 5070只有12GB显存,比5060 Ti 16GB少4GB,为了跑大模型,12GB打不过16GB。反过来,如果你要跑的是稠密模型、或者天天用长上下文,显存和带宽就回到第一位,别省。哔哩哔哩
最后别忘了内存也在涨。48–64G这笔支出现在并不轻松,下单前把内存和显卡放一起算总价。
装机之前,先关掉一扇门
装完Ollama,别把监听地址从127.0.0.1改成0.0.0.0。它的本地接口本来就没有身份验证,没有账号、没有密钥、没有白名单,改了等于对局域网甚至公网开门,别人能直接用你的显卡,还能列出、删掉你的模型。自查只要一行:`ss -tlnp | grep 11434`。哔哩哔哩