

















35
16
上千智能体用八天造出系统原型
2026-11-10 07:40:39
0点赞
0收藏
0评论
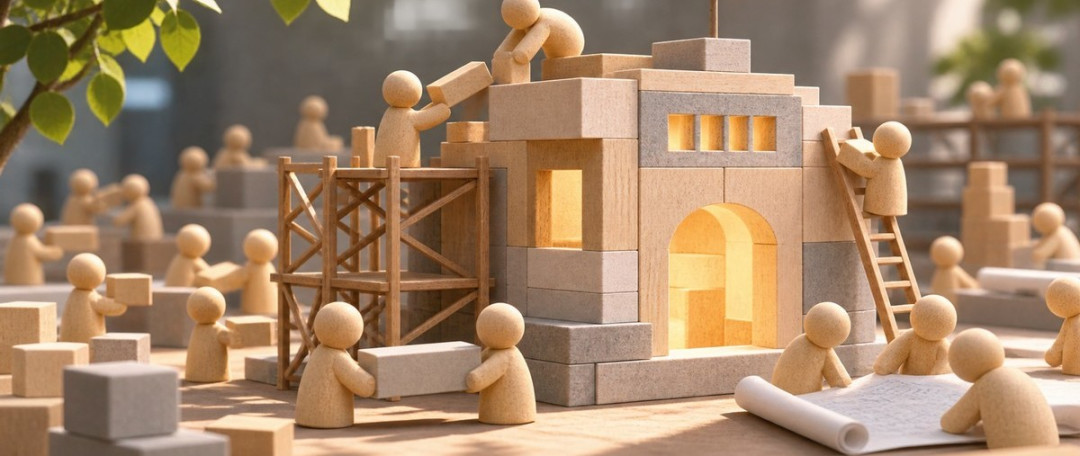
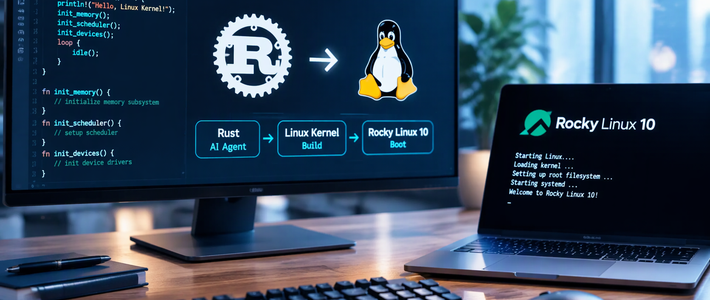
从一个空文件夹开始,连续工作 8 天,最终交付一套能够在笔记本电脑上启动的操作系统原型。这是 Anthropic 发布 Fable 5.2 时展示的工程案例。比起一次回答是否正确,这类任务提出了更长的考验:模型能否组织工作,并把编写、测试和审查持续推进到可运行的结果。
爱范儿转述的官方案例中,Fable 5.2 自主协调了超过 1000 个子 Agent,完成上述操作系统的开发。按照官方展示,它拥有自己的内核,支持磁盘、键盘和网络驱动,也具备文件存储、窗口界面、登录屏幕和安装程序。这些功能共同构成了一个可以启动、可以操作的交付物,而非单独展示的代码片段。
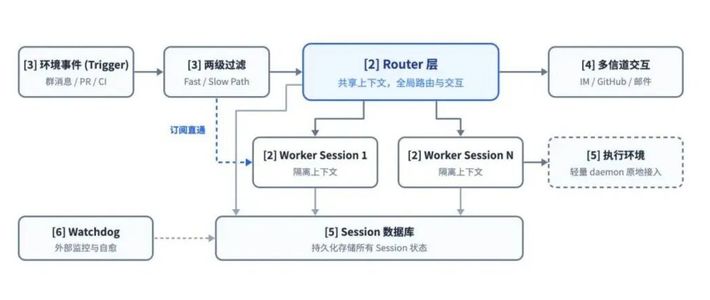
这使模型评价有了值得展开的新维度。编程测试可以比较特定条件下的得分,长周期项目则让人看到,多个部分能否在持续执行后组合成一个系统。任务如何分配,子任务之间如何协作,代码是否经过测试和审查,都开始影响我们对能力的判断。官方案例已经展示了协作规模、执行时长和最终结果,但尚不能据此认定,每一个中间环节都足够可靠。
尤其需要保留“原型”这个限定。能够在笔记本电脑上运行,说明这项实验达到了展示中的目标;它不等于已经具备成熟操作系统的全部要求。仅凭此次展示,也无法判断模型面对其他复杂项目时,是否都能同样完成交付。这里值得关注的是一次长周期工程执行的结果,而不是对所有软件开发任务的能力承诺。
另一项实验把观察重点从“做出了什么”推进到了“怎样完成”。爱范儿介绍,1000 个 Fable 5.2 Agent 用 30 小时完成了费马大定理的形式化证明,几乎不需要人工干预。模型在实验中自行建立协作机制,生成的证明长度缩短至此前的七分之一,消耗的操作 Token 降至原来的三分之一。
这里的形式化证明,是把已有的数学证明转换为计算机能够逐步验证的表达,并非重新发现费马大定理的证明。此前,Anthropic 使用尚未发布的研究模型,在人类研究人员指导下耗费 11 天完成相关工作。两次工作的用时和人工参与情况值得比较,但现有材料不足以把差异全部归结为某一项技术改进。
证明长度与 Token 消耗的变化还提醒我们,评价多 Agent 协作不能只数参与者有多少。如果只关注并行规模,就会忽略完成同一目标需要多少操作、产物有多长,以及人类需要介入到什么程度。这些指标各自反映不同侧面,不能相互替代,也不宜合并成一个笼统的“效率提升”结论。
本文的判断是,Fable 5.2 此次发布值得从工程执行层面观察:在单项跑分之外,应进一步考察系统如何拆解任务、组织协作、开展测试和审查,并最终交付可核验的成果。操作系统案例仍是实验原型,相关科研成果也仍需进一步验证。接下来评价这类能力,既要看最终是否完成,也要看完成过程留下了多少可检查的记录,以及成功能否在更多任务中重现。