

晚间名场面:你起了个本地模型,接上编码Agent,丢过去一个小任务。十分钟后,产出还在一个字一个字往外爬,任务管理器内存红到95%,你的手已经点开了显卡购买页。
先别下单。本地推理又慢又吃内存,病根往往不在算力——而在两笔你没翻过的隐形账。
第一本账:你等的那些token,一大半在"重读作业"
Agent和聊天不一样:它每轮都把整段历史、系统提示、工具列表塞给模型重读一遍(prefill),才生成新内容。有人拿8张3090本地跑FP8的Qwen Flash Next实测:18分钟烧掉1290万token。大头是prefill:每轮重读整段对话,处理量随轮数平方涨,真正新生成的只是零头。哔哩哔哩
病根在重读,药就不是买卡,而是让读过的一遍不用再读:
保持系统提示和历史顺序稳定,别每轮改动前缀,否则缓存全废;
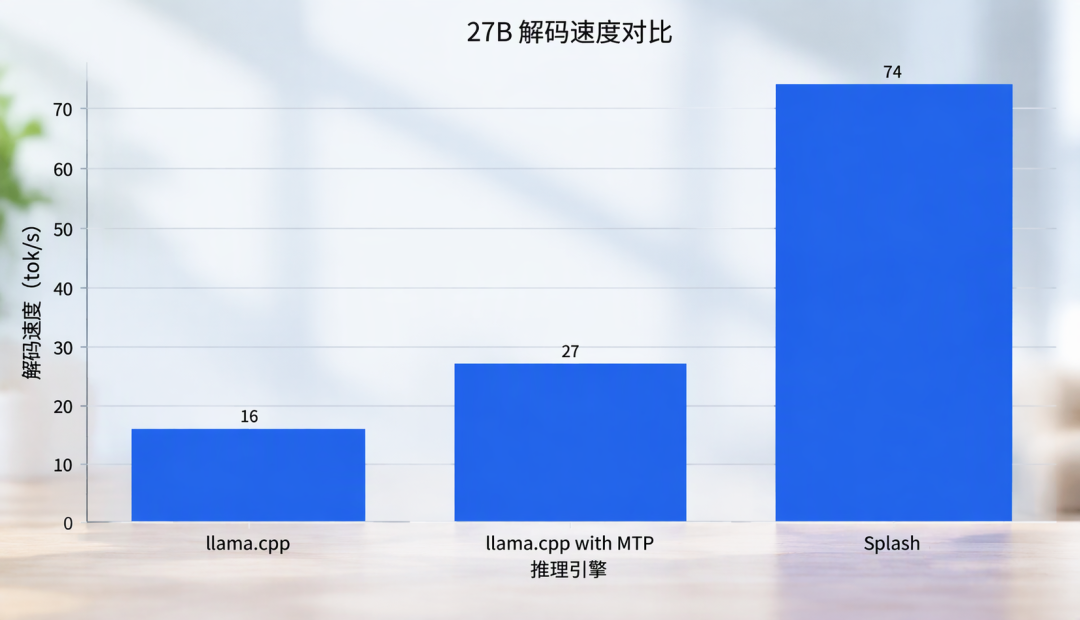
用支持前缀缓存和投机解码的引擎。Apple生态的新引擎Splash项目实测:同一份27B GGUF在M5 Pro上,llama.cpp跑约16 tok/s,开MTP到27,Splash到了74。注意这是特定模型、特定量化、特定测试条件下的官方数据,不代表任意模型在任意Mac上都自动变快。知乎
速度账的另一半在"搬家":显存不够,就把权重塞进内存甚至固态硬盘让它们逐字参与生成。有B站UP主下了个狠判决:同一模型独显跑163 tok/s、CPU只有24,七倍差距被Agent的几十次调用一放大,就是几分钟和几十分钟的区别。这判决核了14篇论文、451个开源仓库过堂,测量面前人人平等。哔哩哔哩
所以他的纪律很粗暴:显存装得下就全装载,装不下就换小模型。别让内存和硬盘替你逐字吐词。也别混淆:Splash的SSD缓存存的是"已算好的状态",为的是下轮跳过重读,和让硬盘逐字流送权重是两回事。哔哩哔哩
第二本账:内存爆掉,多数不是模型的锅,是班子的锅
知乎问题"本地跑大模型做Agent,内存占用为什么会比模型文件大十倍?“本周刚冒头。一个实测回答把它切得很干净:模型文件8G,运行起来就会翻到10~16G,引擎占用、KV上下文占用、激活值都是正常开销。但再翻到十倍,那就是"agent自己惹的祸”:它自己写的钩子脚本、沙箱、MCP工具调用,只管分配内存不管释放,几个循环就能堆出几十G。知乎
同一位答主还讲了自己撞上的事故:直接一个bash把用户文件夹整个删了,连带Agent自己。个案不能外推,但提醒很实在:别让本地模型裸奔着碰主力盘。知乎
评论区补的刀也实在:上下文和并发一涨,KV缓存这类临时占用能远超权重本身。对策就三招:
给引擎显式设上下文和内存上限(类似–max-context、–max-memory),留安全余量,别顶格塞;
长会话定期摘要压缩历史,别让它越滚越厚;
调Blender这类吃GPU的工具时强制显卡渲染,别让CPU边干活边烧内存。
一句话收尾
下单新显卡之前,先把这三个开关看一遍:前缀缓存在没被复用、上下文有没有上限、内存和SSD有没有偷偷参与逐字生成。本地推理,算力是下限,工程才是上限。
当前文章无评论,是时候发表评论了