2025年,多智能体系统研究在顶会上呈“通胀”之势,成为具身智能的核心战力区。本文深度剖析了其背后两条主导技术路线——基于学习的分布式涌现与基于大模型的集中式规划,揭示了二者在协同效率与全局理解上的优势与瓶颈,并指出了当前研究面临的共同本质困境。
 智能速览
2025年顶会中,多智能体研究呈“通胀”趋势,占比超60%。
基于学习的方法追求分布式涌现,擅长大规模实时协作。
基于大模型的方法侧重集中式规划,在任务理解与拆解上占优。
两条路线虽互补,但都暴露了在可扩展性与实时性上的瓶颈。
核心困境在于用“单体智能”思维应对“群体智能”挑战。
 精华内容
深入探究2025年的多智能体研究,会发现其技术路径正清晰地分为两大阵营:自下而上的分布式涌现与自上而下的集中式规划,二者在协同智能的构建上展开了激烈竞逐。
分布式涌现路径
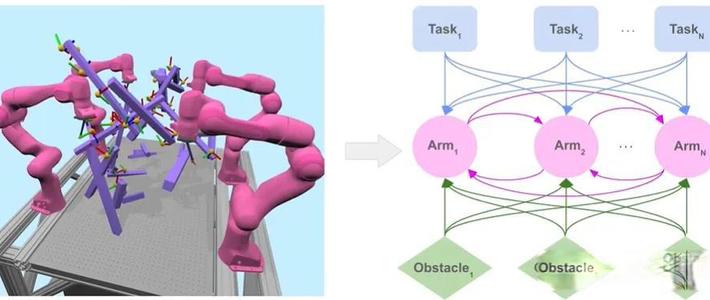
基于学习的方法,其核心是分布式涌现,通过算法让智能体在局部互动中自然浮现协同行为。该路径将多机器人协作建模为图结构,能够同时协调8个机械臂(56自由度)处理40个任务,且每步规划仅需0.3毫秒,实现了零碰撞协作。
通过模仿W-MAPF-LNS算法并采用自举迭代训练,该方法首次实现了10,000个机器人的协同路径规划,每步耗时小于1秒,解决了超大规模部署的难题。其优势在于具备零样本泛化能力,无需额外训练即可适应新环境,大幅提升了工业自动化的效率。
然而,这种自下而上的方法也存在明显瓶颈,如可扩展性受限、通信成本高昂、长期任务协调困难,且严重依赖仿真环境与密集训练。
集中式规划路径
与分布式涌现相对,基于多模态大模型的方法追求集中式规划,其内核是自上而下地生成全局最优方案。这类方法依靠大模型对任务、场景与交互的深度理解,直接生成统筹方案。
以SMART-LLM框架为例,它首先利用LLM将自然语言指令(如“整理房间”)转化为高层任务描述,再由PDDL算法生成满足约束的子任务分配与执行序列,解决了长时任务的子任务依赖与并行调度难题。
该方法在模拟辅助机器人与行动受限人类的协作场景中表现出色,能够从第一视角视觉中推断人类意图,展现出了独特的语义理解与全局规划优势。但其瓶颈在于响应延迟、实时控制能力弱,以及对预定义符号体系的依赖。
路径瓶颈与互补
审视两条技术路线,基于学习的方法在实时性和大规模部署上优势明显,但在高层任务理解和人机交互上存在短板。而基于大模型的方法恰好弥补了这一点,它在任务拆解、人机协作和场景泛化上表现出色,却难以胜任高频率的实时控制。
因此,当前的研究趋势正走向“大模型规划 + 强化学习执行”的混合范式,试图结合两者的优点。这种结合虽然在一定程度上缓解了各自的瓶颈,但并未触及问题的核心,本质上仍是在预设架构下进行效率竞赛。
思维转向的本质困境
两条技术路线的并行演进,暴露了一个更深层次的困境:我们可能正用解决“单体智能”的思维惯性,来应对“群体智能”的挑战。当前研究精于在预设架构中“优化”群体,却尚未学会在开放环境中“定义”那个能作为整体行动的智能体。
这指向一个根本性的转向:从“智能体的群体”到“群体的智能体”。前者是工程组合思维,将多个智能体简单地组合在一起;而后者是系统涌现思维,将整个群体视为一个统一的、能够自主决策的智能体。不实现这种思维转变,多智能体系统的天花板将难以被真正打破。
多智能体研究的两条技术路径,无论是自下而上的涌现,还是自上而下的规划,都在推动着群体智能的边界。然而,繁荣背后是共同的思维局限。超越单体的优化思维,去探索一个能涌现整体智能的“群体的智能体”,或许是决定下一代人工智能高度的关键所在。我们该如何定义那个能作为整体行动的智能体呢?