这周数学界跟AI干了一架,剧情比程序员圈的任何瓜都刺激。
起因是9月OpenAI高调宣布模型“攻克”了纳维-斯托克斯方程,25位菲尔兹奖得主气得联名发公开信。10月6日,OpenAI更进了一步,一次性甩出722篇AI生成的数学预印本——次日就因符号错误撤回3篇,最后剩719篇。“人类数学协会”直接开骂:这是“权力展示”,不是学术研究。钛媒体字母AI
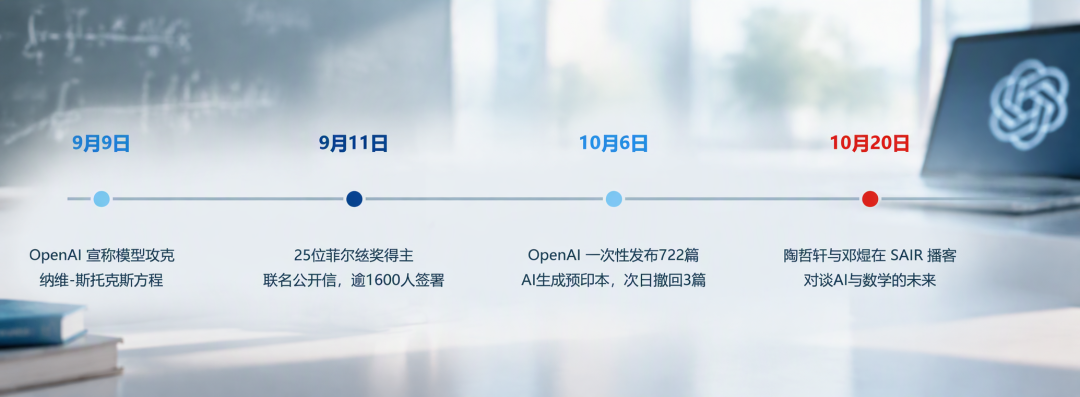
真正把舆论点炸的,是陶哲轩在SAIR基金会播客里的四个字:有毒废料。他和新晋菲尔兹奖得主邓煜对谈时说,批量解题的产出只是副产物,“得想办法处理,或者由数学家来处理”。钛媒体界面新闻
说过头了吗?其实陶哲轩自己都承认,这批成果里跟“准黎曼猜想”相关的结果,把zeta函数的无零点区域推进到7/8,是“该问题五十年来最大进展”,而且“恐怕没有一位在世数学家能独自组装出来”。钛媒体
成果是真的,问题出在发布方式:722篇里经过Lean形式化验证的只有约22%,10月3日到6日新增的143篇里,一篇都没有。陶哲轩给这种状态起了个名字——证明消化不良。钛媒体
邓煜的视角更扎心。他说数学一直有两条边界:一条是“已经证明的问题”,一条是“人类能理解的证明”。过去几百年这两条线基本重合,能解出来自然就懂。AI把这两条线掰开了:答卷堆成山,看懂的人没变多。
但数学家忙着给AI立规矩的时候,后院起火了。
10月22日,哈佛两位研究人员发表论文,对比134组审稿意见:Claude Opus 4.8当审稿人,GPT-5.5当裁判,AI在七个维度全面获胜。为防AI偏袒同类,还专门请来3位前学术期刊主编盲评——30次比较,26次选AI。更扎心的数字:AI审稿的事实错误率5.5%,人类专家15.9%。AI引用的651条参考文献,全部真实存在。字母AI微博
AI为啥审稿这么强?论文的答案很朴素:它不会累。平均每审一篇论文做12.4次联网检索,补文献、找弱点、查方法三个维度胜率100%。副作用是偶尔较真到荒唐——它会严肃质问作者,为什么没给2+2=4里的加号下定义。字母AI
说句公道话,哈佛测的主要是社科论文,证明不了AI能独立审复杂数学证明,数学界要求严格验证依然有道理。
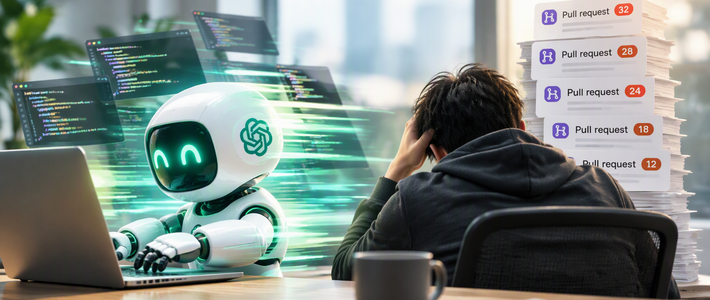
但对每天敲代码的人来说,这场架就是一面镜子。B站那条爆火视频的标题就是《AI 写得比你读得快,code review 要怎么做?》。学术圈“验证成本甩给共同体”的危机,换成工程圈就是“维护成本甩给下一个接代码的人”。哔哩哔哩钛媒体
而哈佛的研究指出了一条最务实的路:AI挑论文的毛病比主编还狠,让它帮你审PR绰绰有余;视频作者给的解法也同款——挑错交给机器double check,用全新上下文的子agent独立复查。AI审AI,今天就能上生产。哔哩哔哩
陶哲轩开的药方,翻译过来其实一样:没有理解和溯源的产出,不配进入文献;你讲不清楚的AI代码,不配进主分支。
机器开始批量生产答案,但“理解”的责任,暂时还归人类。