『43.6年回本』和『官方价只便宜15%』都是真的:回本计算器火起来的48小时,我把sunkcost.ai的默认账、两台小主机价签和一张反向账单表摆进同一张表——本地模型回本机之前,先确认你换的是哪张账单
这周,"买台机器跑本地模型、用省下的API钱回本机"这个入坑理由,被一个网站算出了官方答案:43.6年。
sunkcost.ai,首页默认搭配是 Mac Studio(M5 Max 64GB)跑 Qwen3.8 27B,算完直接告诉你:43.6年才回本。 10月16日一早知乎那篇《想买AI设备跑本地模型?用Sunk Cost工具算算多久回本》把这页摆了出来,打算掏钱的人当场被浇了半盆冷水。知乎
但更有意思的是另一头:我把这周几台设备评测帖底下的30条有效评论翻了一遍(微博 M5 Pro Mac mini 首发评测赞980/评150那条、B站 Halo 对 DGX Spark、“一键部署真没门槛了”、Codex接本地档位),没有一条评论在算回本——“跑图脸崩了本地就没意义”——这是那条赞980的M5 Pro Mac mini评测微博下的热评。 “DGX Spark 128要涨价到6949”、“之前没买,现在应该涨疯了”、“Windows党,表示不会用”,是他们吵的其他事。微博
两拨信号摆在一起,结论就出来了:劝退你的是工具的账,催你下单的是价签的账,而这两本账都不是你的账。 这篇把三本账拆开,帮你换成自己的数字。
一、先把43.6年这本默认账拆开看
数字全部来自那篇知乎文章对工具的转述,我先复述一遍它的构成。知乎
设备:Mac Studio M5 Max 64GB,$3,499;
模型:Qwen3.8 27B Q4_K_M,工具评估推理速度约25 tok/s;
需求:智能体编码场景(Claude Code 这类),输入输出token比约15:1,假设每天消耗50万token;
本地月成本:电费约$0.26;对照云端:同样的token走 OpenRouter,约$6.94/月;
每月省$6.68,$3,499 ÷ $6.68 ÷ 12 ≈ 43.6年。
这本账没作弊:电费算了,32k上下文的2.1GB KV cache也算了。让它难看的是"你每月只花$6.94"这个假设——工具默认你替换的,是开源模型自己那张贴地价的API账单。

二、决定回本的从来不是机器多贵,而是你换的是哪张账单
Qwen3.8 27B是开源权重,第三方API跑它,单价天然便宜。拿一台$3,499的机器去省这张账单,怎么算都是40年起步。
但真动手攒机的人,掏的钱、要换掉的,不是这一档:是每月给 Claude Code、Codex 这类编码订阅、给闭源高档模型 API 烧的账单。工具自己的总结里也留了口子:"不同设备、不同模型、不同需求,回本年数自然不同;24小时一直用,估计很快就回本。"10月15日知乎那篇《2026年AI大模型定价全景图》把另一半变量也挑明了:价格战在2026年进入白热化,今天性价比很高的模型可能因为半年后的价格调整变得不再划算。 你在追的回本目标本身是个移动靶。知乎
照工具给的公式(回本月数 = 设备价 ÷(API月账单 − 电费)),用M5 Max这台$3,499的机器、同样扣掉电费,我自己反推了一张档位表(注意:以下是反推值,不是工具给的数):
月账单 $6.94(工具默认档)→ 约43.6年;
月账单 $30 → 约9.8年;
月账单 $60 → 约4.9年;
月账单 $100 → 约2.9年;
月账单 $200 → 约1.5年。
用量同理:50万token/天对挂着Agent连轴转的人偏轻,日消耗翻几倍、账单近似翻几倍,回本账就重算一遍。
所以入坑前的第一问不是"我显卡多大",而是"我每月那张AI账单是哪个位数"。账单不到$20的,本地不省钱;账单过百且长期稳定的,43.6年就是别人的账。
三、价签这一本:$699价差和6.6%带宽差,都不是你抄作业的接口
这周传得最响的另一笔账:AMD Halo小主机"比DGX Spark便宜一大截"。硬件日报把官方价签摆平了:$3,999.99 对 $4,699,差$699.01,只便宜15%;网上刷的"1,499美元"说的不是这台。内存带宽差距也只有6.6%。UP主的结论一句话:想在家跑大模型,两台每块钱能装下的模型差不多,别光看价签。 价签外还有一层行情:Halo对比视频底下有观众报"DGX Spark 128(G档)要涨价到6,949"——这条是单点自述、没有官方口径,当不得真,只能当风向;但"之前没买,现在应该涨疯了""价格、哪里购买都不说"这类评论反复出现,说明这类小主机的渠道价格波动已经成了比参数更先行的门票变量。门票要按"每千元能买到多少GB内存/显存"来比,而且要按当天可下单价,不是发布会价。哔哩哔哩

四、显存档位这一本:一个减法,和一行藏在条款里的字
不想上小主机、想用手里显卡的,这周Codex接本地模型那期给了个好用的口诀:留给上下文的空间 = 显存 − 模型文件大小。8G、12G、16G、24G各档能塞什么,UP主用"显存减文件大小"一个算法划了四档,12G实测 gemma4:12b 整份进显存,数字核于10月13日。两个坑评论区都帮你踩过:Ollama默认上下文只有4096,开大继续吃显存;Codex、Claude Code能接本地模型"免费用",但Anthropic官方文档写明不支持接非Claude模型——免费午餐的条款页里有字。 想再省一点的中间路线,看看Qwen3.8-27B评测帖里的口粮配置:9700X + 64G内存 + 4080 32G显存,Strata引擎把热门专家放显存、冷门放内存、PLE表放硬盘,专家命中率95%以上。 这是"拿内存换显卡"那条路的现实形态,两头不靠。哔哩哔哩知乎
五、时间这一本:账单上没有、但每天都付
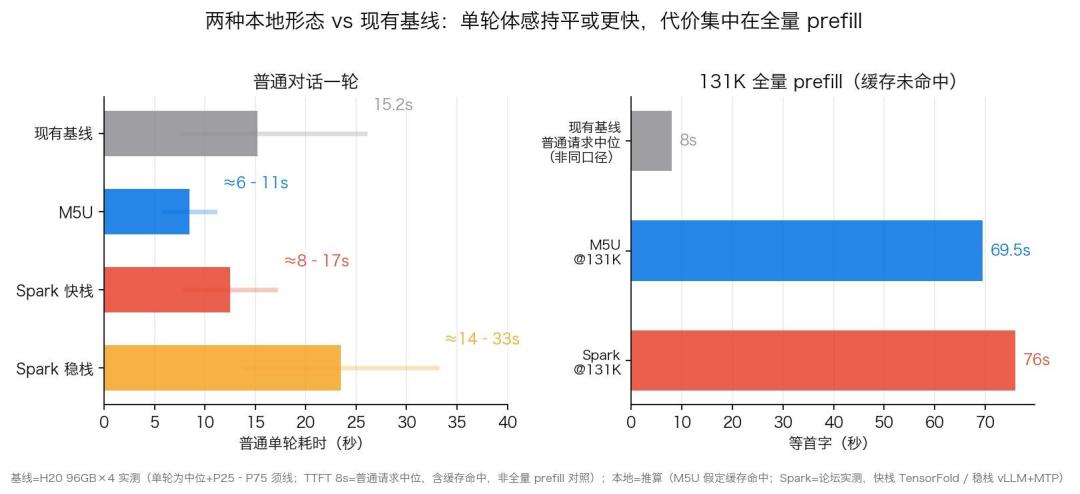
SunkCost的总结里有两条被很多人略过:本地25 tok/s对云端80 tok/s,“大部分时间你可能一直在等”;智能体场景输入占15倍,等待是复利。本周一个现成样本:有人把日常AI日记工作流迁到128GB Mac Studio,写一篇日记跑了100分钟。 所以"回本"要算两笔:钱账(你换哪张账单、几年回)和时间账(每个任务多等多少)。挂后台批处理、过夜跑任务的,时间账可以近乎记零;一问一答的交互用法,25对80就是每小时都交的税。哔哩哔哩
六、这三本账合起来,什么人该买、什么人不该
SunkCost总结的第六点才是真结论:选择本地设备肯定不是为了省钱,也许是为了安全,也许是为了测试、微调、训练。 社区30条评论里0人算回本、8人观望等实测、4人为涨价焦虑,也印证了同一件事:掏钱的人和算账的人根本不是一批人——这才是这篇内容真正的信息差。知乎
该买的:数据不能出机(客户资料、文档、隐私场景)、要微调/实验、挂Agent 24小时连轴转、每月闭源账单稳定在$100以上。
别为"省钱"买的:替换目标是OpenRouter开源低价账单的、轻中度聊天用户、对速度敏感的交互场景——对这几类,43.6年就是答案本身。
观望党盯三个信号。其一,Qwen4的完整阵容已在9月云栖大会官宣——Qwen4-Max、Qwen4-Flash、Qwen4-Plus、Qwen4-27B四员大将,但当天并没有发布任何一个Qwen4模型,权重至今未落地。 一旦开源,64G/128G档的档位图会重排,先别为"马上要过时"的权重上顶配。其二,API价格战节奏——云端每降一次价,你的回本线就抬高一截。其三,Spark涨价传闻有没有官方口径。知乎
工具是开放的,把你自己的日token数、模型、每月账单填进sunkcost.ai,算你自己的账。本地大模型不是免费,是把账单改成一次性付清加一笔时间税;要不要预付,取决于你要换掉的那张账单有多大。 默认账的43.6年是公共服务,不是判决书。