这周AI圈的信息流,从"谁的模型更强"切换到了"谁来判卷子"。
先看今天36氪的两条线。一条是报道:阿里巴巴正考虑领投AI评测与后训练公司UniPat约3亿美元,估值约25亿美元,腾讯、老股东红杉中国被曝有意参与。必须把话说在前面:这笔交易还在谈判阶段,金额、估值、条款、最终名单都没敲定,远没到"已交割"。另一条是一家你几乎没听过、但数据炸裂的同行:卖"判卷数据"的Snorkel AI,一年前年化收入只有约2000万美元,现在超过3.5亿美元——9月22日刚完成3.5亿美元E轮,估值35亿美元。36氪36氪
这两条线指向的是同一个位置:大模型卷了四年参数、算力、语料之后,下半场开始卷一门此前没人当生意做的行当——“判卷权”。
一家90后创办的"AI考官",凭什么值25亿美元
UniPat成立于2025年末,创始人李宽是90后,创业前在阿里通义实验室实习,参与通义DeepResearch项目,做的正是后训练分析、数据合成和强化学习。
它摆在明面上的一串评测集:SaaS-Bench把23个真实开源SaaS系统装进Docker,让模型跑106个跨应用长流程任务;EvoCode-Bench考多轮需求变更下的连续开发;Terminal-X考复杂工程任务和版本升级。藏在明面底下的是生意:据报道,它和阿里的合作以强化学习后训练数据为主,先在较小模型上做低成本实验,筛出有效方案再放大。36氪
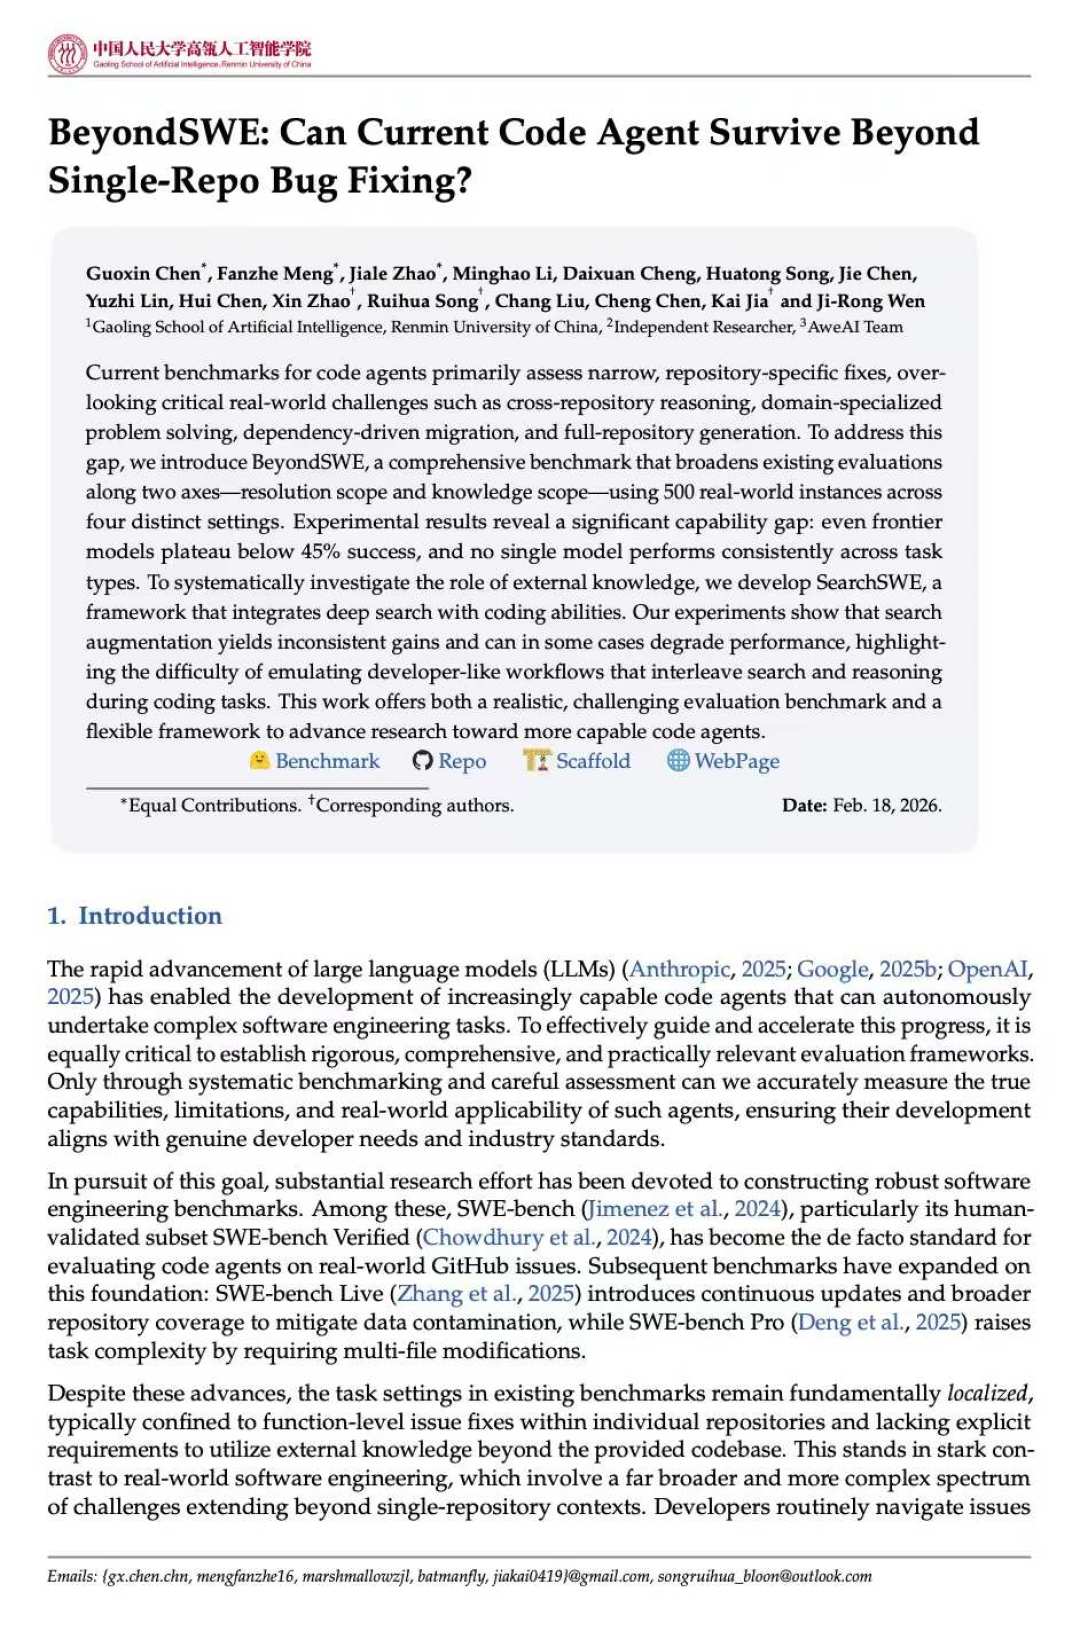
为什么"考官"突然值钱?因为考法变了。上半场Benchmark够用,是因为模型只是"答题":给题、出答案、算准确率。Agent时代这套失效了——任务是一连串动作:理解环境、规划步骤、调用工具、改代码、查库、处理异常、回滚、交结果,中间任何一步歪了,末端答案再漂亮也没用。传统评测测"知不知道",企业验收要的是"能不能把事办完"。
而真正值钱的也不是分数,是演练留下的失败轨迹:哪一步决策错了、验证器为什么拒、人工Rubric怎么扣、换一条路径能不能收敛。这些轨迹直接进SFT、奖励模型或强化学习,闭环就成立了:评测找弱点→切失败轨迹→标Rubric和偏好→合成数据→后训练更新策略→再评测。拆开"判卷权"这个词,其实是三样东西:任务定义权(题目怎么设,模型就被逼着往哪卷)、评分标准权(标准一变,强弱排序整个重写)、反馈数据权(最稀缺的不是"问题—答案",是"环境—行动—结果—奖励")。参数可以堆、算力可以买,但"什么算好"的定义权,只有一份。
资本已经挤进"阅卷室",数一数全行业都在掏多少钱
Snorkel不是孤例。把这几天同赛道的数字排在一起:
Snorkel AI(36氪,9月28日):年化收入从约2000万美元到超3.5亿美元;E轮3.5亿美元,估值35亿美元。它2015年起家于斯坦福实验室,原是"专家把判断写成规则、机器批量标注"的软件公司,2025年起直接替AI公司找程序员、律师、医生出题、写评分标准、质检,交付训练数据。
Micro1:最早做AI招聘,去年年底年化收入约1亿美元,今年8月已到5亿美元。36氪
Handshake:做了十多年的美国高校招聘平台,今年1月这项业务年化收入5.5亿美元,4月已接近10亿美元。
AfterQuery(本周硅谷101节目请了Scale AI的评测研究员来拆这门生意):4月A轮估值还是3亿美元,9月被新一轮推到32亿美元;另一家做训练数据与智能体环境的Bespoke Labs,种子轮加A轮合计4000万美元。哔哩哔哩
给AI出题、判卷、纠错,正在从"配套小功能"变成一条收入暴涨16倍的独立赛道。
同一天的另一条线,则展示了"考卷"本身的失信程度。36氪那篇《ARR真的是大模型企业的黄金指标吗?》把账摊开:智谱按8月单月收入乘12,ARR约16亿美元;改按8月最后一周乘52,就超过20亿美元——只换了观察窗口,数字先涨四分之一。DeepSeek年化收入约10亿美元,推进二融的目标估值约740亿美元,等于74倍ARR;OpenAI最新一轮冲1.2万亿美元,约50倍ARR;Anthropic的ARR约650亿美元,按9650亿美元估值是15倍。出题的和被考的,两边都在给"判卷"抬价——但谁来判"判卷的卷子"?36氪

考场自己的信用也在掉。B站这两天扎堆出现两个实测标题。第一个问的是:分数很高,但实际生成表现到底稳不稳? 第二个问的是:大模型真的会写代码,还是只是背下了SWE-bench基准? 小红书上,AI产品经理开始补课MOS打分法、Rubric打分法,一条"AI评测最大的问题:上下两不沾"的笔记也被点了赞。哔哩哔哩哔哩哔哩小红书
这恰恰是整件事的另一半:AI越"自己教自己","判卷"反而越稀缺。Anthropic自己披露的数字——截至2026年8月,Claude已能主导其26%的AI研发工作,90%以上的研发任务至少进入AI协作阶段,内部平台上约3万个Agent同时参与研究。AI已经能自己提出改进方案,但"改进"的定义,还得有人写尺子。自我迭代越加速,"什么算好"越贵。36氪
更冷的现实是,这些钱最后都流向同一个地方——机房。Claude的CEO今年2月描述过这种重资产困境:数据中心要提前一到两年建设,算力合同往往持续数年。模型每卷快一代,机房的折旧就快一年——而评测公司赚的,恰恰是"每一代模型到底好没好"这道判断题。36氪

交割之前,三道绕不过去的坎
第一道是中立性。阿里领投、腾讯若跟投,客户里却坐着其他大模型厂——你给自家模型松Rubric吗?Scale AI就是前车之鉴。UniPat这类公司要么把验证器做透明,要么把商业评测和公开Benchmark分拆,否则"考官"迟早被质疑成"自家教练"。这在中文AI圈尤其绕不开:客户和股东,本身就是同一批巨头。
第二道是收入。现在能确认的是评测集和技术口碑,确认不了的是可持续的合同和毛利结构。后训练数据定制客单价高,但依赖头部实验室的预算——头部一收缩,收入就抖。
第三道是工程。真实SaaS环境、浏览器环境、多工具调用,维护成本极高;Benchmark被刷是常态,验证器漏判会直接污染奖励信号。能不能把评测做成可调用的RL环境,决定它最终是数据公司,还是基础设施公司。
接下来盯什么,跟你有什么关系
如果你是API用户或订阅党:观察习惯可以改得比看新闻更简单——少看总榜名次,多看"实战"条目:多步任务完成率、需求变更后的通过率、长流程里的可回滚性。厂商降价节奏已经摆在那里:GLM-5.3-Flash把价格压到旗舰约十分之一,DeepSeek也用更便宜的V4.1 Flash换下上线才一个月的V4 Pro。 而下一代模型先优化哪块能力,越来越取决于谁握着那把尺子。36氪
如果你在看AI相关的工作机会:“Rubric设计、验证器工程、懂行判卷专家"从隐性工种到岗位命名,是先行指标。现在还是补课期,等招聘JD里直接写"判卷经验优先”,上车成本就不是这个价了。
如果你手里有AI基金或在盯一级市场:四个观察信号——①UniPat交割时估值是否坐实25亿美元;②它会不会把公开榜单和商业评测明确分拆;③Snorkel、Micro1这批数据公司的收入增速,在下一季财报里能不能站住;④下一轮大模型公司的报价,还会不会按"周收入×52"的公式买ARR。
大模型的上半场问"谁能训得最强",下半场问的是"谁说了算’最强’"。这两个问题,恐怕不是同一批人能答的——而资本这周已经先给第二个问题开了价。