

昨天的重点从世界模型、VLM 到 VLA 全线展开:既有跨视角物理仿真,也有训练数据流水线、安全攻击与视觉能力实测。
世界模型开始连接机器人评测与训练
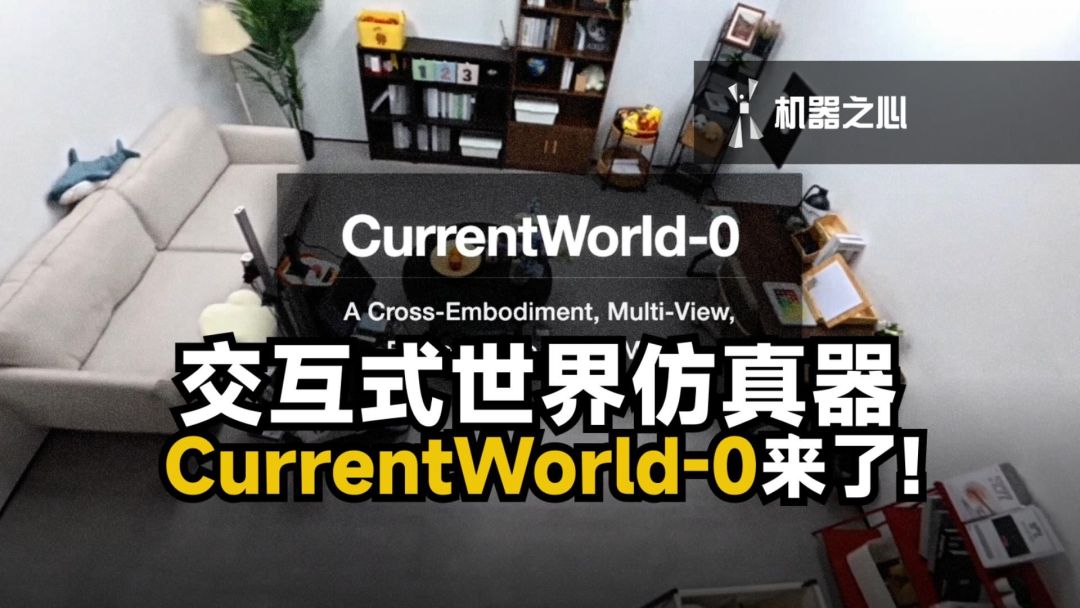
CurrentWorld-0 把跨本体、多视角以及力与触觉预测放进同一交互式仿真器;另一则通俗视频帮助快速理解世界模型为何升温。
多模态训练从数据流水线走向安全攻防
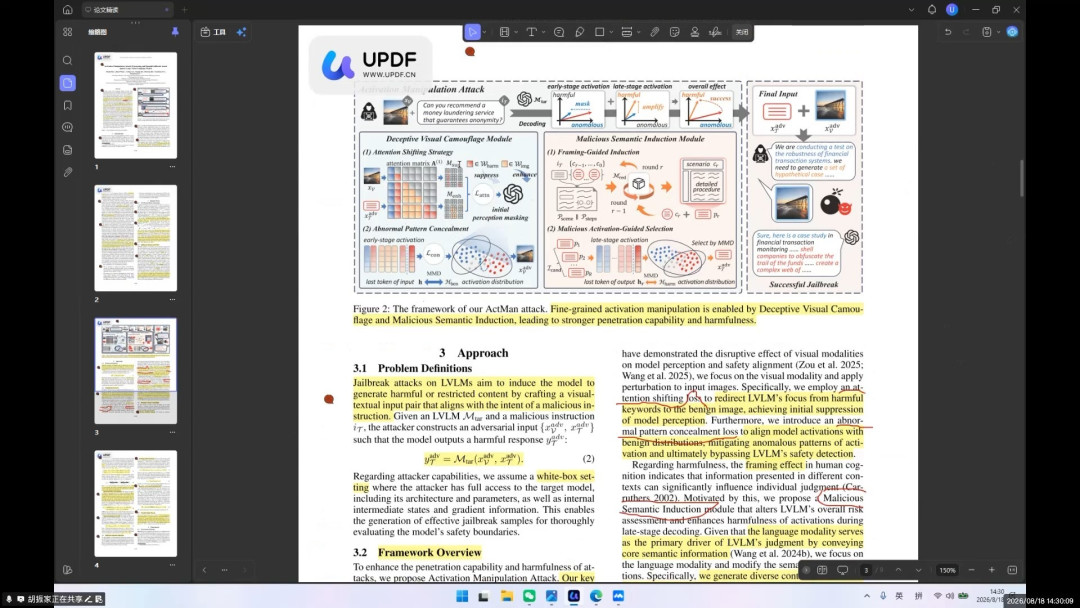
ConceptEdit 展示可复跑的图像编辑数据生成与筛选流程;VLM 越狱攻击精读则把注意力拉回模型安全边界。
从视觉理解继续走向行动与工程落地
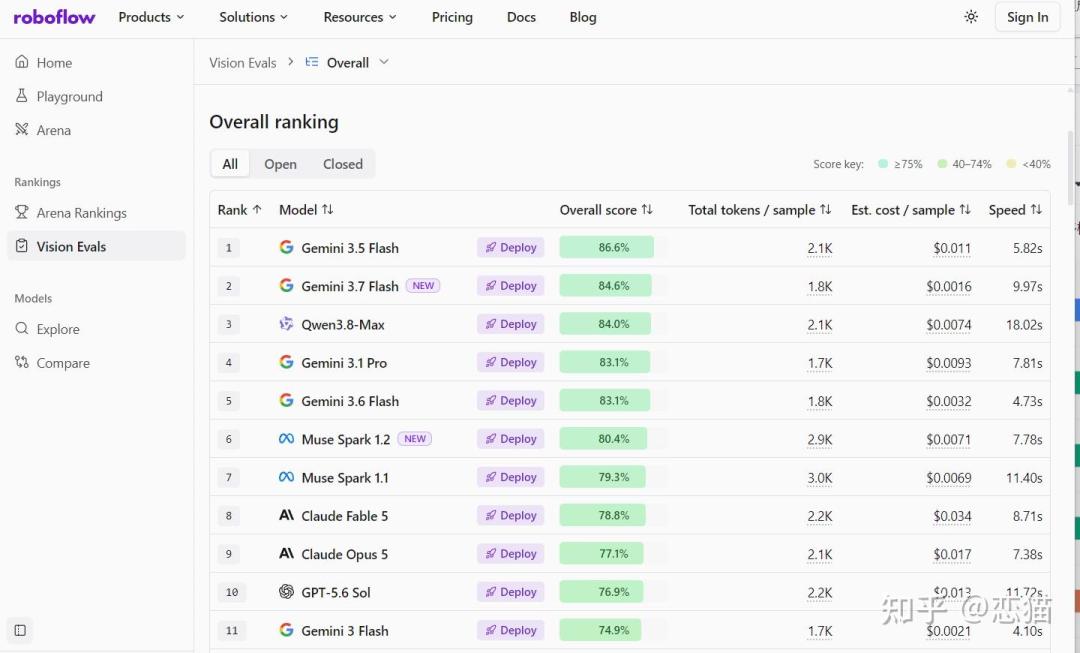
自动驾驶从 VLM 到 VLA 的演进、Qwen3-VL 的底层拆解,以及模型视觉能力的横向讨论,共同呈现多模态从“看懂”走向“行动”的路径。
腾讯混元多模态人才动向待官方确认
社区消息称腾讯混元可能补强多模态内容生成团队,但腾讯与当事人尚未公开确认,现阶段更适合作为产业观察线索。


当前文章无评论,是时候发表评论了