

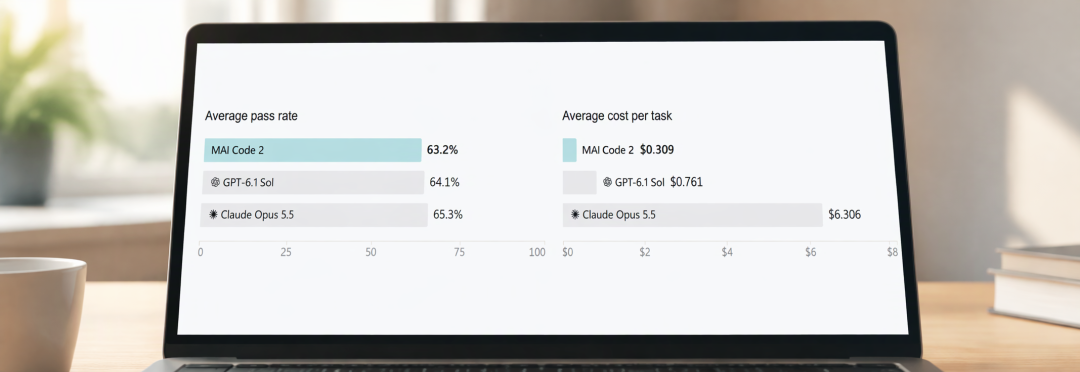
微软挑在双十一返场这个节点,给AI编程的账单市场扔了颗雷。北京时间11月18日凌晨的Ignite大会上,微软一口气亮出一串自研MAI模型,真正的主角只有一个:MAI Code 2,编程模型,当天就进了GitHub Copilot的模型列表。官方海报上的话很横:四项编程基准取平均,它的分数跑到Claude Opus 5.5的96%,成本只要5%;对比GPT-6.1 Sol,分数98%,成本40%。IT之家智东西知乎
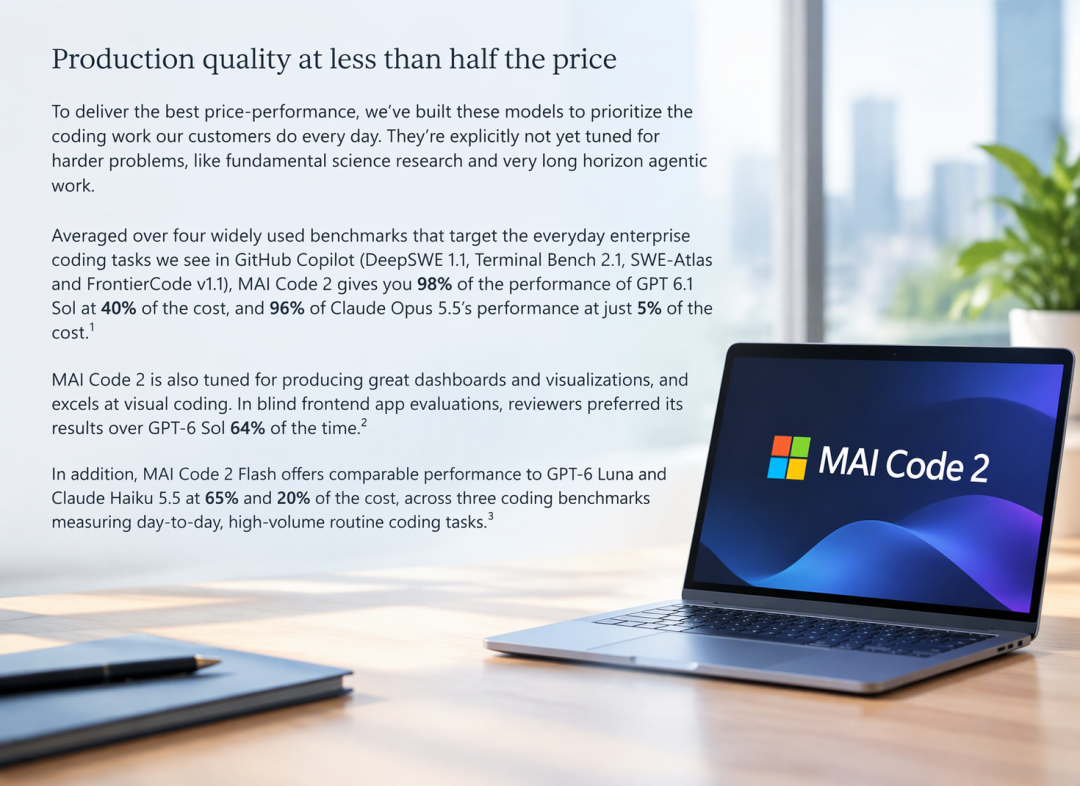
“用二十分之一的钱干Opus的活”——难怪这两天AI圈刷屏。但先别急着切模型,这组数字背后,微软把几行口径塞进了脚注,每一行含金量都不低。
口径一:成本按"5折促销价"算的
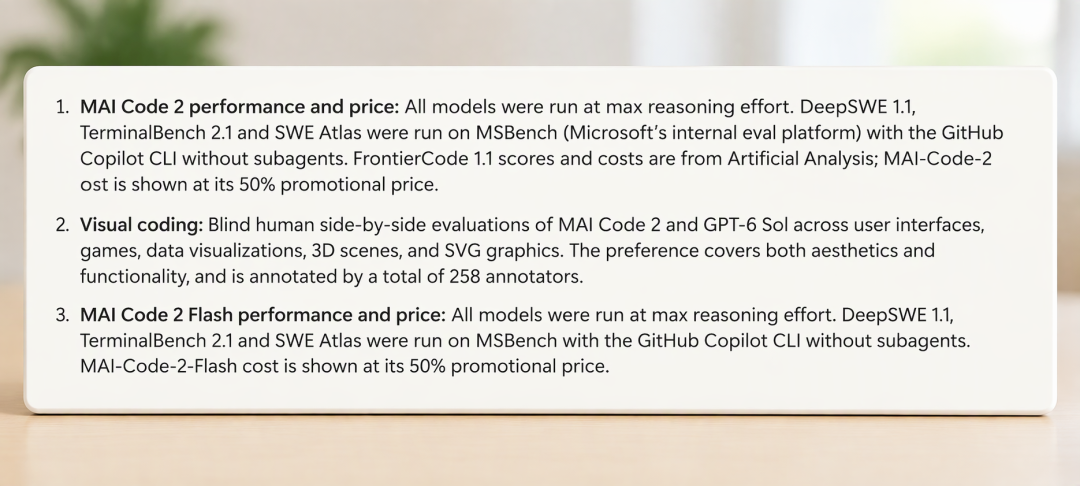
发布页脚注写明,Code 2和Code 2 Flash的成本比例都按五折促销价计算。原价恢复,成本翻倍:对Opus 5.5从5%变成一成左右——这条差距够大,原价下依然成立;但对GPT-6.1 Sol就从40%变成八成上下,“不到半价"变"打八折”。小一号的Code 2 Flash更有意思:促销价对GPT-6 Luna是65%,按原价推算是1.3倍,反超对手还贵了。而且两个分页都没写每百万token的绝对价格,也没写促销到哪天结束。双12前想续订阅、想换模型的,先问一句:这个5折,还在吗?知乎
口径二:基准大多是自己跑的
四项测试里,只有FrontierCode取自第三方机构Artificial Analysis,其余DeepSWE 1.1、Terminal Bench 2.1、SWE-Atlas都是微软在内部评测平台MSBench上自己跑的:GitHub Copilot命令行、不带子代理、所有模型开最高推理强度。跑法本身没问题,但第三方还没过这道筛。想等一个"实际项目里到底谁更强"的结论,还得看微软以外的人怎么测。知乎
口径三:只调优了"日常活"
同一页微软自己写明:这两个模型优先照顾客户每天干的活,还没针对更难的问题调优——基础科研、超长程的代理任务。主题演讲里补了一句:不会为这些小众能力牺牲客户利益。对于想把任务丢给AI通宵长跑的人来说,这行字就是说明书:日常改代码、修bug、写小工具,它是目标客户;通宵跑长程代理,先别拿它当主力。知乎
那到底要不要切?你已经有Copilot订阅的话,不用多花一分钱就能换着试——官方找258名标注员盲评界面、小游戏、数据可视化这类前端活,64%的情况下更喜欢Code 2的结果(对比GPT-6 Sol)。这是个零成本选项,试错不亏;但你的主力场景是长会话、多代理并行、硬核研究型代码,别指望"5%的账单"买回旗舰级能力,官方口径就没兜底这块。知乎
纳德拉在会前后的访谈里有句话,比海报实在:代码生成变便宜了,难的是验证。跑分可以打折,账单可以按促销价算,你review代码的那双眼睛,一分都还没降。哔哩哔哩

当前文章无评论,是时候发表评论了