

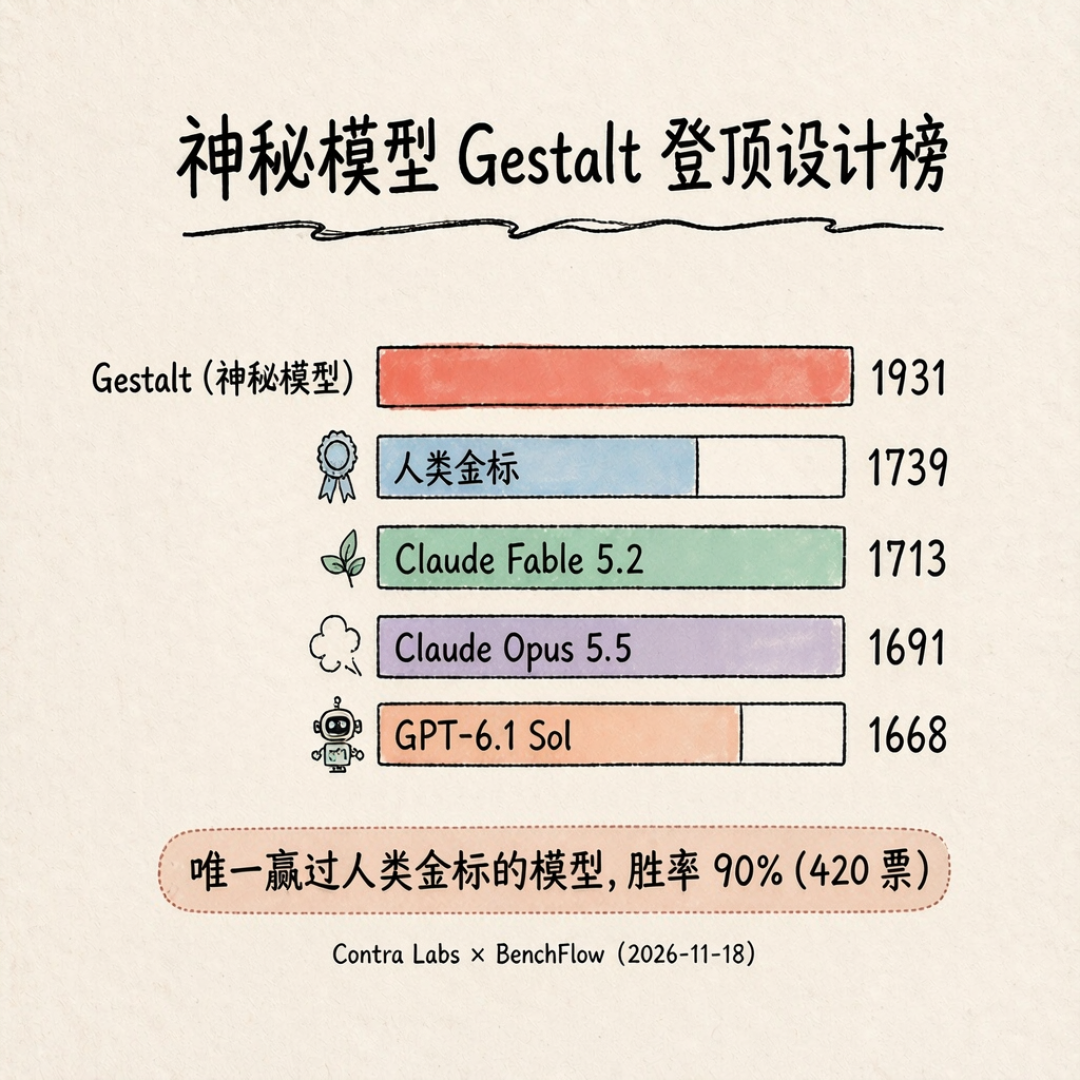
2026年11月18日,Contra Labs 和 BenchFlow 发布了首期 Frontier Design Benchmark 榜单。榜单上排第一的名字后面挂着「Stealth」:一个没有厂商、没有团队、查不到出处的匿名模型。Gestalt 以 Elo 1931 分、90% 的胜率登顶。这个差距不仅超过 200 分于 Claude Fable 5.2(1713 分),还压过了人类设计师的参考作品(1739 分)。它的能力边界,恰好被这组数据两头划出来:已证实的,是在真实商业设计简报的盲评里最不像 AI 做的、最受专业设计师青睐;身份、成本、成品可不可用、能不能持续交付,全都不在这张榜的视野里。知乎小红书知乎知乎哔哩哔哩微博知乎
这张榜测的内容不是玩具题:全部 33 项任务,27 项来自真实设计工作,另外 6 项来自创业公司合作项目。题型覆盖多页营销网站、众筹结账流程、带小测验的在线课程等商业场景。十余个主流模型同台参与,35 位专业设计师在不知道作品来源的情况下两两对比投票,累计 4311 票。Elo 分层也很清晰:前七名和后面的模型拉开了超过 200 分的鸿沟。更有意思的是时间线——榜单刚上线时排第一的是人类金标,Gestalt 是后来才冒出来直接登顶的。在与人类参考作品的 28 次正面交锋中,设计师有 20 次选了 Gestalt。知乎知乎知乎哔哩哔哩知乎知乎知乎知乎
这套基准还附带了一个 slop 检测器,给页面的「AI 味」打 0 到 100 分,而基准团队发现,93% 的样本带着同一套视觉指纹:标题上方的小型大写微文案、01/02/03 编号版块、渐变滥用、卡片堆砌、玻璃拟态、超大圆角。知乎
主流模型的生成方式很大程度上是组件式拼装,每个零件单独看都对,合在一起就成了「AI 味」;而 Gestalt 的 slop 分数只有 1.2,与人类作品的差距落在误差范围内,主流模型则差出约两个数量级。它登顶的实质不是「单项做得比别人好」,而是「最不像 AI 在做设计」——不过在另一套设计规范评分里,Gestalt 拿到 83 分,反而略低于 Claude Fable 5.2 和 Opus 5.5 的 84 分,盲评偏好和规范优劣是两回事。哔哩哔哩知乎知乎
1931 分之外,目前几乎没有可靠的数据来源。第一,它查无此人:厂商、发布日期、价格和试用方式都没有公布,公开画廊里只展示具名模型的产出,没人知道那 35 位评委究竟看到了什么。第二,成本成谜:基准报告对 Fable 5.2 的保守估计是每个网站 127.22 美元,Gestalt 这边没有任何对应数据,无法判断优势来自更高效的生成路径还是极端的推理开销。第三,榜单测的是一次成型的盲评,客户临时改目标后的迭代能力、上线后的可维护性、预算和工期内的交付,都得另看。知乎哔哩哔哩知乎
方法论本身也要打一个问号:Contra 既运营设计师市场,又发布评测设计能力的基准,它邀请各实验室联系其团队获取真实需求、golden 和选票,没有第三方复现。评委也来自与其关联的封闭池子,与人类金标的 28 次对决样本量偏小。所以,引用 1931 分时,最好始终附带这几个条件。知乎
身份猜测的图景则相当混杂,甚至出现了中文社区猜是国外模型、英文社区猜是国产模型的一幕。确实存在一个同名的公开研究:中国人民大学高瓴人工智能学院 GeWu-Lab 与上海人工智能实验室、燧行科技联合提出的 Gestalt 多模态模型,在 token 序列中引入可学习的 interplay tokens,让各模态先充分编码、再经中间层受控交换信息。网络上已经出现把两者联系起来的猜测。但没有任何证据支持这个对应关系:名字撞名,不等于身份认领。微博知乎微博
至于「AI 赢了设计师」,放回这张榜上看,赢的是这一轮盲评里的参考成品。接下来值得盯住三个信号:开发方是否现身并开放接口;第三方能否复现盲评结果;把它放进多轮改稿任务后,「不像 AI」的质感能不能留到第二版。在此之前,这次登顶更应被读成一次评测坐标的转移——设计生成的竞争轴,正在从局部组件质量转向整体是否经得起人的眼睛。那个 1.2 分的 AI 味指标,可能比 1931 分更值得盯住,因为它指向的不是「谁更强」,而是「什么才算好设计」这个问题正在被重新定义。知乎

当前文章无评论,是时候发表评论了