

微信刚开源的WeMM-Video,输入是带声音的视频、图片和音频,中文英文都收,输出是文字——它不是拿一段话生成视频的工具,而是一个"能看、能听、还会推理"的多模态视频理解模型,并且按官方说法已经接入微信生态实际使用,不是只停留在跑分阶段。先回答标题里最值得回答的问题:现阶段普通人没有能在微信里直接"玩"这个模型的入口,真正能用上的路径有两条——自己把开源权重跑起来,它的Apache 2.0许可免费且允许商用;或者等这项能力落到微信自家的视频业务里。知乎知乎
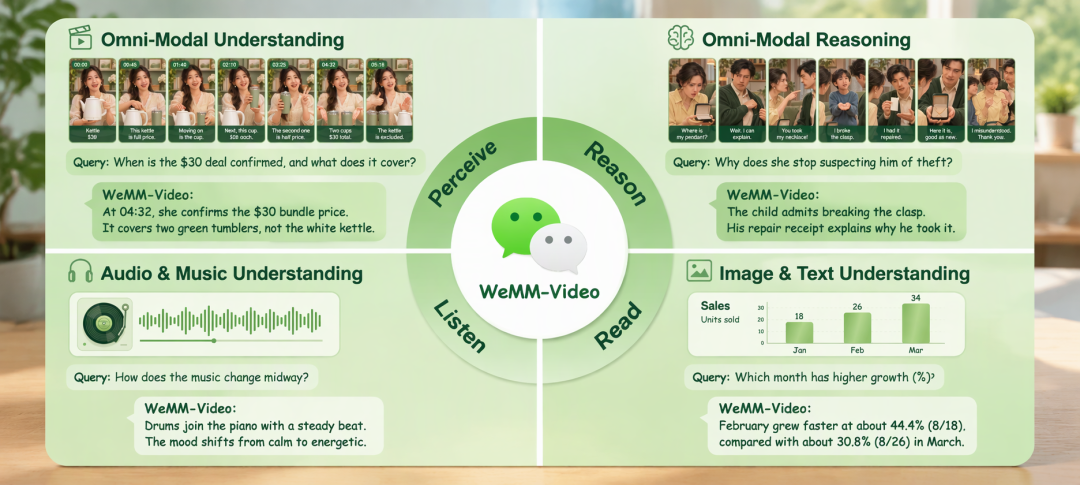
这次开源的动静非常小:十一月十七日上传权重,十九日技术报告挂上arXiv,二十日才补上量化文件,没有发布会,微信公众号上也没有推文。系列一共四档:2B、4B、9B三档稠密模型,外加一档35B参数的MoE架构,官方演示覆盖了视频理解、视频推理、音频理解与图文理解四大能力方向。模型基于Qwen3.5系定制,原有的视觉编码器和语言能力都被保留,腾讯重点补强的是音频处理、音画时间对齐和联合推理。知乎知乎知乎
这轮"闷声开源"里最实在的信号是许可:Apache 2.0,商用没有附加条件。知乎
它能干的事:把一段带声音的视频"讲清楚"
最实用的一类活,是同时听懂画面和声音:画面里谁在做什么、同时在说什么话、背景音乐和人声分得开分不开,它合成一段带推理的描述。按腾讯的说法,WeMM-Video已经在微信内部的直播电商、短剧分析和互动视频业务上用了起来——比如直播电商里,模型不只要识别主播展示的商品,还要结合主播语音判断商品介绍是否对应画面、有没有出现商品和讲解不一致的情况。知乎知乎
自己跑:文件账友好,软件门槛不低
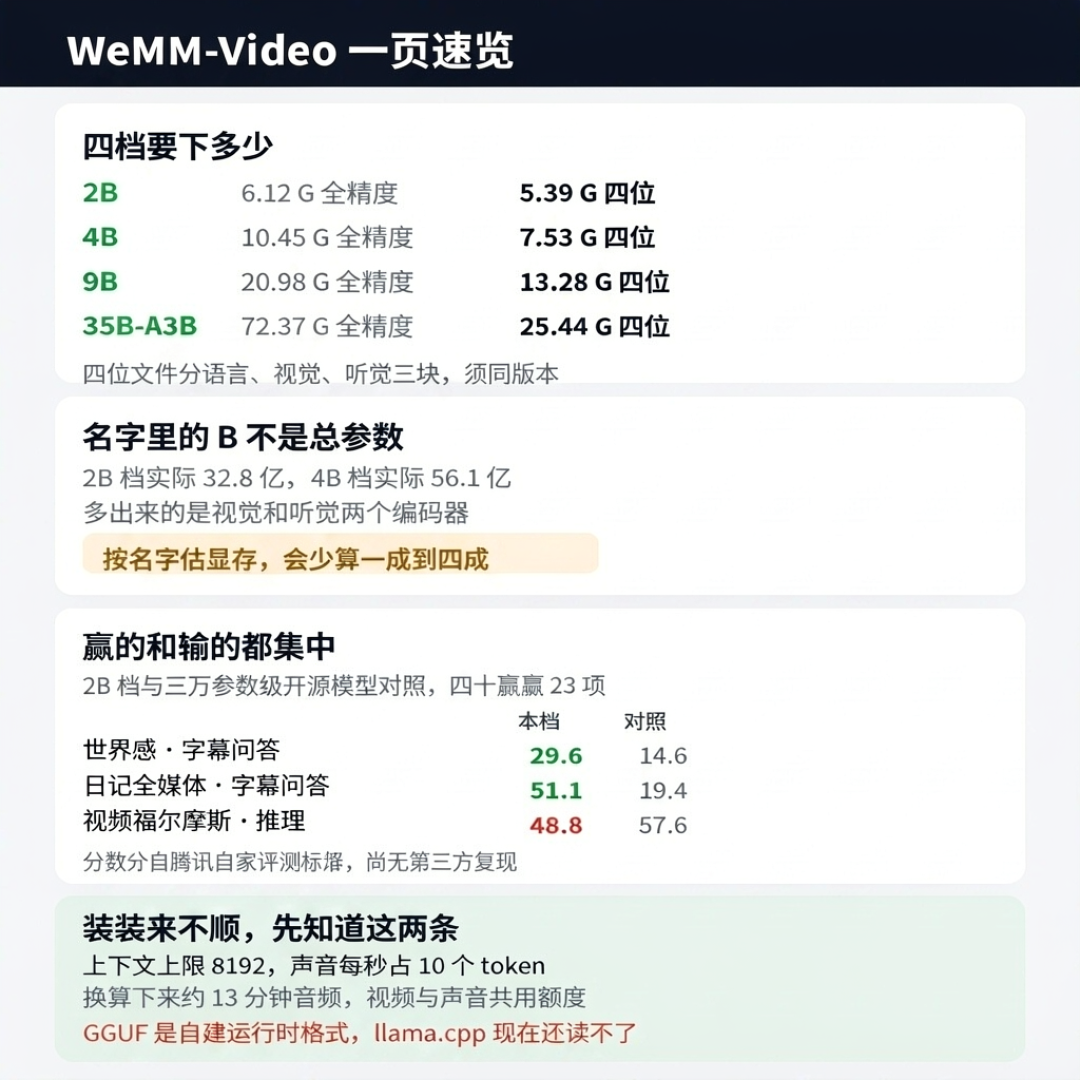
对想动手的用户,文件体积看起来相当友好:2B档四位量化5.39 GiB,4B档7.53 GiB,9B档13.28 GiB,旗舰35B-A3B四位量化25.44 GiB。注意名字里的2B、4B指的是语言主干而不是总参数,加上视觉、听觉两个外挂编码器后账会大一截,按名字估显存会少算一到四成。知乎
做字幕、做画面描述这类活,2B够用,而且便宜到能放进一台笔记本;要判断一段视频里某句话和某个画面是否互相矛盾,就得4B起步。知乎
但"能跑起来"目前远不是装个软件那么简单:vLLM和SGLang现在都不支持这个架构,官方走的是打补丁路线,还得配特定的CUDA、PyTorch和Python版本。知乎
最被普通玩家寄予厚望的"捷径"同样还没打开:官方放出的GGUF量化文件是给自家WeMM native runtime准备的格式,llama.cpp、Ollama、LM Studio现在都读不了。所以现在的合理分工是:手上有一批短剧或直播切片、又有会调推理框架工程师的团队,值得先行试跑;纯粹想在家里跑一个玩玩的用户,更优选择是等社区把安装和转换脚本补齐。知乎
分数该怎么看:官方评测为主,推理是2B的短板
评测数据要带着前提看。在技术报告的对照里,2B档对上参数规模大它十倍的Qwen3-Omni-30B,四十项赢了23项,赢的集中在字幕和带声音的视频问答,输的集中在推演——WorldSense字幕问答2B是29.6、对面只有14.6,Video-Holmes推理项则是48.8对57.6。换句话说,2B强在"把视频里有什么讲清楚",弱在"猜视频接下来会发生什么";中文语音识别精度上四个档位也没有拉开明显差距,追求转写更准可以另找专门模型。知乎
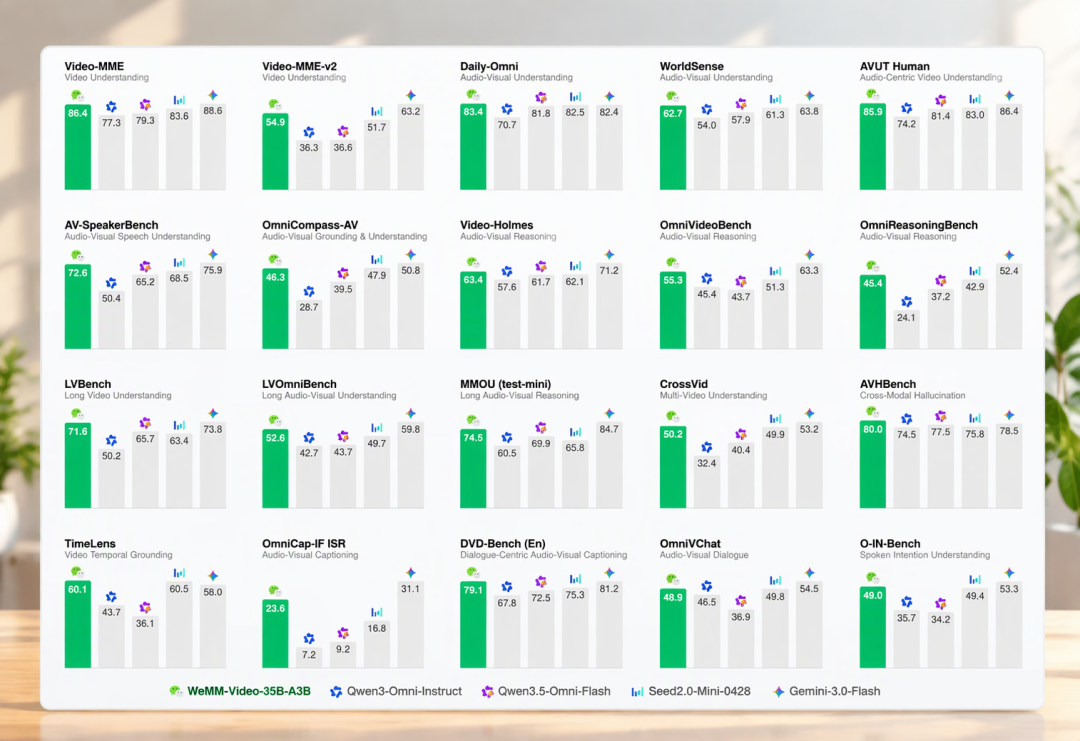
更要紧的一条:报告里的所有结果出自腾讯自己的评测流程,外部还没有一个人复现过。官方验证的硬件范围也仅覆盖少数几款数据中心显卡,速度、显存占用、并发这些实际部署要用的数字一个都还没有公布。知乎
对大多数用户,真正的入口在微信生态里
这不是微信视觉团队第一次"先在自己家里用、再开源"。几个月前的WeMM-Embedding就先把文本、图片和视频编码进同一个语义空间,部署到微信视频号、公众号和电商内容的推荐与检索里。沿同样的路线,WeMM-Video的音画联合理解更可能先体现在直播带货审核、短剧内容理解这类B端场景,再逐步外溢到普通用户接触得到的功能。知乎IT之家
所以"普通人能用到哪些功能",按现在的证据分三层:不碰命令线的用户,眼下没有任何直接使用入口,能等的是微信生态内内容功能的逐步变好;有开发能力的个人和小团队,现在就能免费下载权重、按Apache 2.0商用,2B档足以跑字幕生成和视频摘要;而想在家里"一键尝鲜"的大多数用户,值得盯着两个信号——llama.cpp、Ollama等主流工具链何时支持这套量化格式,以及第三方何时复现出评测结果。在此之前,先收藏,别急着装。

当前文章无评论,是时候发表评论了