

你一定有过这种体验:照着榜单选了排名最靠前的AI,结果实际用起来它"抽风"——同一个问题今天一个答案、明天另一个答案。排名越高,翻车越让人困惑。
这不是错觉。Arena 系的人类盲测榜单,如今已经是判断"哪个模型强"的事实标准:官方榜单最新一版截至 10 月 27 日快照,约 900 万次累计投票、419 个模型参与。但这类榜单大多只回答"答得对不对",不回答一个更要命的问题——它错的时候,自己知不知道。知乎
11 月 13 日,新加坡国立大学团队的 SO-Arena 评测(arXiv:2611.15777)冲上当日 HuggingFace Daily Papers 榜首,补上的正是这半边。知乎
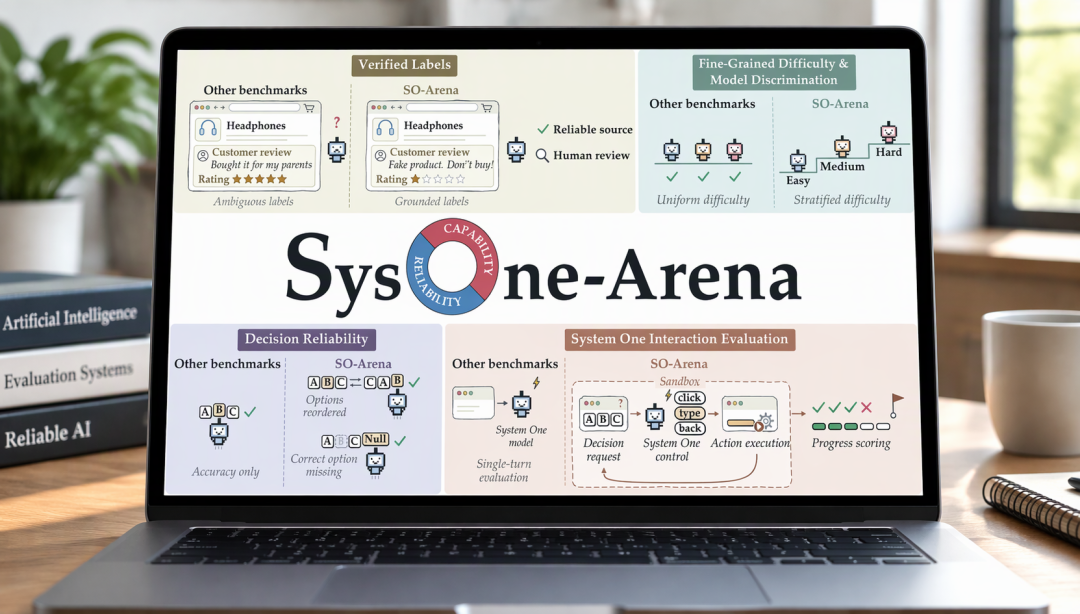
它检查的不是"想得多"的大模型,而是一类不假思索的秒答"决策模型"。以 9 月 15 日 TypeSafe AI 发布的 System One 决策模型 Jev 为代表:放弃字符串生成,只从预先定义的选项里输出带概率的判断。这类模型一次前向传播直接输出概率分布,不给推理过程,延迟极低,Jev 之后 Kev、JevAny、GLiDE 等开源实现也陆续出现。知乎知乎知乎
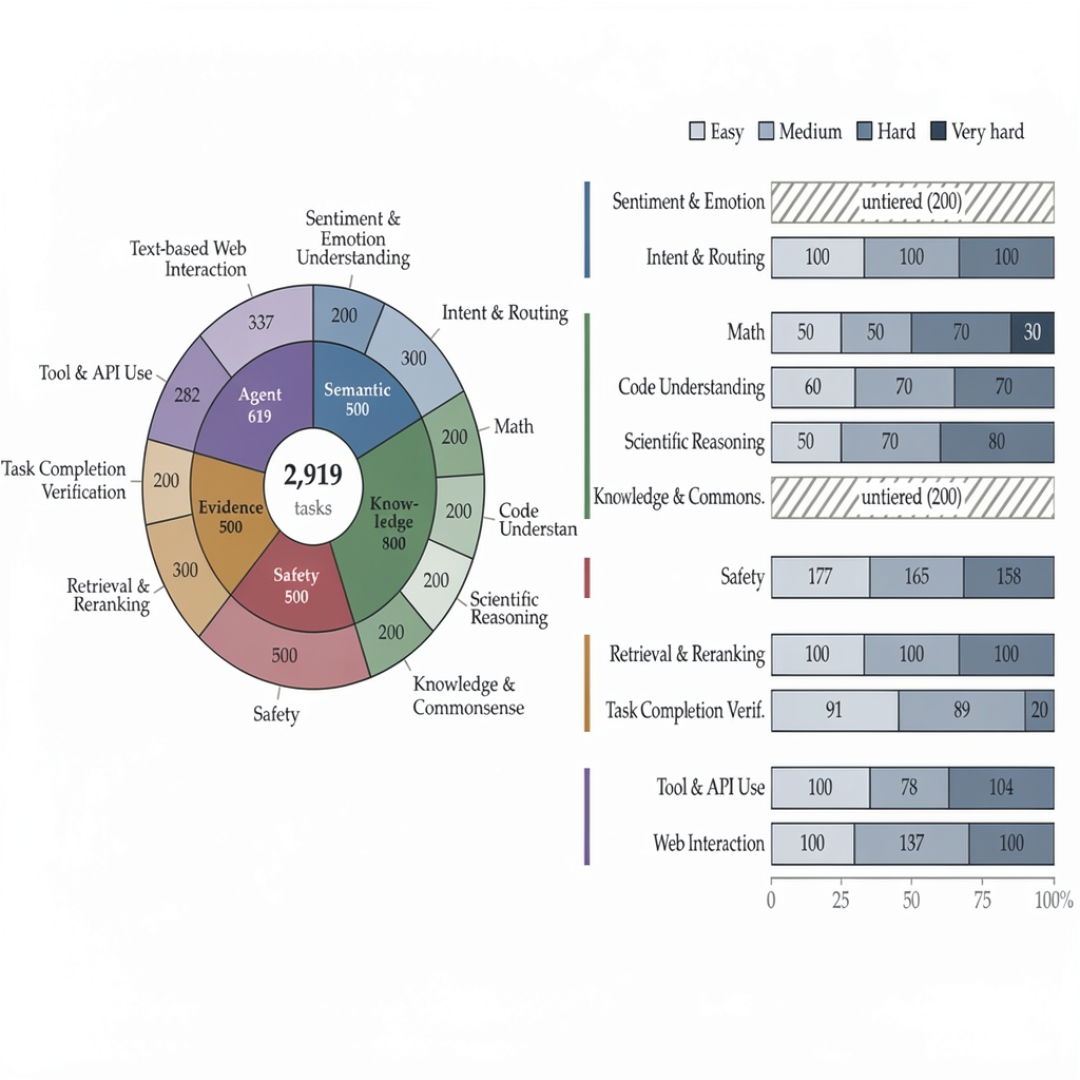
第一次,这类模型接受了"全身检查":2,919 道题、11 个领域、5 大能力族,评测覆盖 21 个模型。结果扎心,也提神:知乎
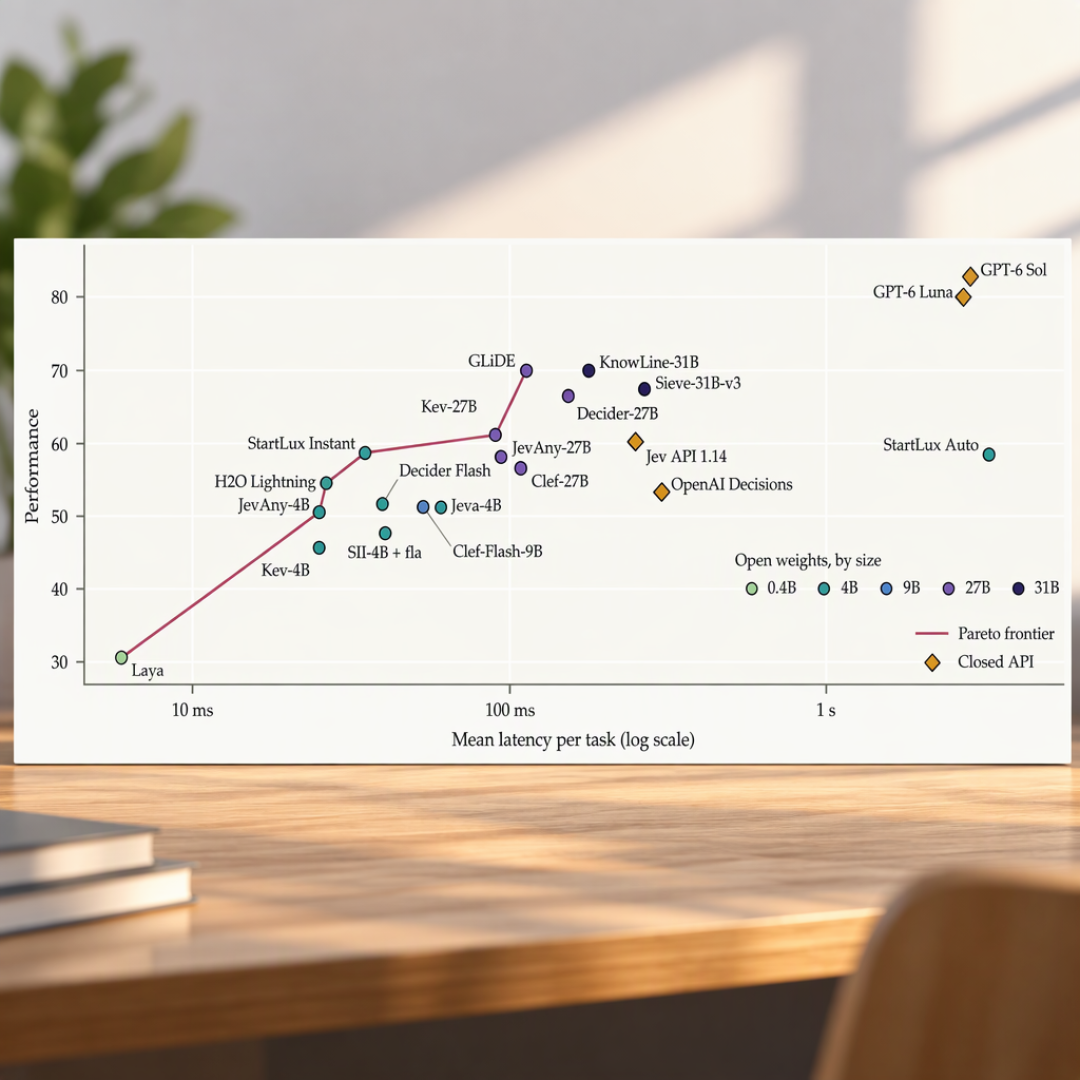
能力榜第一的模型,可靠性只排第七;最稳的那个,能力才排第十一。“会答题"和"不抽风”,是两张榜。知乎
SO-Arena 出了两道狠题。第一道:把选项顺序打乱再问一遍,它还选同一个吗?18 个模型里 14 个做到 0.8 以上,剩下四个对顺序敏感,其中 Laya 只有 0.35,离随机水平最近。第二道:把正确选项抽掉,它承不承认"没有正确答案"?这项的分差更夸张:从接近随机一直到 0.8,而且跟参数量无关——Kev-27B、Jev API 1.14、JevAny-27B 这三个甚至超过了能力榜前四的模型。认不出"没有答案",就是"自信胡说"的最高形态。知乎
快是决策模型的立身之本:单张 H100 上,所有开源 System One 每题都在 0.3 秒内完成,比 GPT-6 系列快几十倍。知乎
但短板也很直白:数学、科学推理、代码这类多步推导任务它们都不行,只有开长思考才能把数学分从 50.8 拉到 92.5,可那就一点也不快了。知乎
对我们普通用户意味着什么?别让一张能力榜替你定选购。日常问答、语义判断,秒答模型够用;数学和复杂代码,还是老老实实开思考模型;而审核、路由这类要求"不抽风"的场景,上线前先做"换序、去正确项"两道自检——花不了多少算力,但能拦住大部分生产事故。
当然,SO-Arena 的结果目前只覆盖决策类场景,别把结论直接套到日常聊天。但它至少证明了一件事:榜单只告诉你谁答得好,不告诉你谁敢托付。知乎
当前文章无评论,是时候发表评论了