一个客服 Agent 处理一笔退款用了 40 秒。模型回复其实很快,没有抛异常,接口全部正常返回,APM 面板一片绿。慢在 `lookup_order` 这个工具调用:它在等订单 API,订单 API 又在等昨晚上线后变慢的数据库查询。这是知乎上有篇复盘真实拆过的例子——排查结束后你会发现,全程「没有一处报错」。知乎
这类事故有个共同点:什么都没坏,但活干错了。传统监控回答的是「服务还活着吗」,Agent 需要回答的是「这个决策对吗」——它错的那一步看到了什么、选了哪个工具、参数为什么是这个。可多数人的 Agent 日志,翻开还是 print(),只能靠记忆和运气把过程拼回来。
这两周,圈里的人正在不约而同地补这个洞。
一、先看时间线:10 月中旬到月底,谁在砸开 Agent 这个黑盒
10 月 10 日,云器科技发复盘文:Agent 进生产后需要同时观察两层——系统稳定性是一层,Agent 的任务正确性是一层,「系统层面全部正常,不代表业务任务正确完成」。知乎
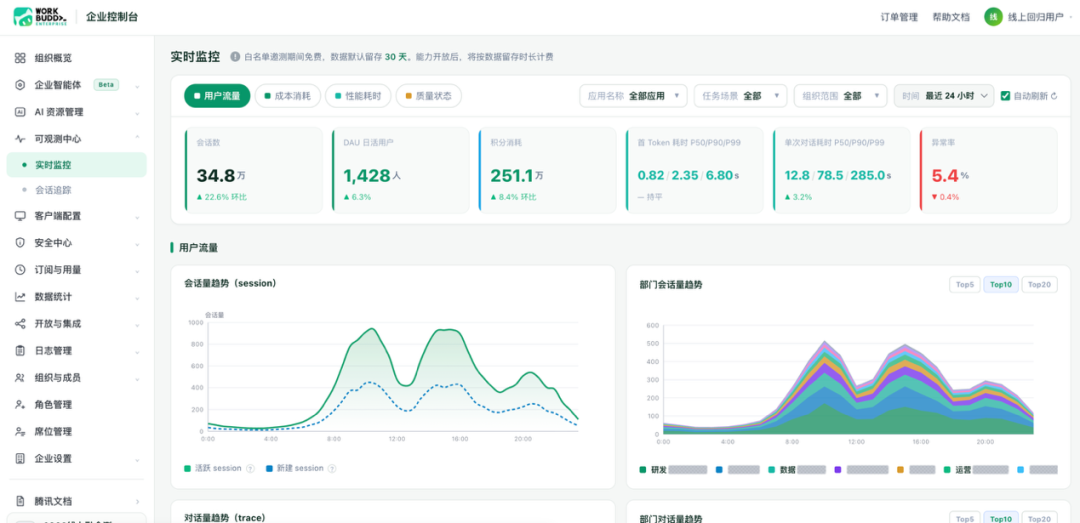
10 月 14 日,腾讯 WorkBuddy 企业版管理后台上线「可观测中心」,官方口径是让 Agent 全链路「看得全、看得清、看得透」。注意这是官方专栏发稿,当产品动态看即可。知乎
10 月 15 日,Anthropic 开发者账号宣布 Claude Platform 接入 OpenTelemetry 追踪、进入公测,覆盖 Managed Agents、Messages API 和 Claude SDK。知乎转述这篇文章的原话很准:agent 的「黑匣子」终于有标准姿势可观测;据该转述,官宣帖一小时内拿到 44 万浏览。
10 月 28 日,知乎一篇《最近面试 Agent 候选人感受》把风向说穿了:作者直言垂直领域 Agent 应用岗已经进深水区——纯 RAG、只会调框架、做过几个个人项目,已经不够看了。评论区流传的一段 JD 要求更具体:会设计有区分度的 Benchmark、建立持续评测机制、能构建从线上 badcase 归因到策略优化的数据飞轮。 马上有人追问:从业务场景到数据集构建这一整套思考链路,面试那点时间里你怎么判断?知乎
10 月 29 日,知乎《做 Agent 评测,真的需要先搭平台吗?》泼来一盆务实水:作者看过一圈评测平台后的结论是——平台做出来了,实际工作中不一定有人用;每天都用得到的反而是 Trace、日志、数据集、断言这些基础件。知乎
10 月 30 日,arXiv 上出现 TraceTrial-Bench(论文《Trial by Trace: Benchmarking AI Agent Harnesses for Reliability and Failure Attribution》),首次把底层运行框架(Harness)当独立测试对象,目标是把「模型决策错」和「执行框架错」分开归因。作者团队 TraceLite AI,代码库暂未公开。哔哩哔哩
同期还有个被大量转述的判断:知乎问题「Agent 目前最大的瓶颈是什么?」(浏览 68 万+)下一条高赞回答提到,沙箱隔离已经从「高级玩法」变成「出厂配置」,而评测和可观测仍是真空。知乎
把时间线摊开看,事情就清楚了:厂商、基准、招聘市场,半个月内同时开始说同一件事。这不是某一家在造概念。
二、老日志为什么不够用:排一个 Agent,你需要三层证据
Agent 的错误往往不在代码行,而在决策点。B 站系列课《AI 可观测性》第二集把排错需要的证据拆成三层,这个分法值得抄进你的排障手册。哔哩哔哩
Run(单步):这一次调用,模型看到什么上下文、输出什么动作、工具返回什么——单步决策的证据。
Trace(任务):一个完整任务里所有步骤串起来,看路径是否绕远、循环、提前收敛。
Thread(会话):跨轮次的记忆与状态演化,多轮交互里「它到底记住了什么」的证据。
单加一层「日志」不够,因为这三层回答的是三个不同的问题。标准化也在往前走:知乎上已有人在用 ATOF(Agent 轨迹可观测格式)的事件配对来拆工具调用的生命周期事件——轨迹先是变成可比较的数据,然后才谈得上仪表盘和归因。知乎
TraceTrial-Bench 新增的部分,是把「锅归谁」摆上了台面:同一批任务,换模型不换框架、或换框架不换模型,看故障落在哪一层。对普通开发者的实际意义是——你把 trace 接通之后,下一步该做的不是「接更多 trace」,而是开始做归因统计。当然,这篇论文的任务集和运行轨迹还没公开,「精准定位根因」目前只能是论文自己的口径,先别拿去说服老板。
三、反证检查:这轮热度里,哪些信号不能当真
做内容也做判断,先泼两瓢冷水:
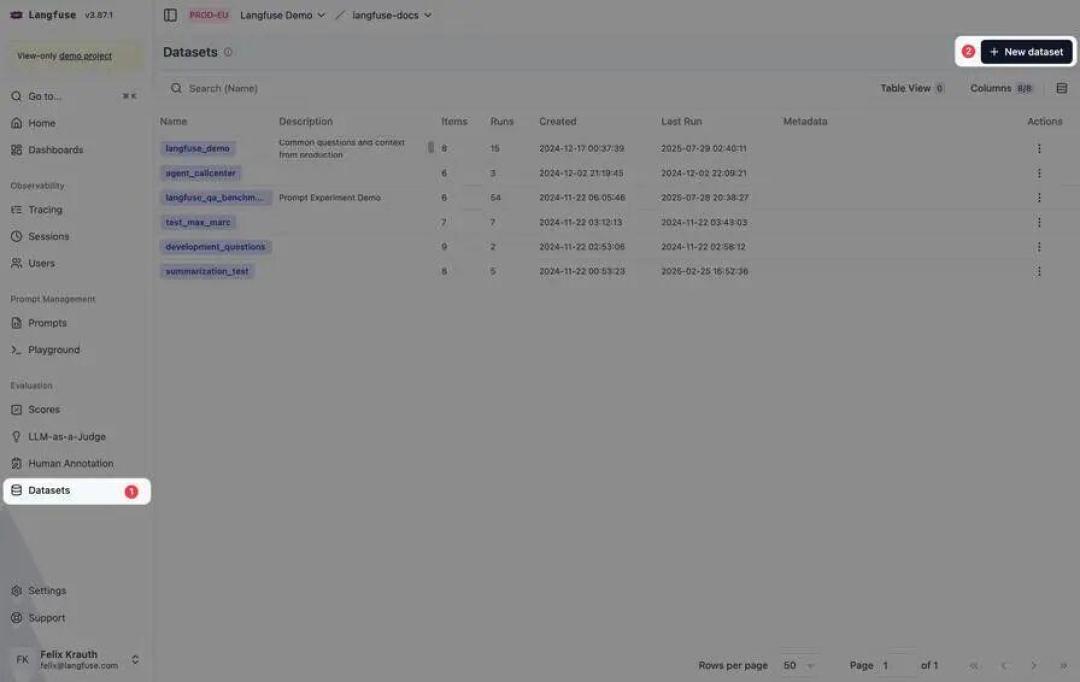
「可观测」文章里相当一部分是厂商通稿。云器科技、阿里云可观测、腾讯 WorkBuddy 官方专栏都在这波发文行列里。发稿量不等于需求量。真正能当需求信号的是消费端动作:B 站一个 Langfuse 选型部署教程,2400 播放里有 82 人收藏;B 站账号「黑马测试」的《0基础入门智能体 Agent 测试》课程累计 9.4 万播放、2397 收藏、396 条评论。 再加上前面那篇面试帖 10 条追问。用户用收藏和追问投票,比厂商 PR 可信。哔哩哔哩
「三张观测卡」这类个人实验别进你的周报。10 月 28 日知乎流传的「把黑盒变白盒」实验,对照组/实验组比的是平均调试时间、人工干预次数这些指标。 个体博主的小样本自测,方向有趣,数字不可外推。知乎
公众号侧这轮几乎是静音的。我用「Agent 可观测」「智能体 可观测」检索公众号,没有成规模的讨论。这轮热度集中在知乎问答、专栏和 B 站教程区——也就是说,它目前还是开发者圈层内部的事,还没破圈成行业叙事。
四、三类人三条最小路径:按你 Agent 的状态对号入座
一篇生产级「万级用户」问答里给过一条标准,值得贴在工位上:每一次 Agent 决策都要能回答「它当时看到了什么、为什么这么做」。完整的结构化日志和追踪是达标线,不是加分项。 但达标有成本,按状态走:知乎
还在 Demo / 课程项目阶段:别搭平台,别订全家桶。只做一件事——把每次工具调用记成结构化日志:时间戳、入参、出参、token 数、模型与框架版本。这一步不花钱,两周后的你会回来谢它。
试运行阶段(有真实用户,量不大):按 10 月 29 日那篇评测文章的优先级来——先攒三样每天用得上的基础件:Trace、断言、失败用例数据集。把线上真实轨迹转成离线回归集,改 prompt、换模型后先跑一遍再上线。平台?等这三样多到你管不动了再说。
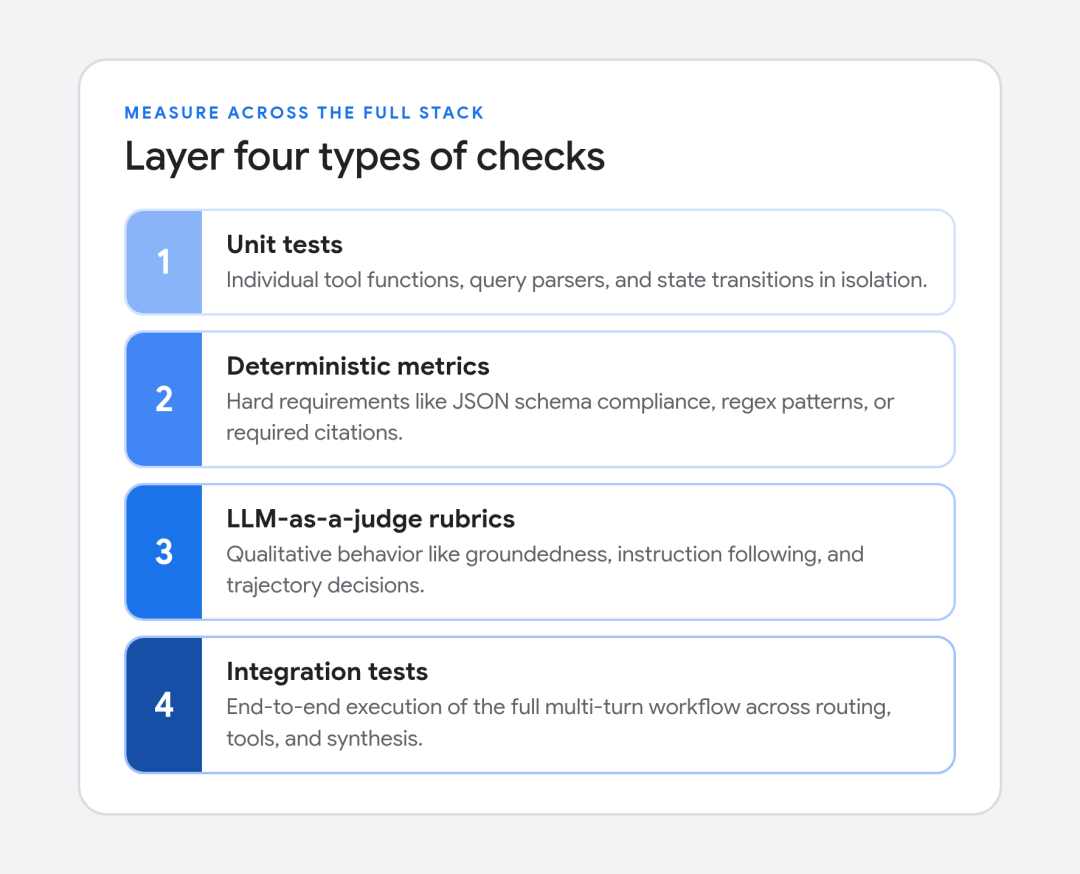
已上线、正被业务方投诉:先补归因,再谈监控大屏。用 Claude Platform 的,盯紧 OTel 公测(是否转正式、覆盖是否扩到你依赖的组件);自研栈的,先评估开源 tracing 方案把轨迹完整落下来。招聘市场的口径已经摆在那了:值钱岗要的不是「会接框架」,是「能定位错误并归因」。
接下来值得继续观察的三个信号:① TraceTrial-Bench 的全量任务、配置与轨迹是否兑现公开承诺;② Claude 的 OpenTelemetry 何时走出公测;③ 10 月 30 日 openEuler 刚宣布孵化的 AgentInsight(口号是让每一个 Agent 可被观测、可被评估)推进到什么程度。 这三件本周还都停在「宣布了但你还用不上」的状态。知乎
这个十月,模型没有突然变聪明,涨的是别的东西:工具、基准、招聘 JD 在集体补齐同一件事——把 Agent 从「跑起来了」推向「说得清」。在你换下一个模型之前,先让下一次失败可解释。