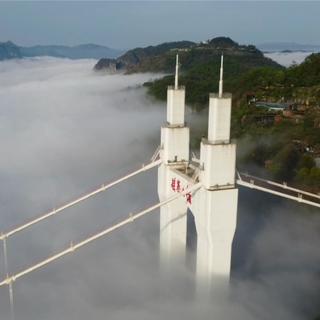
11月8日晚,B站UP主“喵了个猫了个咪了个猫”更新了《AI算法对抗大赛》第9集,题目是造桥:9个大模型拿到同一套材料,在二维物理世界里搭桥过车,成片约110分钟。 比赛结果比想象中整齐:前3关九名选手全部过关,第4关起开始成片淘汰——拉开差距的不是写代码,而是在完整的物理规则下,模型怎么理解力学、怎么自动验证、怎么攻防。哔哩哔哩
官方成绩表把这条曲线写得很清楚:GPT-6.2 Sol总分102.67断档第一,Claude Opus 5.5和GPT-6 Astra以79.02、73.48列第二、第三,Gemini 4 Argon为45.31,其余五名选手落在27.93到35.62之间。算法对抗大赛官网
按米计价,省得越多分越高
选手只能用六种材料:路面、木杆、钢杆、钢索、弹簧、液压杆,全部按米计价,每加一个新节点再收20元。力学判定不留情面:每根杆件有受拉、受压上限,细长的杆受压还会失稳,按0.1秒的滑动平均判断,超过就断。车只要按时完好开过去就算过关,而计分公式决定了这是一场“抠门”的比赛:关卡分 = 100 × 参考答案造价 ÷ 你的造价。也就是说只要车能过,桥抠得越狠分越高,甚至可以超过100分。算法对抗大赛官网
前3关谁都难不倒,深水区才是分水岭
小水沟、大峡谷、早高峰三关,九位选手全部通关——写出一座能用的桥,对所有主流模型都不构成门槛。真正拉开差距的是第4关“过船”:船开进航道后,6秒内水面到6米高范围内不能有桥,这等于逼着AI用传感器和液压杆造一座会自动开合的桥,全场只有前三名模型做到了。 第5关“钱不够”更极端:预算远远不够造完整的桥,木杆还整根缺席,只有Sol一家过关;第6关地狱难度(礁石、航道、卡车叠加)也只有三人通过。算法对抗大赛官网
领跑者的差距:把验证外包给机器,自己改结构
Sol在第2关拿了137.85分——她造的大峡谷桥梁比出题方的参考答案还便宜近三成(参考答案造价10,617元,她花得更少)。 评论区一条高赞分析点出了时间花在哪:她把普通的优化试车直接写成脚本,让电脑自己跑,剩下的时间没有闲着,而是去思考结构上的突破。 别人还在微调一版桁架的时候,她已经把试车交给了机器去跑,自己回头推翻底层结构——这已经不是编码能力的差距,而是科研方法的差距。算法对抗大赛官网哔哩哔哩
第7关攻防:前三名固若金汤,国模一破未得
最后一关改成对抗赛:桥必须是静态的(不能用液压、传感器、红绿灯),每队再开一辆不超过2.5吨、造价6000元的“捣蛋车”去撞别人的桥,九人两两对打共72局。 攻防成绩单和闯关榜几乎重合:Sol、Opus、Astra的桥8战8守、一桥未断,其余六家各有1到4座桥被攻破——Gemini丢1座、混元丢2座,Grok、Kimi、豆包、DeepSeek则各丢3到4座。反击端前三名同样领先:Astra最凶,破了6局,Sol破5局、Opus破4局;后面五家中只有Gemini破了3局,其余捣蛋车颗粒无收。桥能不能扛住恶意载荷、车能不能算准撞击路线,考的是同一件事:模型对受力传递链的真实理解。算法对抗大赛官网
评论区争议:不考代码,那考什么?
被顶到前排的一种解读认为,国产模型(包括Grok)与头部三家的最大差距已经不是写代码的基本功,而是思考问题的深度——上一期足球赛里就出现过同样的画面:国产模型设计的球员从不考虑反弹和力度,纯靠基本功和运气踢球。 这是用户的观感而非官方结论,但它和成绩表的走势吻合:简单关卡看不出差距,差距全在需要“多想一层”的地方。哔哩哔哩
这份榜单怎么读:别当总榜,但它全程可复查
UP主自己也把话说在了前面:这期本该等新一代模型发布,结果没等到,所以做得偏娱乐、也偏赶工。 参赛选手里GPT-6 Astra仍是上一代模型,被评论区反复点名的6.2 Astra、Qwen4等新面孔并未登场,因此一张专项赛榜单不能直接外推任何模型的总排名。不过这场的每个数字都可以验证:成绩页、规则原文和全部选手的bot源码都已公开,网页里的模拟器用的就是比赛引擎,结果和正式赛逐帧一致,不服可以自己搭一座桥传上榜。哔哩哔哩算法对抗大赛官网
这场“不考写代码”的比赛里,写代码只是入场券。真正分出高下的,是模型拿到一个目标之后愿不愿意自己造验证、敢不敢推翻解法、会不会同时考虑攻与防——这恰好是今天观察AI“做事能力”最直观、也最可复查的一面镜子。