

5月14日晚间,NVIDIA终于发布了期待已久的全新“安培”(Ampere)架构,又一个核弹级的GPU芯片,当然它面向的不是PC游戏市场,而是人工智能、深度学习、高性能计算、大数据等等尖端领域。
宣布新架构的同时,NVIDIA也发布了相应的第三代工作站“DGX A100”,或者按照NVIDIA的说法叫做个人超级计算机,可以支持在桌面端进行AI研究,并扩展到云端。


DGX A100内部配备了八颗安培架构的Tesla A100 GPU,每一颗整合40GB HBM2高带宽显存,总容量达320GB。
每颗GPU均支持多达12路的NVLink互连总线,GPU-GPU带宽高达600GB/s,可保证八颗GPU彼此完全互连,同时还有6颗NVIDIA NVSwitch芯片,双向带宽高达4.8TB/s。
不过从示意图上可以看出,每颗GPU周围其实有六颗HBM2显存芯片,很显然有一颗没有启用,剩下的五颗单颗容量8GB从而组成40GB。这意味着,A100核心现在应该也是屏蔽了六分之一的规模。


网络方面配备了刚完成收购的Mellanox的解决方案,包括八颗单端口ConnectX-6 VPI用于聚类,峰值性能200GB/s,以及一颗双端口ConnectX-6 VPI用于数据与存储网络。

有趣的是,搭配的CPU处理器这次抛弃了Intel至强,改而使用两颗AMD二代霄龙(Rome),且是*级的64核心型号,同时搭配1TB DDR4内存、15TB PCIe 4.0 NVMe SSD固态硬盘。

黄仁勋称这是“世界上最大的显卡”,不算外壳单单是其中的计算板加散热器就有45斤的重量,集成超过3万个不同组件,钻孔数量多达100万个,连接电路长达1公里。


NVIDIA宣称,DGX A100系统单节点的峰值性能为:INT8 10 PetaOPS(每秒1亿亿次整数运算)、FP16 5 PFlops(每秒5千万亿次半精度浮点运算)、FP32 2.5 PFlops(每秒2.5千万亿次单精度浮点运算)、FP64 156 TFlops(每秒156万亿次双精度浮点运算)。
相比于高端CPU服务器,它的AI计算性能要高出150倍,内存带宽高出40倍,IO带宽也高出40倍。


NVIDIA DGX A100个人超算现已上市,售价19.9万美元,约合人民币141万元。
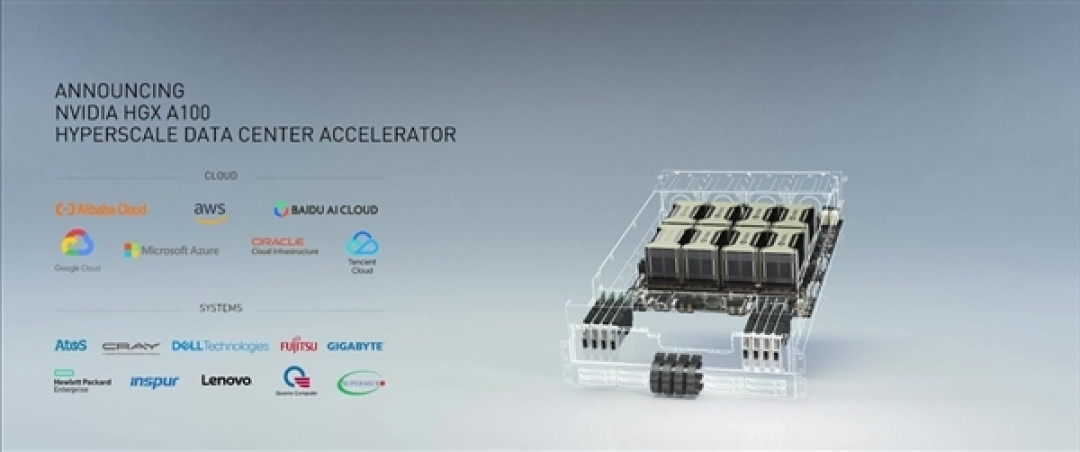
该方案的云服务客户有阿里云、亚马逊AWS、百度云、Google Cloud、微软Azure、甲骨文、腾讯云,系统级客户有AtoS、Cray、戴尔、富士通、技嘉、HPE、浪潮、联想、广达、SuperMicro。


没有购买链接啊
图2里老黄是放在燃气灶下面了吗
个人超算。。。
老黄:AMD Yes!
机柜上面放一排灶头是几个意思?
没劲,扫雷很卡。
这个玩扫雷,能冲到2k144吗?
真划算,上一代8卡v100也要差不多的价格。


我就想知道这个级别的设备卖咱们吗?
为什么没放个购买链接。。。。。。
地球模拟器(Earth Simulator)是日本于2002年3月15日开始运作的矢量型超级计算机,运算性能达到了35.61 TFLOPS,开发费用总计达羊400亿日元即$3.57亿美金,2002.06 - 2004.11为排名世界第一的超级计算机。DGX-A100的64位运算性能达到了156 TFlops,售价19.9万美元。如果按照同等运算性能做比较,单位运算成本在过去的15年间降低了1万倍。科技的进步速度真是令人叹为观止。
总有一天会变成手机大小
天河二号的计算性能是这个的217倍,只需要花144万*217=3.19亿就可以实现天河二号的性能,这个体积却这么小,科技真的是日益月新啊。
10年后捡垃圾?
amd,yes!
可能20年后ARM大小的芯片也能达到这样的运算能力。
买去做钢铁侠吗

3台苹果价格
各大科研机构可以开始考虑预算了,现在不管是有限元计算,深度学习或者是一些量化计算已经引入gpu加速,计算量,计算能力的增加对于一些高精度,大面积的模拟计算式必须的
一班和二班的人都玩不起这东西……就更别提值不值了😂