清华大学与东北大学联合推出DeepDive,通过知识图谱数据合成与多轮强化学习,显著提升深度搜索Agent的长程推理能力,为开源模型缩小与专有模型差距提供新路径。
 智能速览
DeepDive结合知识图谱自动合成高难度训练数据
端到端多轮RL提升模型工具使用效率
BrowseComp测试准确率达14.8%,验证方法有效性
开源数据集助力GLM-4.5系列模型性能提升
提出半自动i.i.d.数据合成技术可进一步提升准确率至22.2%
 精华内容
深度搜索Agent需处理数百个在线资源,但开源模型与专有模型存在显著差距。DeepDive通过创新的数据构建和训练方法,为这一难题提供系统性解决方案。
数据创新
传统问答数据集难以反映真实复杂场景。DeepDive利用知识图谱的结构化特性,通过随机游走生成多跳路径,并刻意模糊实体属性创造"模糊实体"。再结合LLM混淆关键线索,构建出极具挑战性的深度搜索问答对。这种自动化数据合成方法,有效激发模型的长程推理能力。
知识图谱天然支持多跳连接,为深度搜索训练提供理想基础。研究团队通过在知识图谱上执行随机游走,自动构建深度搜索问答对,确保数据既具挑战性又符合真实场景需求。
训练突破
DeepDive采用端到端多轮RL技术,整合推理与搜索工具使用。通过多轮GRPO算法,让模型在网络环境中交互学习,根据最终答案获取奖励。实验表明,RL训练显著提升模型工具使用效率,测试时工具调用和并行采样扩展效果明显。
为确保训练质量,研究引入提前退出机制:当模型出现格式错误时立即终止并赋予0分奖励。这种设计保证所有正向奖励轨迹既无错误又可靠,大幅增强多轮工具使用的鲁棒性。
性能验证
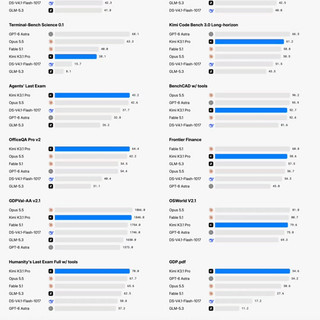
在BrowseComp等4个深度搜索基准测试中,DeepDive-32B取得14.8%准确率,优于开源模型和部分专有模型。更值得注意的是,仅使用半自动i.i.d.数据合成技术,准确率可提升至22.2%。
研究还发现,模型性能随工具调用预算和并行采样增加而提升,且复杂问题解决技能可迁移到简单场景。这些数据证实了DeepDive方法的有效性和泛化能力。
开源贡献
研究团队已开源所有DeepDive数据集、模型和代码,为社区提供完整解决方案。这些资源帮助GLM-4.5系列开源模型在BrowseComp测试中取得出色表现。
开源内容包括知识图谱自动化问答数据合成方法、多轮RL训练框架以及半自动i.i.d.数据合成技术。这种全面开源将推动深度搜索Agent领域的快速发展。
局限展望
DeepDive仍存在一些局限。自动合成数据的难度低于真实BrowseComp数据集,导致DeepDive-32B性能仍低于o3等先进模型。同时,高难度数据训练引发"过度搜索"现象。
未来研究将探索最优训练步骤和更合适的奖励机制。这些改进有望进一步提升深度搜索Agent的性能,缩小与专有模型的差距。
DeepDive通过创新的数据构建和训练方法,为深度搜索Agent发展提供新思路。开源的完整方案将推动技术普及,但如何平衡数据难度与模型实用性仍是重要课题。