这周本地部署圈打了两场架,看起来不相干,其实是同一件事。
第一场:B站一条 Cloud Codes 的翻译视频直接开炮,说"网上每一张’哪款模型适合你的GPU’的图表都犯了同一个错误——只计算模型权重"。它的论点是:显存里除了权重,还要住对话历史的 KV Cache 和运算用的暂存区,“权重塞得满满当当的系统,能加载,但写不了代码”。哔哩哔哩
第二场:玩客笔记用一张千元级的 RTX 3060 12G,跑起了 Bonsai 2 27B——基于 Qwen3.8-27B 重新打包的三值量化模型——实测 33 tokens/s,视频留下 49 条评论。三天后另一条"打假"视频跟进,质疑 PrismML 官方宣传的"达到 fp16 全精度的 98%"。哔哩哔哩哔哩哔哩
一边说对照表都算错了,一边说 12G 卡真能跑 27B。说法打架,数据其实不打架——因为两边指向的是同一笔隐藏账。
一、显存里住着三个房客,对照表只算了房东
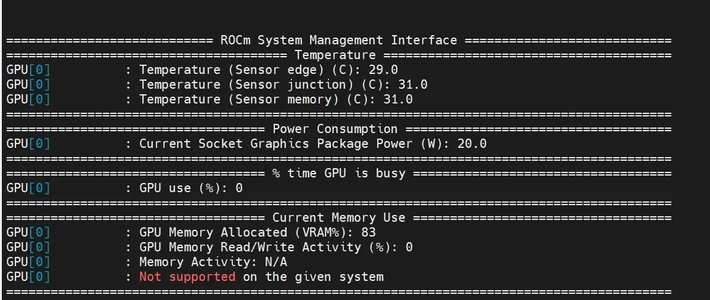
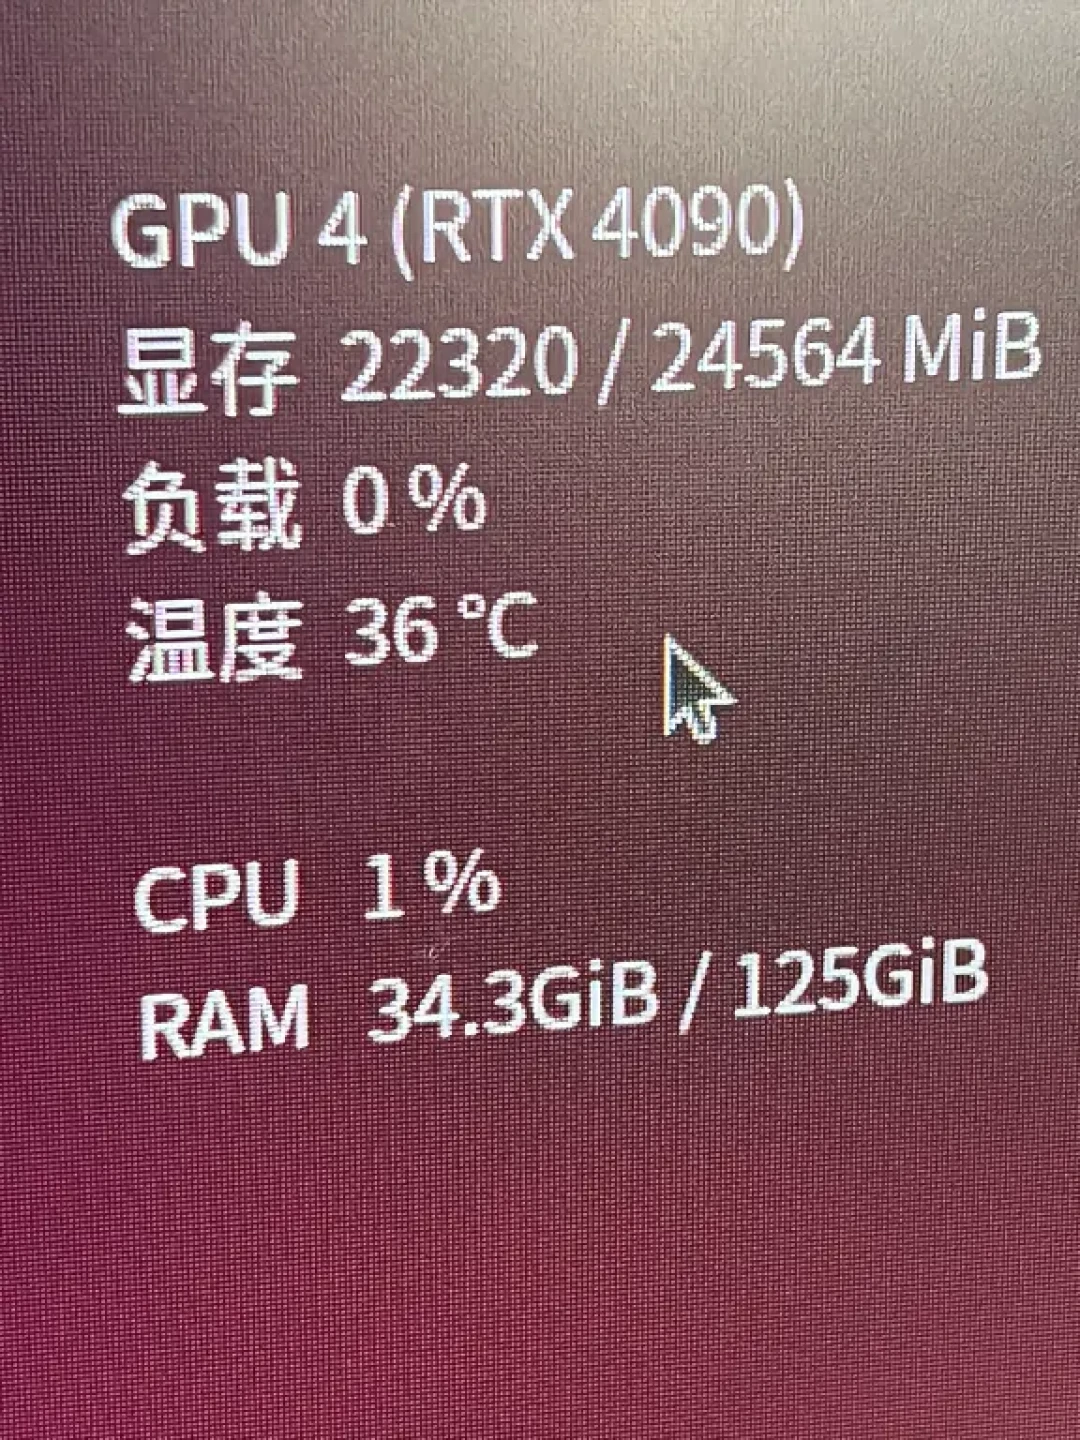
先看那场 12G 实测。Bonsai 2 27B 的 PQ2_0 量化语言模型本体 7.21GB,加上 0.63GB 视觉投影器,一共不到 8GB——12G 卡理应还剩 4GB 富余,对吧?但实测显存快照是 10.78GB,占用率 88%。哔哩哔哩
消失的 3.5GB 去哪了?两个去处。
一个是 KV Cache。大模型没有记忆,每轮对话客户端都会把全部历史重发一遍,显卡里缓存的 K/V 矩阵就是你看到的"它还记得"。B站今天有一条科普视频算了笔粗账:按 fp16 精度,每个 token 的 KV 约占 320KB,3 万字上下文要吃掉约 10GB——这个数字随模型架构和 KV 精度浮动很大,用 Q8_0 或 Q4_0 的 KV Cache 能减半再减半,但永远不会是零。对话越长、喂的文件越多,这部分就线性膨胀。哔哩哔哩
另一个是运行时暂存:运算的中间缓冲、并发批处理的预留,相当于厨房除了食材还得有操作台。
玩客笔记那次测试是带着 128K 上下文配置(-c 131072)和 Q4_0 KV Cache 启动的,所以 10.78GB 是"权重+KV+暂存"整体预算的结果,不是权重突然膨胀了。
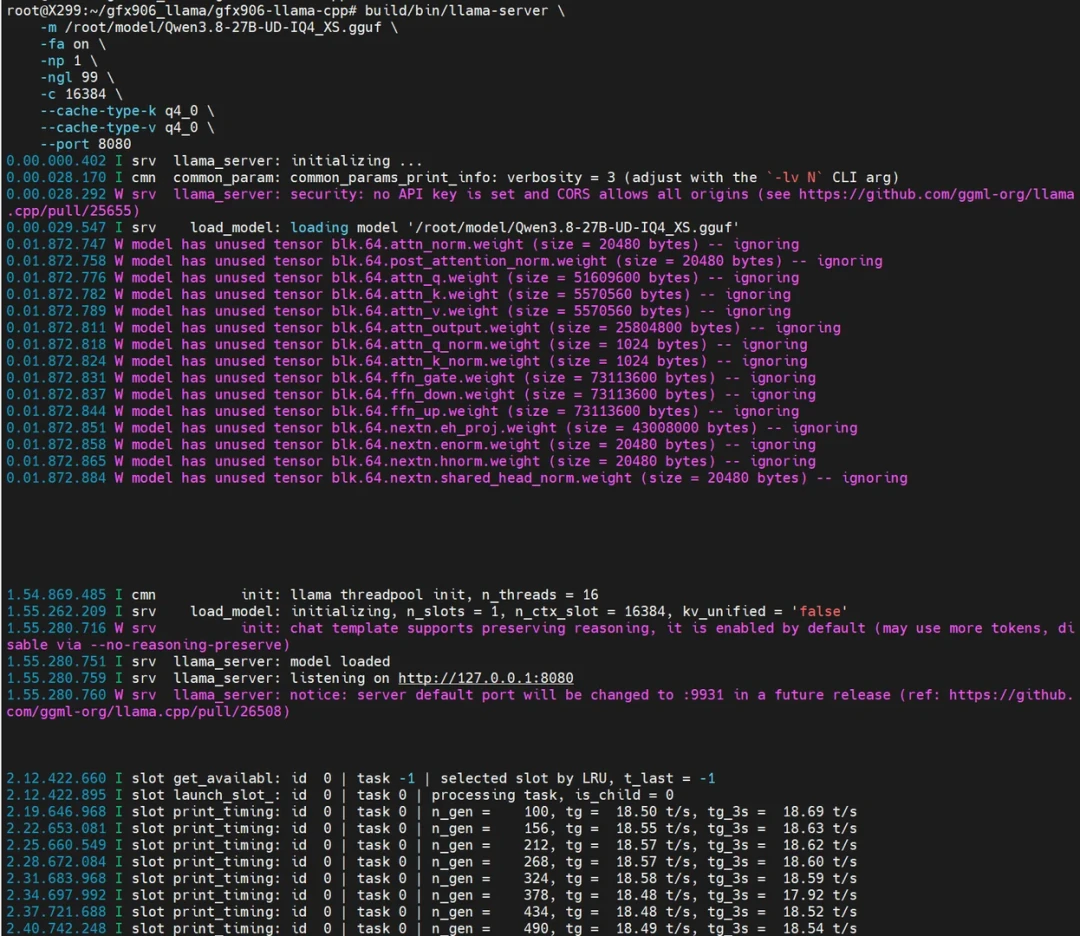
再对照小红书一位用户 9 月 23 日的实测:16G 显存跑 Qwen3.8-27B 的 UD-IQ4-XS 量化,权重 13.3GB,速度 18 token/s,自评"属于个人能用的水平"。留给 KV 和暂存的只有 2.7GB 左右——能聊天,但长对话或喂几份文件就会顶到天花板。小红书
所以第一个结论:对照表里的"XX GB 显存可跑 XX 模型",算的是权重装不装得下;你的实际体验,取决于权重之外还剩多少。
二、"装得下"有三层:能加载、能聊天、能干活
Cloud Codes 那条视频里有个值得抄下来的判断:能装下是规格,有帮助才是检验。拆开看其实是三层:
能加载:权重进显存,启动不报错。
能聊天:还能留下几千 token 给 KV Cache,日常对话、短篇翻译总结够用。
能干活:跑 Agent、多文件代码重构、本地测试套件——上下文动辄几万 token,还要给恢复循环留暂存。这一层最吃显存,也最容易被对照表忽略。
知乎一位用 8G 显存 + 16G 内存机器的用户,测完一批模型的结论很佐证这一点:Qwen3.5 9B Q4 能跑 65 t/s 以上,Ornith 1.5 9B Q4 带 65K 上下文同样 65 t/s 以上,“暂时最好用”;而 Bonsai 2 27B 他给的评语是"速度有点慢,等大佬继续优化工具链"。装得下不等于用得爽,小显存卡上,一个高质量 9B 往往比硬塞进去的 27B 更干活。知乎
说到硬塞,就回到第二场架:极端量化的利息到底怎么算。
PrismML 官方宣传 Bonsai 2 保持 fp16 的 98%。玩客笔记用 102 样本 EvalScope 盲测给出了更立体的答案:中文日常对话(C-Eval)85%,与原版 Qwen3.8 27B Q4 完全持平;指令遵循(IFEval)和代码(Live-Code-Bench)小幅下滑;通识理解(MMLU-Pro)下滑约 20%,综合能力回落到原版 Q3 量化的水平。哔哩哔哩
翻译一下:聊天基本无损,干活打折,而且折价恰好集中在"能干活"那一层。98% 这个数不是凭空捏的,但它大概率只在某些基准上成立。你用 12G 显存换来 27B 的能力,付出的是 Agent 用户最在意的那部分。宣传方和打假方,各对了一半。
还有一个反直觉点值得记住:Cloud Codes 建议 12G 卡用户提高精度(小模型跑 8-bit)而不是一味加大模型——更大模型的指令遵循和长上下文会先在小显存上崩掉。这和上面那位知乎用户的实测结论互为印证。
三、2026 年的显存档位:你在哪一层
把 linuxdo 9 月 19 日的选卡视频、Cloud Codes 的档位表和散落各处的社区实测拼在一起,目前的档位格局大致是这样。注意:这是跑 LLM(对话/代码)的选卡逻辑,MiniMax H3 这类 AI 视频生成完全是另一套账,不要套用本表。哔哩哔哩
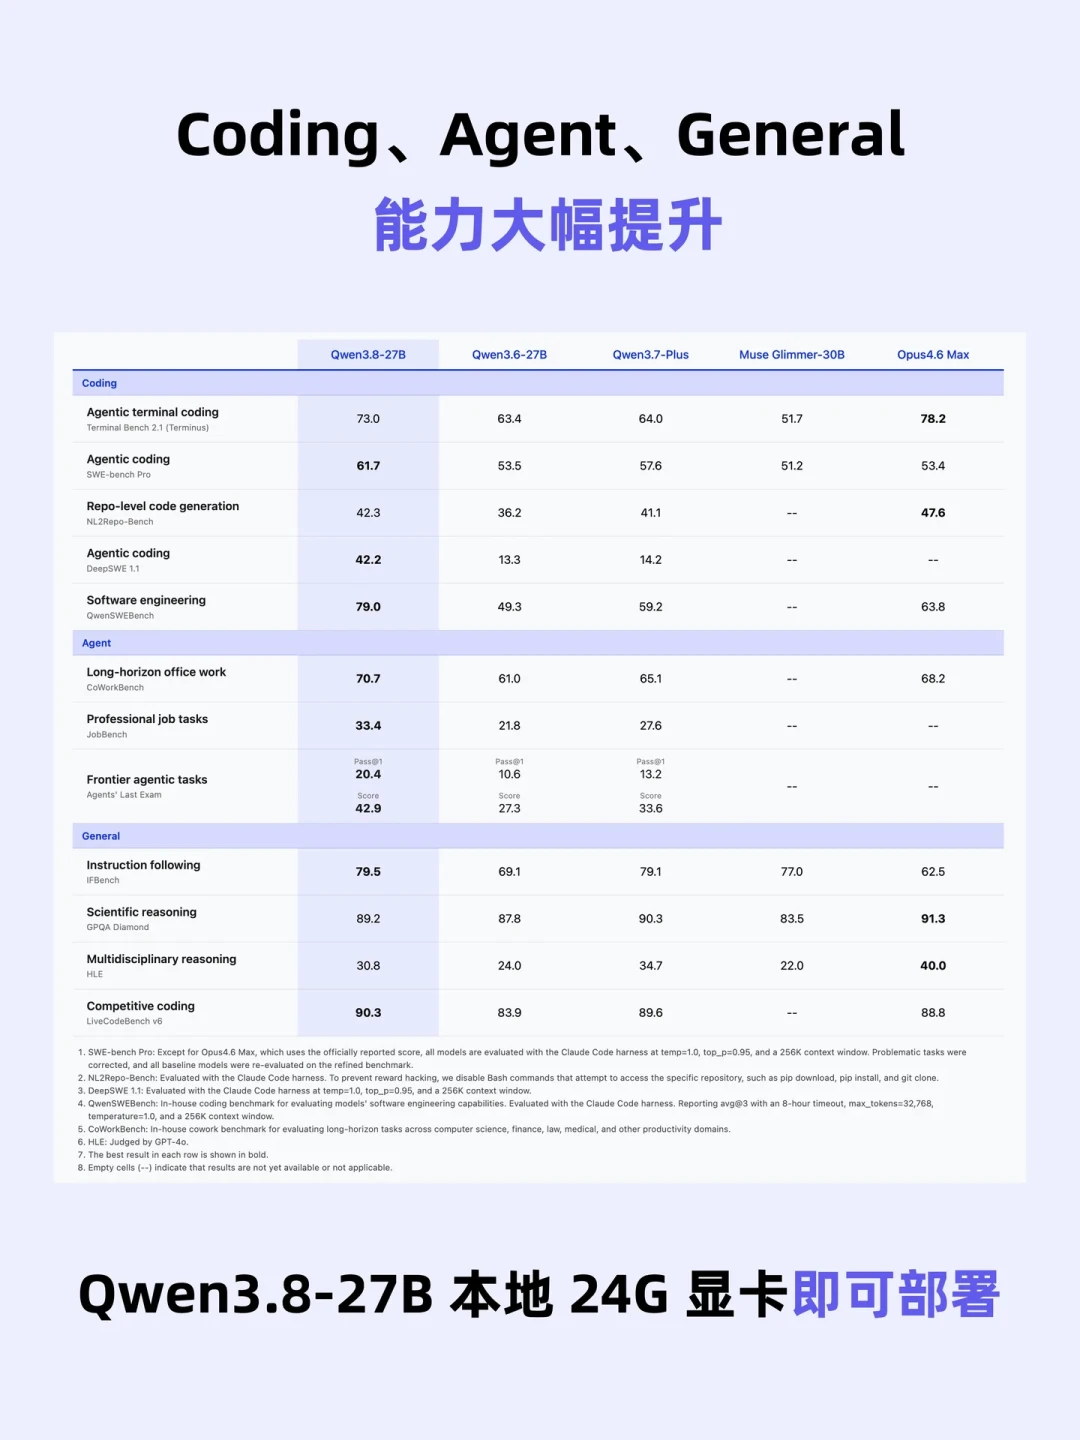
4–8GB:4B–9B 量化的世界。Spark X2.5、NeoHorse 管单文件修改,Ornith 1.5 9B 能带来入门级结对编程。这一档不要惦记 27B,装得下也只是摆拍。
12GB:分水岭。降档路线是 Bonsai 2 27B(PQ2_0,33 t/s,通识打折);质感路线是 9B 级高精度 + 长上下文。聊天选前者,干活反而选后者。
16GB:Qwen3.8-27B 的 IQ4-XS(13.3GB)能跑到 18 t/s 的"能用"水平,但上下文紧巴巴;27B 的 GSQ-RCO 非均匀量化(ISTA-DASLab 的方案,Cloud Codes 评价"压进 12GB 以内、匹配全精度得分")值得盯,目前社区样本还少。
24GB(RTX 3090 / 7900 XTX):甜蜜点起步。27B Q4 从容,能留出几万 token 的上下文。linuxdo 博主自己的方案是 7000 元二手 7900 XTX + X99,专门跑 Qwen3.8-27B。哔哩哔哩
32GB(R9700 / 4080 Super 魔改):27B 长上下文或 35B MoE 的门票。魔改卡的价格优势,对应的是风险自担的售后和稳定性。
48GB 及以上(W7900 / 4090 魔改 48G / RTX PRO 5000):真正"让 Agent 打工"的入场券,80B 级的 Qwen3-Coder-Next 从这里开始有意义。注意 PCIe 卸载瓶颈——显存够但总线互联不够,速度照样崩。
96GB+(RTX PRO 6000)与 Mac 统一内存:前沿档。一个可算的锚点:RTX PRO 5500(84GB)如果定价超过 5250 美元,每 GB 显存成本就比 5090 首发价贵。Mac 这边,海外实测 M5 Max 跑 Qwen 能到 144 t/s——统一内存的优势是容量大什么都装得下,劣势是带宽决定速度上限。哔哩哔哩哔哩哔哩
垃圾佬路线:4 张 Tesla T10 拼 64GB、二手 V100 方案都有人做成,便宜是真便宜,但功耗、散热和生态成本是分期付的。
四、买卡前的三步自查
先写下你的真实上下文需求。不是"我想跑多大的模型",而是"我平时聊多少轮、喂多大的文件、跑不跑 Agent"。按 fp16 KV 每万 token 约 3GB 的量级估(Q8_0/Q4_0 KV 减半再减半),这是权重之外的第一笔固定开销。
显存预算按"权重 × 1.4"估,别按"权重 × 1"估。Bonsai 2 的案例里,7.8GB 的权重实际占了 10.78GB,比例约 1.38。宁可留余量,不要卡着上限买——88% 的显存快照,是 OOM 前最后的体面。
对"保持 XX% 性能"的宣传,只看分层基准。聊天类(C-Eval)、通识类(MMLU-Pro)、代码/Agent 类各掉了多少,三个数都硬才叫无损,只有一个数硬那是海报。
最后留三个继续观察的信号:RTX PRO 5500 的正式定价,决定大显存工作站这条路线值不值;Qwen4 的开源节奏——如果你已经为 3.8 囤了一堆变体,先别急着清硬盘;以及 Bonsai 2 工具链的优化进度,PrismML 那个专用 llama.cpp fork,社区眼下的共识是"等大佬优化"。
对照表给的是标准答案,但你得先知道自己要解什么题。权重决定你进不进得去门,KV Cache 和暂存区决定你能在里面待多久。